📄 升级了!泰语文档 AI,两款模型免费开源
2.1 版发布于 2026 年 11 月 18 日 · 2.0 版发布于 2026 年 11 月 12 日
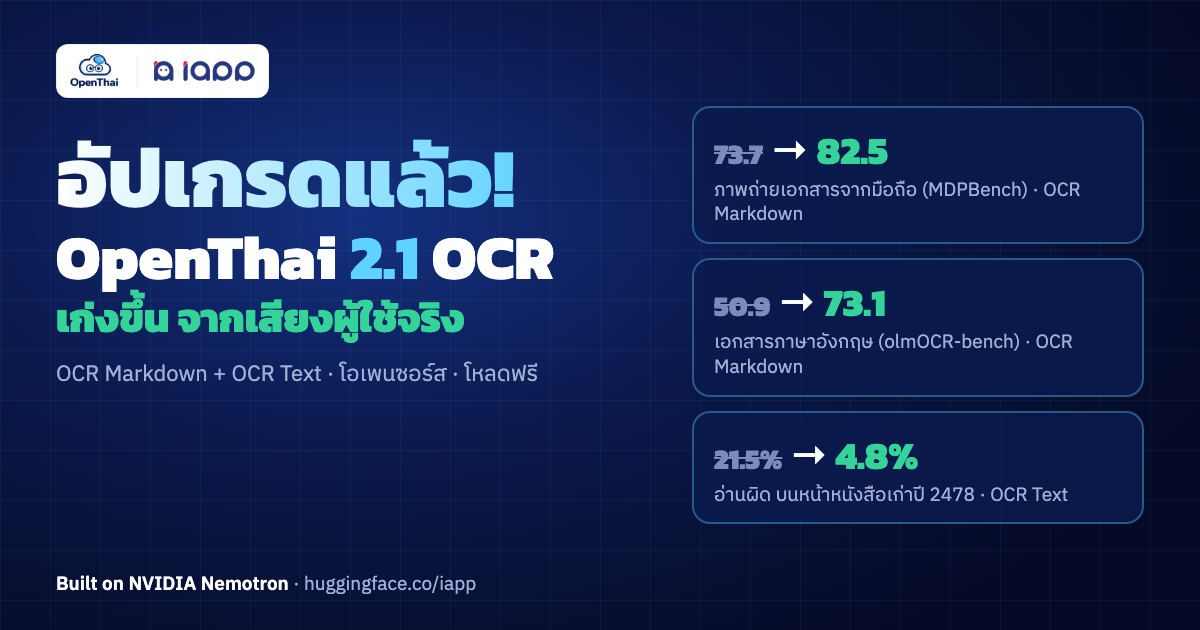
OCR Markdown 0.63BOCR Text 6.6 MB允许商用泰语 + 英语v2.1
是否遇到过这种情况? 扫描了一叠政府文件,或用手机拍下一份文档,想要其中的文字,OCR 却把表格读成一长行,分不清哪个数字属于哪一行,最后只好一格一格重新录入。
iApp Technology 的 OpenThai 团队开源两款泰语 OCR 模型,任何人都可以免费下载使用,也允许商用。2.1 版大幅提升了对手机拍摄文档的识别,并修复了 2.0 发布后用户反馈的问题(2.1 有哪些新内容)。
| OpenThai 2.1 OCR Markdown | OpenThai 2.1 OCR Text | |
|---|---|---|
| 功能 | 页面或文档照片 → Markdown,表格为 HTML(支持合并单元格),公式为 LaTeX,每个区块带边框与类别 | 页面 → 按阅读顺序的文本,每行带边框与置信度 |
| 规模 | 0.63B 参数 | 1.60M 参数,ONNX 文件共 6.6 MB(检测器 1.8 MB、识别器 2.4 MB,以及用于无头字体的第二识别器 2.4 MB) |
| 运行环境 | 单张 NVIDIA GPU,使用 vLLM 部署;或通过 llama.cpp(GGUF)在 Mac 与 CPU 上运行 | 仅需 CPU,无需 GPU |
| 速度 | H100 上每页 1.5 秒;Apple M3 Max 上约每页 6 秒(GGUF) | 每页 0.39 秒;8 核约每分钟 950 页 |
| 基础模型 | NVIDIA Nemotron 3.5 Parse | PaddlePaddle PP-OCRv6-tiny |
| 许可证 | OpenMDW-1.1 | Apache-2.0 |
| 适用场景 | 含表格的文档、文档照片、论文与幻灯片、为 RAG 准备文档 | 大批量纯文本、无 GPU 的机器、不能离开本地的机密文件 |
1) OpenThai 2.1 OCR Markdown:表格仍是表格,手机照片也能读
把泰语与英语文档页面读成 Markdown,表格输出为带 rowspan 与 colspan 的 HTML。它是在 NVIDIA Nemotron 3.5 Parse(0.63B)基础上的全量微调,因此保留 Parse 的版面框、区块类别与阅读顺序,凡能运行 Parse 的地方都能运行它。
2.1 新内容
- 手机拍摄的文档照片,包括弯曲、折痕和阴影:MDPBench(泰语与英语,以照片为主)从 73.7 提升到 82.5;仅泰语从 72.7 提升到 80.7。
- 新增 9 类页面: 学术论文、书籍、漫画、试卷、杂志、报纸、报告、幻灯片和教科书,泰语与英语。英文 PDF(olmOCR-bench)从 50.9 提升到 73.1;OmniDocBench v1.6 从 61.8 提升到 79.6。
- 公式输出为 LaTeX。 页眉页脚不再混入 Markdown,空白页不再生成虚构文字,ำ 写成单个字符。
- 泰国政府文件表格依旧准确: th-docs-tables v1 得分 94.0(2.0 为 95.2,差异不显著),Typhoon OCR V2 2B 为 91.6。
- 规模与速度不变: 单张 NVIDIA H100 每页 1.5 秒。
- 新增:用于 llama.cpp 的 GGUF 文件。 无需 vLLM 即可在 Mac 或 CPU 上运行,Apple M3 Max(Metal)上约每页 6 秒;在全部 30 页测试页上,其 Markdown 与原模型完全一致。
不想自己维护 GPU?iApp 的 OCR Markdown API 已升级到 2.1,每页 0.15 ICiapp.co.th/docs/ocr/document-markdown
| 模型 | th-docs-tables v1(65 页) | ThaiOCRBench 表格(193 张) | 泰语印刷文本(12 个数据集) | MDPBench 泰英(320 页) | MDPBench 泰语 | olmOCR-bench | OmniDocBench v1.6 | 每页秒数 |
|---|---|---|---|---|---|---|---|---|
| OpenThai2.1-OCR-Markdown | 94.0 | 69.5 | 90.2 | 82.5 | 80.7 | 73.1 | 79.6 | 1.5 |
| OpenThai2.0-OCR-Markdown | 95.2 | 68.9 | 90.3 | 73.7 | 72.7 | 50.9 | 61.8 | 1.5 |
| Nemotron 3.5 Parse(基础模型) | 91.3 | 68.3 | 89.0 | 79.6 | 77.4 | 62.4 | 80.1 | 1.8 |
| Typhoon OCR V2 2B | 91.6 | 67.6 | 89.6 | 87.0 | 85.0 | 84.7 | 91.5 | 1.0 |
粗体为各列最佳(每页秒数为最快)。与 Typhoon OCR V2 2B 的配对 95% 区间:th-docs-tables 领先 +2.3 [+0.4, +4.8];ThaiOCRBench 表格与泰语文本差异不显著;MDPBench 落后 4.5 [−7.0, −2.0],主要在照片及照片中的表格;olmOCR-bench 与 OmniDocBench 落后约 12 分,主要在公式。MDPBench 未计入公式指标(CDM)。2.0 页面上的新皇家公报数据集尚未为 2.1 重新测量。全部细节见模型卡。
使用方法
与基础模型一样用 vLLM 部署,再用模型自带的 nemotron_parse 包中 NVIDIA 的 DocumentParser 解析页面(边框与类别模式,单次处理)。vLLM 运行在 Linux 上;Windows 请在 WSL2 中使用。
hf download iapp/OpenThai2.1-OCR-Markdown-20261118 --local-dir OpenThai2.1-OCR-Markdown
pip install -e "./OpenThai2.1-OCR-Markdown[vllm,client]"
vllm serve ./OpenThai2.1-OCR-Markdown --served-model-name nemotron-parse --trust-remote-code
from nemotron_parse.inference import DocumentParser, GenerationError

with DocumentParser(base_url="http://localhost:8000/v1", model="nemotron-parse") as parser:
    doc = parser.parse("page.png", mode="single")
    print(doc["markdown"])  # Markdown;表格为带 rowspan/colspan 的 HTML;公式为 $$...$$
- 想要 2.0 的输出格式?(Markdown 中保留页眉页脚,公式为
\(...\))可用PostprocessOptions设置,见模型卡。 - 在 Mac 或 CPU 上: 使用 GGUF 文件与我们的 llama.cpp 分支(iapp-technology/llama.cpp,分支
nemotron-parse)。上游 llama.cpp 尚不支持此架构。 - 分步指南(Windows、Mac 与 Linux,附读取图片和 PDF 的脚本):见 iApp 博客。指南为 2.0 编写,同样适用于 2.1,只需改用新的模型名称。
2) OpenThai 2.1 OCR Text:6.6 MB,无需 GPU
在普通 CPU 上运行的泰语与英语印刷文本 OCR:PP-OCRv6-tiny 行检测器(1.8 MB)加上 iApp 训练的泰语行识别器(2.4 MB),使用 OpenVINO 或 ONNX Runtime 运行。它是 iApp Document OCR 背后的引擎。
2.1 新内容(沿用 2.0 的模型文件,新的运行时,以及用于无头字体的第二识别器)
- 声调符号悬浮的旧书 不再丢失声调符号:在用户发来的一页 1935 年旧书测试页上,错误率从 21.5% 降到 4.8%(单页测试,不是基准测试)。
- 无头字体(Kanit、Prompt、Sukhumvit Set)不再被读成拉丁字母。
- 两栏和三栏页面 按栏读取;列表和表格仍按行读取。
- 表格单元格中的单个数字或字母 不再丢失;用逗号表示小数的金额(如 "280,00")输出为 "280.00"。
- Mac 与 Windows 上内存占用更少。
- 12 个印刷数据集平均从 87.8 提升到 88.3,ThaiOCRBench 整页从 82.0 提升到 84.1。
- 速度不变: 每页 0.39 秒,可离线运行,机密文件无需离开本机。
这些修复大多来自真实用户:Facebook 上的评论,以及 GitHub 上基于该模型的项目。谢谢大家。
所有引擎读取相同页面、以相同方式评分:字符准确率 100 × (1 − CER),越高越好。
| 引擎 | 12 个印刷数据集平均 | 法院判决 | 皇家公报 | 预算文件 | 古籍 | ThaiOCRBench | 手写 |
|---|---|---|---|---|---|---|---|
| OpenThai2.1-OCR-Text(v2.1.1,CPU) | 88.2 | 97.0 | 96.3 | 99.6 | 78.8 | 83.8 | 10.3 |
| OpenThai2.0-OCR-Text(v2.0.0,CPU) | 87.8 | 97.0 | 96.3 | 99.5 | 77.1 | 82.0 | 10.3 |
| OpenThai2.0-OCR-Markdown(GPU) | 90.3 | 96.2 | 98.0 | 98.2 | 79.7 | 90.6 | 78.9 |
| Typhoon OCR V2 2B | 89.6 | 96.2 | 94.6 | 97.3 | 77.2 | 87.3 | 76.7 |
| NVIDIA Nemotron 3.5 Parse | 89.0 | 96.9 | 92.2 | 98.9 | 76.9 | 92.0 | 57.3 |
| Typhoon OCR 1.5 2B | 87.5 | 92.4 | 92.5 | 97.2 | 78.6 | 71.4 | 94.5 |
| Gemini 2.5 Flash | 87.1 | 94.7 | 92.6 | 81.0 | 77.9 | 88.8 | 86.7 |
| dots.mocr | 86.4 | 96.3 | 93.1 | 99.5 | 76.3 | 78.8 | 39.4 |
| OneOCR(Microsoft,Windows) | 85.0 | 95.1 | 96.6 | 99.8 | 78.6 | 81.8 | 91.0 |
| Google Cloud Vision | 83.6 | 93.9 | 87.8 | 75.0 | 73.6 | 85.6 | 60.8 |
| PaddleOCR 3 PP-OCRv5 (th) | 81.1 | 90.4 | 82.9 | 93.1 | 55.5 | 75.8 | 41.6 |
| Qwen3.5-9B | 80.1 | 34.5 | 88.2 | 91.8 | 68.5 | 82.0 | 54.1 |
| Tesseract 5 (tha+eng) | 75.4 | 71.7 | 82.3 | 71.3 | 52.2 | 75.0 | 26.4 |
| PaddleOCR-VL 1.6 | 72.4 | 80.8 | 79.7 | 70.3 | 57.6 | 68.2 | 13.4 |
| DeepSeek-OCR-2 | 69.0 | 92.8 | 84.7 | 91.4 | 55.2 | 77.5 | 3.9 |
粗体为各列最佳。2.1 一行为 v2.1.1 的结果,与模型卡一致;最新版本 v2.1.4 的 12 个数据集平均为 88.3,ThaiOCRBench 为 84.1。平均涵盖 12 个印刷数据集(预算文件、皇家公报、SEA-DocBench、维基文库古籍、行政法院判决、ThaiOCRBench、th-docs-tables 以及 3 个 OCR104 数据集),不含手写。完整表格及各引擎速度见模型卡。法院判决属于训练域内:训练数据包含其他法院文件。
使用方法
hf download iapp/OpenThai2.1-OCR-Text-20261118 --local-dir OpenThai2.1-OCR-Text
pip install -r OpenThai2.1-OCR-Text/requirements.txt
cd OpenThai2.1-OCR-Text
from runtime.line_engine import LineOCR

ocr = LineOCR(".", threads=1)
r = ocr.read("page.png")      # 路径、bytes、ndarray 或 PIL 图像
print(r["text"])              # 按阅读顺序的文本(逐栏输出)
r["lines"]                    # [{"text", "confidence", "row", "box"}]
如需高吞吐量,请每个 CPU 核运行一个 worker 进程,并设置 threads=1。
🔁 正在使用 2.0?
- 旧链接和旧模型名称仍然可用(
iapp/OpenThai2.0-OCR-Markdown与iapp/OpenThai2.0-OCR-Text)。Hugging Face 会自动跳转到新名称,下载到的是 2.1。 - 想保留旧版本,下载时传入
revision="v2.0.0"。 - 为避免更新悄悄改变输出,可固定
revision="v2.1.0"(OCR Markdown)或revision="v2.1.4"(OCR Text)。
🤔 为什么免费开源
泰国政府机构、医院和企业中还有数以百万计的文档页面不能上传到境外云端。我们希望每个机构都能在自己的机器上读取它们。而任何想用自家文档搭建 AI 聊天机器人的人,第一步都是把文档读对。
⚠️ 坦白说:尚不擅长的地方
- 手机照片、英文页面和公式: Typhoon OCR V2 2B 仍然领先(MDPBench 87.0、olmOCR-bench 84.7、OmniDocBench 91.5)。下一版团队正在收集真实的泰语文档照片和公式数据。
- 公式 仍是 OCR Markdown 最弱的部分。
- 没有文字的图片和图表 仍可能返回虚构的文字(纯空白页现已跳过)。
- 中文 不是目标语言,识别效果明显不如英文。
- 整页手写 不是目标。OCR Markdown 仅能识别行级手写;OCR Text 只识别印刷文本。
- 拍摄文字的短裁切图 效果不如整页:OCR Markdown 在 OCR104 文档照片上为 94.5。
- 与泰国政府文件风格不同的表格 仍可能缺行或行合并错误。
- 泰文数字 偶尔会被输出为阿拉伯数字。
- OCR Text: 装饰性很强的字体可能识别错误,无头字体仍可能混淆个别字母(ท 与 า),印章会被输出为文本,bf16 速度需要支持 AMX 的 CPU(Sapphire Rapids 或更新)。
团队正在继续改进。也感谢 Typhoon 团队与我们一同提升泰语 OCR 的水平。
👨👩👧 OpenThai 2 家族
| 模型 | 功能 | 规模 | 状态 |
|---|---|---|---|
| OpenThai 2.0 | 泰语对话与推理 LLM,可读图 | 27B | 已发布 |
| OpenThai 2.0 Legal | 面向 RAG 的泰国法律模型 | 30B-A3B | 已发布 |
| OpenThai-SystemOne | 泰英决策模型(不生成文本) | 0.8B | 已发布 |
| OpenThai 2.1 OCR Markdown | 页面 → Markdown,表格仍是表格 | 0.63B | 11 月 18 日更新 |
| OpenThai 2.1 OCR Text | CPU 上的印刷文本 OCR | 6.6 MB | 11 月 18 日更新 |
| OpenThai 2.0 ASR Streaming | 泰语实时语音转文字 | 0.64B | 已发布 |
🏷️ 使用 OpenThai OCR 的应用
如果你的应用使用这个模型,可以在 openthai.ai/powered-by 提交并列入名单,那里也有可放进应用的 Powered by 徽章。
🤝 参与贡献
- 有任何 OCR 都读不出来的泰语文档(不含个人信息)?发给我们试试。
- 欢迎在 Discord 和 Facebook 群组 交流。
📄 许可证与致谢
- OpenThai 2.1 OCR Markdown: OpenMDW-1.1,允许不受限制地使用,包括商用。它是 NVIDIA Nemotron 3.5 Parse(同为 OpenMDW-1.1)的衍生模型;分词器为 MIT 许可,我们的 llama.cpp 分支与 llama.cpp 一样采用 MIT 许可。Built on NVIDIA Nemotron。
- OpenThai 2.1 OCR Text: Apache-2.0。检测器及识别器的起点为 PaddlePaddle 的 PP-OCRv6-tiny(Apache-2.0)。
由 iApp 开发,与 AIEAT 联合发布。
🙏 感谢 Siam AI
两款模型均在 Siam AI Corporation 提供的 NVIDIA H100 GPU 上训练。衷心感谢他们一直以来对开放泰语 AI 的支持,也感谢 NVIDIA 提供 Nemotron 3.5 Parse。