📄 做到了!泰语文档 AI,两款模型免费开源
发布于 2026 年 11 月 12 日
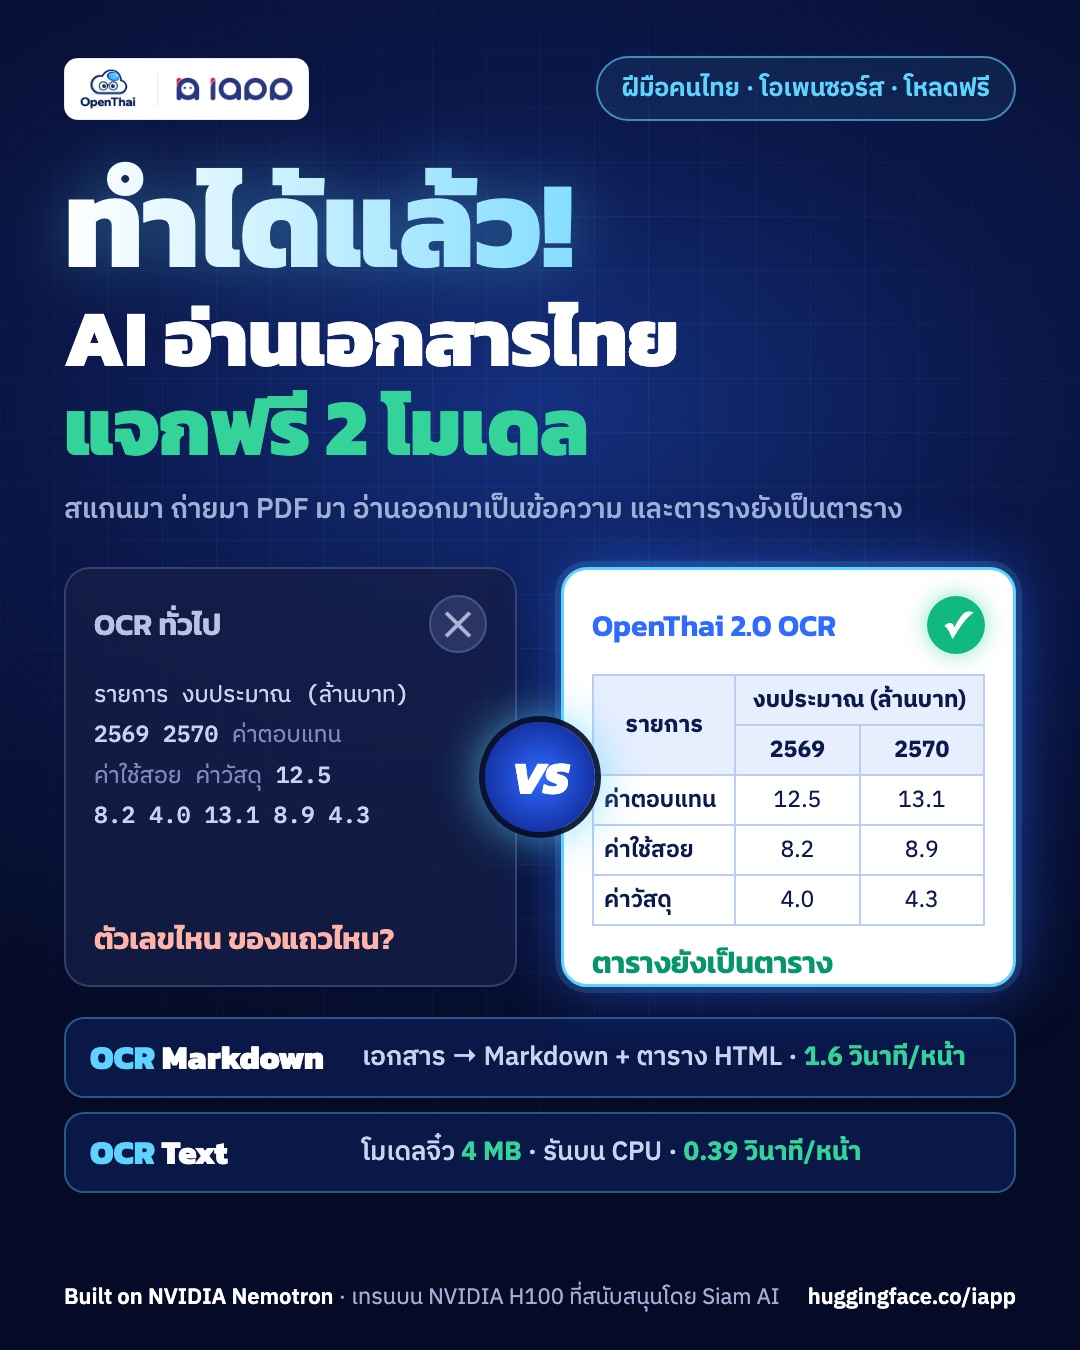
OCR Markdown 0.63BOCR Text 4 MB允许商用泰语 + 英语v1.0.0
是否遇到过这种情况? 扫描了一叠政府文件,想要其中的文字,OCR 却把表格读成一长行,分不清哪个数字属于哪一行,最后只好一格一格重新录入。
今天,iApp Technology 的 OpenThai 团队发布两款泰语 OCR 模型,任何人都可以免费下载使用,也允许商用。
| OpenThai 2.0 OCR Markdown | OpenThai 2.0 OCR Text | |
|---|---|---|
| 功能 | 页面 → Markdown,表格为 HTML(支持合并单元格),每个区块带边框与类别 | 页面 → 按阅读顺序的文本,每行带边框与置信度 |
| 规模 | 0.63B 参数 | 1.02M 参数,ONNX 文件共 4.2 MB |
| 运行环境 | 单张 NVIDIA GPU,使用 vLLM 部署 | 仅需 CPU,无需 GPU |
| 速度 | H100 上每页 1.6 秒 | 每页 0.39 秒;8 核约每分钟 950 页 |
| 基础模型 | NVIDIA Nemotron 3.5 Parse | PaddlePaddle PP-OCRv6-tiny |
| 许可证 | OpenMDW-1.1 | Apache-2.0 |
| 适用场景 | 含表格的文档、预算文件、泰国皇家公报、为 RAG 准备文档 | 大批量纯文本、无 GPU 的机器、不能离开本地的机密文件 |
1) OpenThai 2.0 OCR Markdown:表格仍是表格
把泰语文档页面读成 Markdown,表格输出为带 rowspan 与 colspan 的 HTML。它是在 NVIDIA Nemotron 3.5 Parse(0.63B)基础上的全量微调,因此保留 Parse 的版面框、区块类别与阅读顺序,凡能运行 Parse 的地方都能运行它。
- 65 页真实泰国政府与大学含表格文档(th-docs-tables v1)得分 95.2,Typhoon OCR V2 2B 为 91.6(+3.6,95% 区间 [+1.2, +6.2])。
- 在训练完成后才发布的 339 页泰国皇家公报上(2026 年 11 月 4–9 日),字符准确率 98.7%;Typhoon OCR V2 2B 为 94.6。
- 12 个泰语印刷文本数据集平均 90.3,在我们测试的 15 个引擎中最高;Typhoon OCR V2 2B 为 89.6,差异不显著。
- 单张 NVIDIA H100 上 每页 1.6 秒(12 页表格页面的中位数,逐页发送)。
- 所有测试页面及 6,137 页开发集页面均未出现重复循环。
OpenThai2.0-OCR-Markdown:模型权重与含完整结果的模型卡huggingface.co/iapp/OpenThai2.0-OCR-Markdown
不想自己维护 GPU?OpenThai 2.0 OCR Markdown API,每页 0.15 IC,可在线试用iapp.co.th/docs/ocr/document-markdown
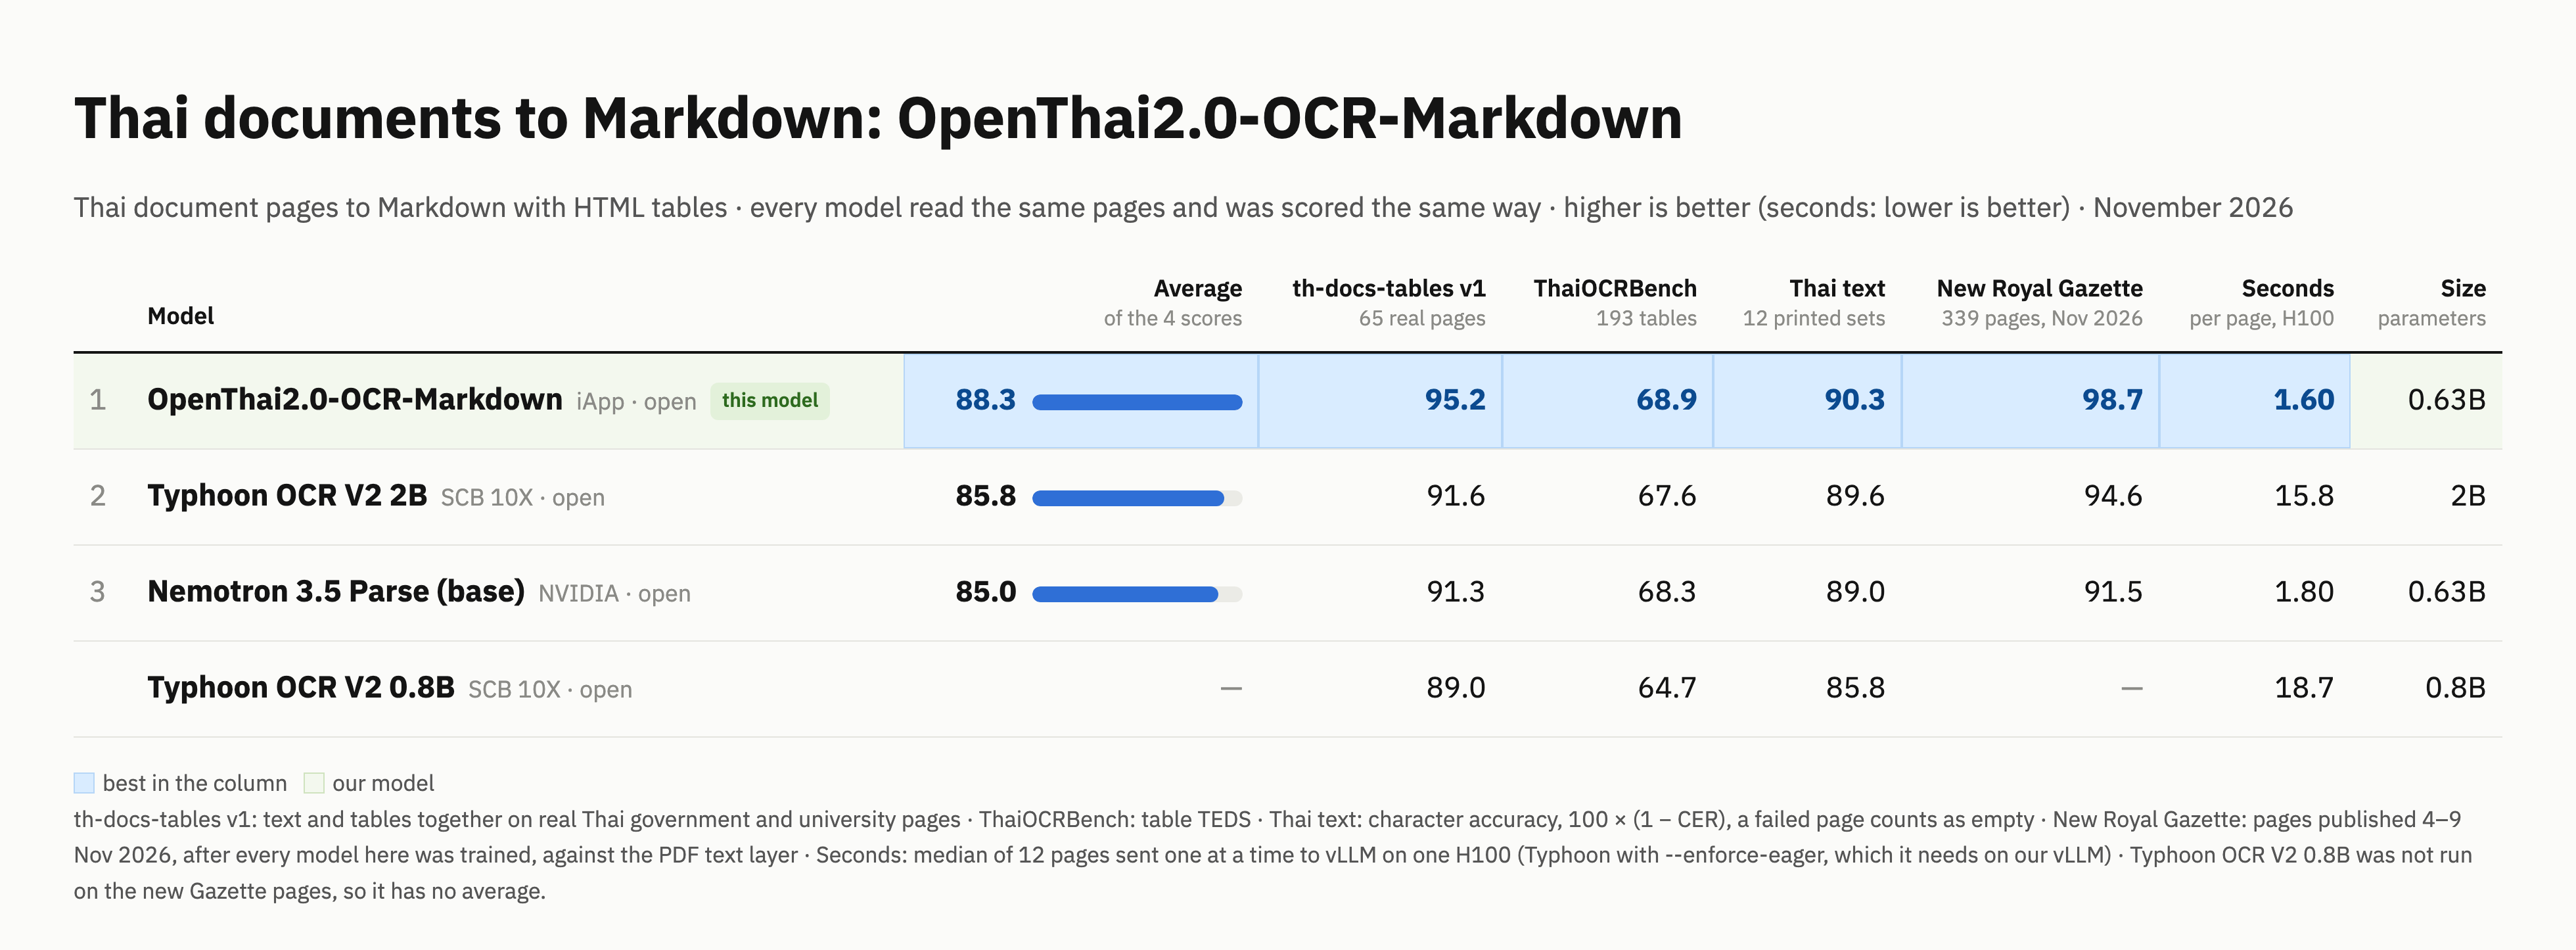
| 模型 | 规模 | th-docs-tables v1(65 页) | ThaiOCRBench 表格(193 张) | 泰语印刷文本(12 个数据集) | 新皇家公报(339 页) | 平均 | 每页秒数 |
|---|---|---|---|---|---|---|---|
| OpenThai2.0-OCR-Markdown | 0.63B | 95.2 | 68.9 | 90.3 | 98.7 | 88.3 | 1.6 |
| Nemotron 3.5 Parse(基础模型) | 0.63B | 91.3 | 68.3 | 89.0 | 91.5 | 85.0 | 1.8 |
| Typhoon OCR V2 2B | 2B | 91.6 | 67.6 | 89.6 | 94.6 | 85.8 | 15.8 |
| Typhoon OCR V2 0.8B | 0.8B | 89.0 | 64.7 | 85.8 | — | — | 18.7 |
粗体为各列最佳。平均为四个准确率列的均值。ThaiOCRBench 表格(+1.3)与印刷文本(+0.76)上与 Typhoon OCR V2 2B 的差异不显著。Typhoon 以 --enforce-eager 运行(在我们的 vLLM 版本上必需),若能使用 CUDA graphs 会更快。新皇家公报属于模型熟悉的文档类型(训练数据含此前月份的公报),但这些页面均未参与训练。
使用方法
与基础模型一样用 vLLM 部署,再用 NVIDIA 的 DocumentParser 解析页面(边框与类别提示,单次处理):
vllm serve iapp/OpenThai2.0-OCR-Markdown --served-model-name nemotron-parse --trust-remote-code
from nemotron_parse.inference import DocumentParser, GenerationError

with DocumentParser(base_url="http://localhost:8000/v1", model="nemotron-parse") as parser:
    doc = parser.parse("page.png", mode="single")
    print(doc["markdown"])  # Markdown;表格为带 rowspan/colspan 的 HTML
请使用我们测试过的 box 模式。完整安装步骤见模型卡。
2) OpenThai 2.0 OCR Text:4 MB,无需 GPU
在普通 CPU 上运行的泰语与英语印刷文本 OCR:PP-OCRv6-tiny 行检测器(1.8 MB)加上 iApp 训练的泰语行识别器(2.4 MB),使用 OpenVINO 或 ONNX Runtime 运行。
- 密集 A4 页面每页 0.39 秒,8 核 Xeon 约每分钟 950 页,每个 worker 约占 450 MB 内存。
- 可离线运行,机密文件无需离开本机。
- 预算文件 99.5,皇家公报 96.3(Gemini 2.5 Flash 为 81.0 与 92.6;Google Cloud Vision 为 75.0 与 87.8)。
- 自动摆正页面、纠正倾斜、按顺序读取多栏页面、识别深色底浅色字,通过鲁棒性测试的全部 22 种条件。
- iApp 的 OpenThai 2.0 OCR Text API 基于此模型构建。
OpenThai2.0-OCR-Text:ONNX 模型、运行时与 15 个引擎的对比huggingface.co/iapp/OpenThai2.0-OCR-Text
OpenThai 2.0 OCR Text API:纯文本每页 0.049 IC;Word、Excel 与可搜索 PDF 每页 0.15 ICiapp.co.th/docs/ocr/document
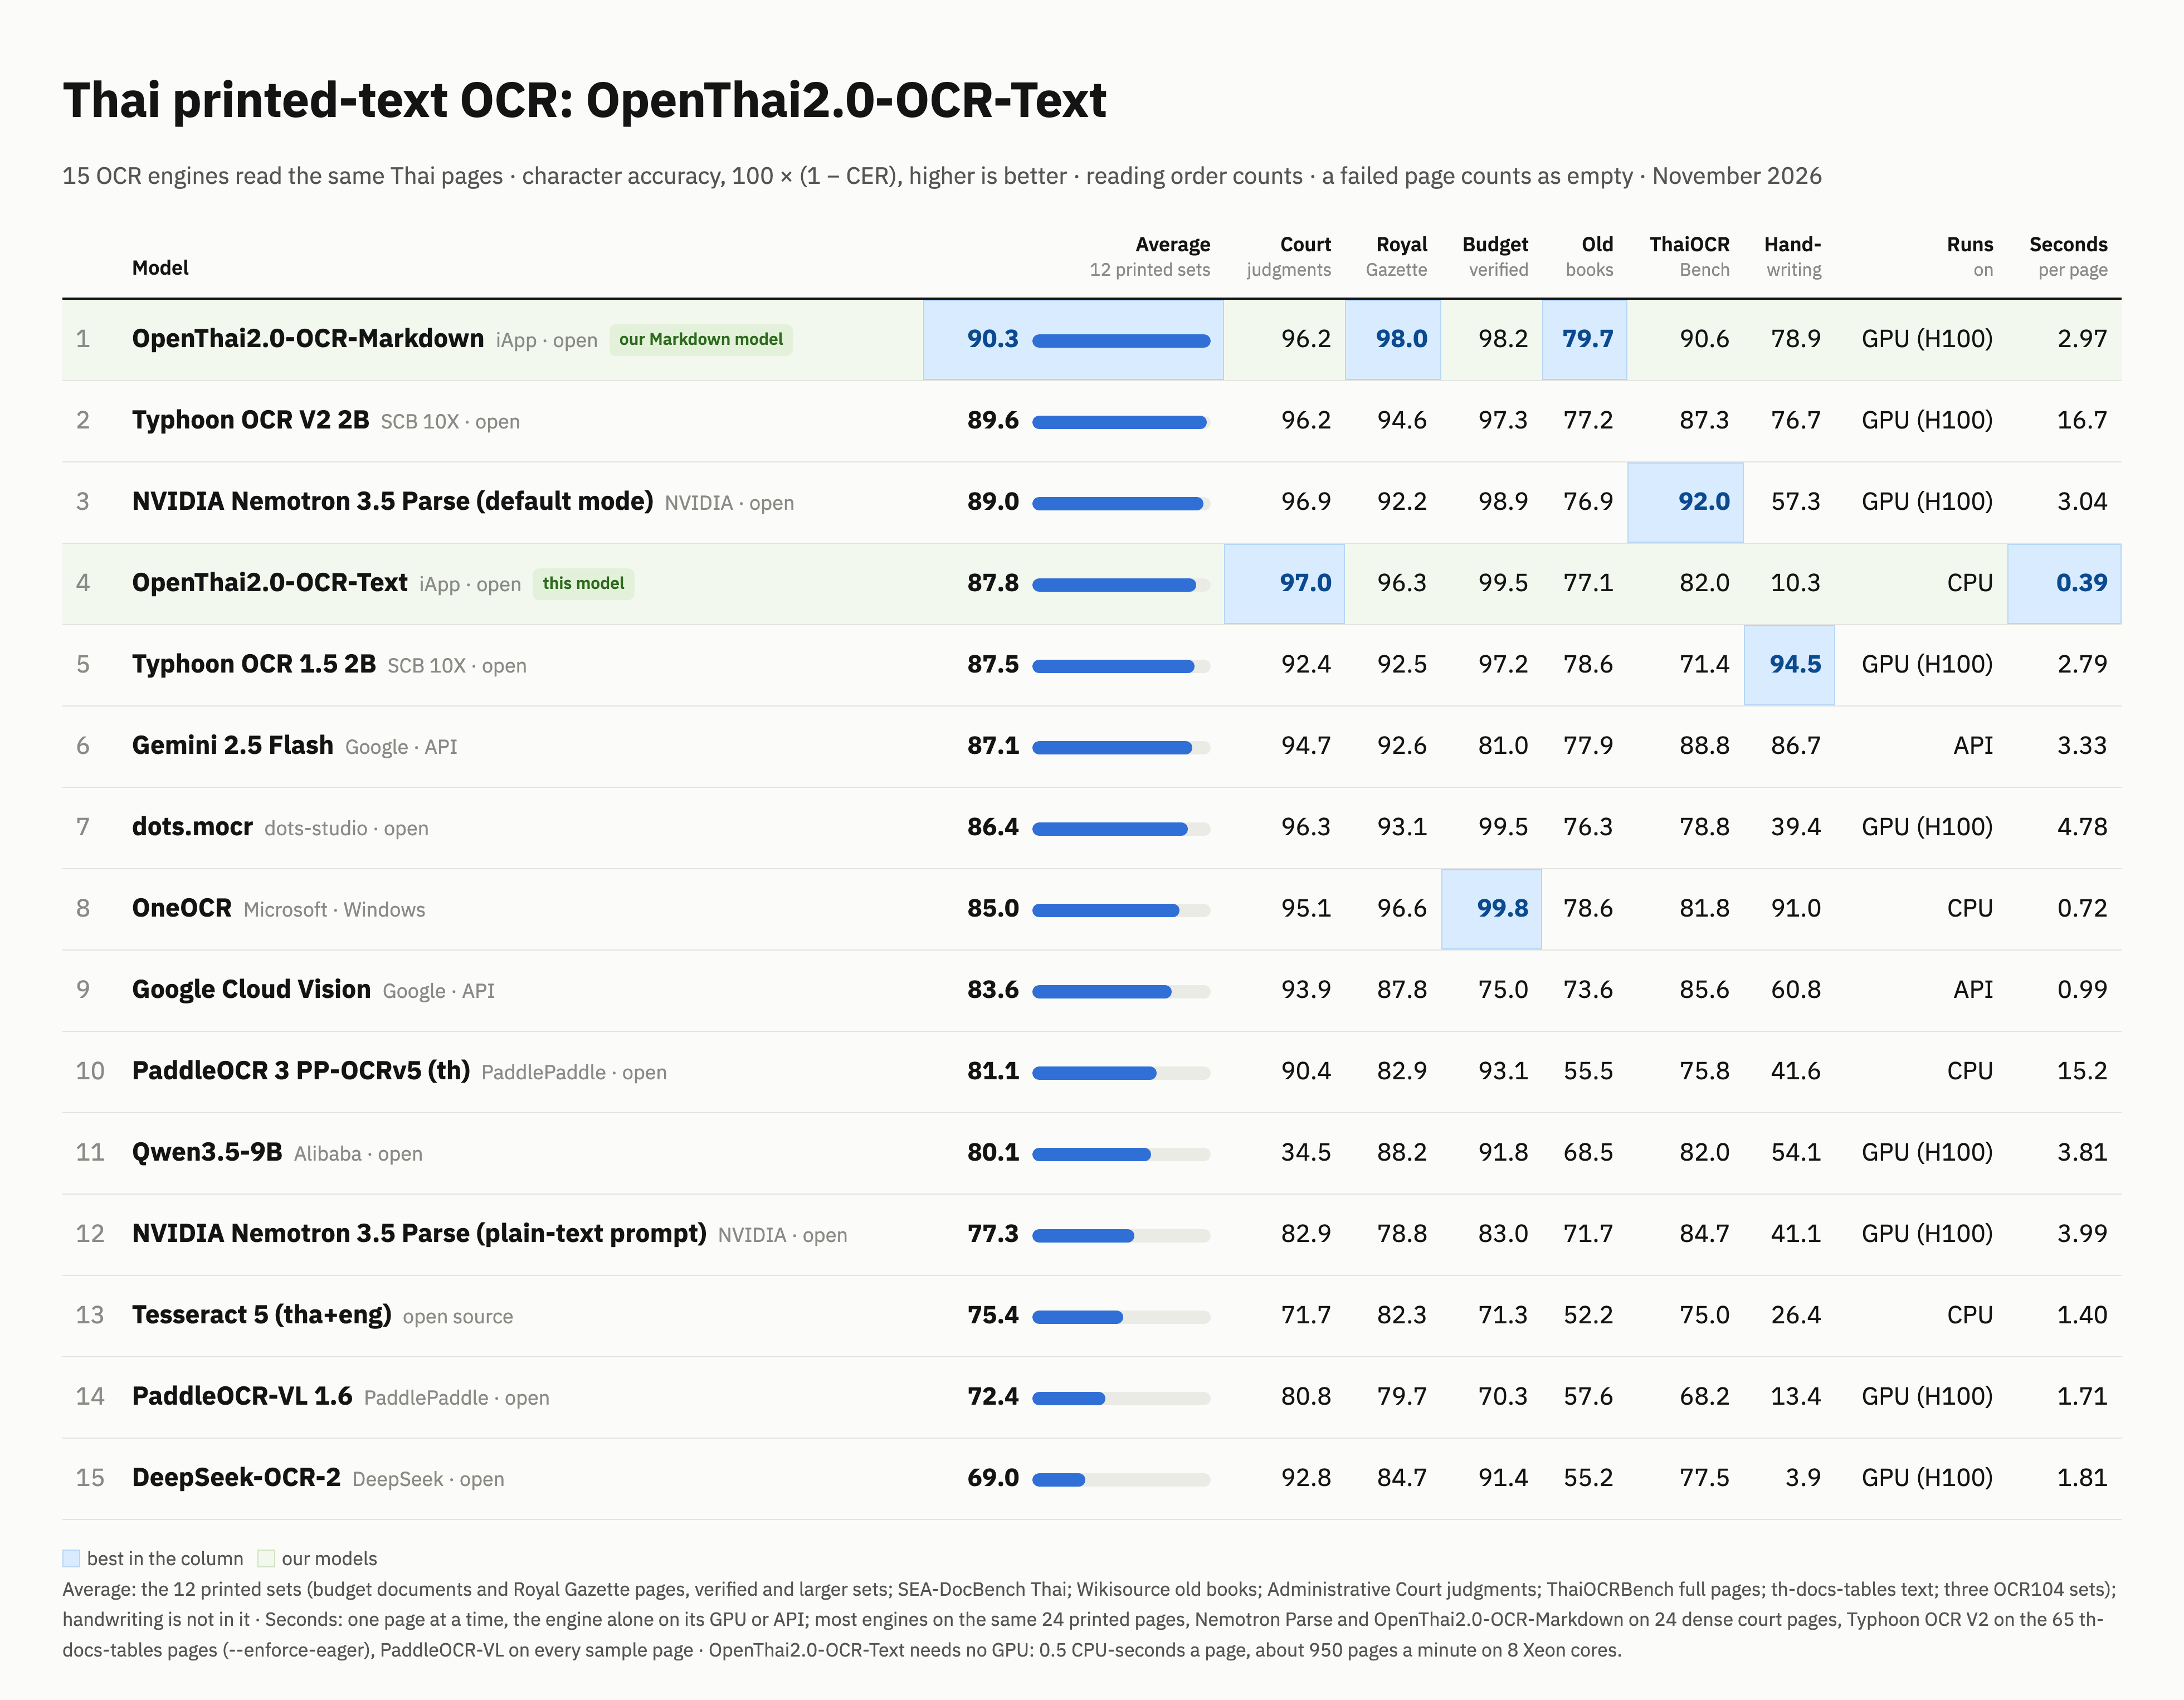
所有引擎读取相同页面、以相同方式评分:字符准确率 100 × (1 − CER),越高越好。
| 引擎 | 12 个印刷数据集平均 | 法院判决 | 皇家公报 | 预算文件 | 古籍 | ThaiOCRBench | 手写 |
|---|---|---|---|---|---|---|---|
| OpenThai2.0-OCR-Text(本模型,CPU) | 87.8 | 97.0 | 96.3 | 99.5 | 77.1 | 82.0 | 10.3 |
| OpenThai2.0-OCR-Markdown(GPU) | 90.3 | 96.2 | 98.0 | 98.2 | 79.7 | 90.6 | 78.9 |
| Typhoon OCR V2 2B | 89.6 | 96.2 | 94.6 | 97.3 | 77.2 | 87.3 | 76.7 |
| NVIDIA Nemotron 3.5 Parse | 89.0 | 96.9 | 92.2 | 98.9 | 76.9 | 92.0 | 57.3 |
| Typhoon OCR 1.5 2B | 87.5 | 92.4 | 92.5 | 97.2 | 78.6 | 71.4 | 94.5 |
| Gemini 2.5 Flash | 87.1 | 94.7 | 92.6 | 81.0 | 77.9 | 88.8 | 86.7 |
| dots.mocr | 86.4 | 96.3 | 93.1 | 99.5 | 76.3 | 78.8 | 39.4 |
| OneOCR(Microsoft,Windows) | 85.0 | 95.1 | 96.6 | 99.8 | 78.6 | 81.8 | 91.0 |
| Google Cloud Vision | 83.6 | 93.9 | 87.8 | 75.0 | 73.6 | 85.6 | 60.8 |
| PaddleOCR 3 PP-OCRv5 (th) | 81.1 | 90.4 | 82.9 | 93.1 | 55.5 | 75.8 | 41.6 |
| Qwen3.5-9B | 80.1 | 34.5 | 88.2 | 91.8 | 68.5 | 82.0 | 54.1 |
| Tesseract 5 (tha+eng) | 75.4 | 71.7 | 82.3 | 71.3 | 52.2 | 75.0 | 26.4 |
| PaddleOCR-VL 1.6 | 72.4 | 80.8 | 79.7 | 70.3 | 57.6 | 68.2 | 13.4 |
| DeepSeek-OCR-2 | 69.0 | 92.8 | 84.7 | 91.4 | 55.2 | 77.5 | 3.9 |
粗体为各列最佳。平均涵盖 12 个印刷数据集(预算文件、皇家公报、SEA-DocBench、维基文库古籍、行政法院判决、ThaiOCRBench、th-docs-tables 以及 3 个 OCR104 数据集),不含手写。含 Nemotron 3.5 Parse 纯文本提示及各引擎速度的完整表格见模型卡。法院判决属于训练域内:训练数据包含法院扫描件(与测试文件不同)。
使用方法
hf download iapp/OpenThai2.0-OCR-Text --local-dir OpenThai2.0-OCR-Text
pip install openvino opencv-python-headless pyclipper numpy
cd OpenThai2.0-OCR-Text
from runtime.line_engine import LineOCR

ocr = LineOCR(".", threads=1)
r = ocr.read("page.png")      # 路径、bytes、ndarray 或 PIL 图像
print(r["text"])              # 按阅读顺序的文本
r["lines"]                    # [{"text", "confidence", "row", "box"}]
如需高吞吐量,请每个 CPU 核运行一个 worker 进程,并设置 threads=1。
🤔 为什么免费开源
泰国政府机构、医院和企业中还有数以百万计的文档页面不能上传到境外云端。我们希望每个机构都能在自己的机器上读取它们。而任何想用自家文档搭建 AI 聊天机器人的人,第一步都是把文档读对。
⚠️ 坦白说:尚不擅长的地方
- 整页手写 不是目标。OCR Markdown 仅能识别行级手写;OCR Text 只识别印刷文本。
- 单个词语的照片和极短的裁切图 效果不如整页:OCR Markdown 在 OCR104 文档照片上为 96.4,Typhoon OCR V2 2B 为 99.8。
- 与泰国政府文件风格不同的表格 与基础模型水平相近(ThaiOCRBench 表格 68.9,基础模型 68.3),部分表格仍会缺行或行合并错误。
- 泰文数字 偶尔会被输出为阿拉伯数字(339 页公报约 22,000 个泰文数字中有 112 个)。
- 针式打印字体(银行存折):在生成的开发集上为 89%,尚无真实测试集。
- 竖排文字(如旋转的表头)可能识别错误。
- OCR Text: 装饰性很强的字体可能识别错误,印章会被输出为文本,bf16 速度需要支持 AMX 的 CPU(Sapphire Rapids 或更新)。
团队正在继续改进。也感谢 Typhoon 团队与我们一同提升泰语 OCR 的水平。
👨👩👧 OpenThai 2.0 家族
| 模型 | 功能 | 规模 | 状态 |
|---|---|---|---|
| OpenThai 2.0 | 泰语对话与推理 LLM,可读图 | 27B | 已发布 |
| OpenThai 2.0 Legal | 面向 RAG 的泰国法律模型 | 30B-A3B | 已发布 |
| OpenThai-SystemOne | 泰英决策模型(不生成文本) | 0.8B | 已发布 |
| OpenThai 2.0 OCR Markdown | 页面 → Markdown,表格仍是表格 | 0.63B | 已发布 |
| OpenThai 2.0 OCR Text | CPU 上的印刷文本 OCR | 4 MB | 已发布 |
🤝 参与贡献
- 有任何 OCR 都读不出来的泰语文档(不含个人信息)?发给我们试试。
- 欢迎在 OpenThaiGPT Discord 和 Facebook 群组 交流。
📄 许可证与致谢
- OpenThai 2.0 OCR Markdown: OpenMDW-1.1,允许不受限制地使用,包括商用。它是 NVIDIA Nemotron 3.5 Parse(同为 OpenMDW-1.1)的衍生模型;分词器为 MIT 许可。Built on NVIDIA Nemotron。
- OpenThai 2.0 OCR Text: Apache-2.0。检测器及识别器的起点为 PaddlePaddle 的 PP-OCRv6-tiny(Apache-2.0)。
由 iApp Technology / OpenThai 团队开发。
🙏 感谢 Siam AI
两款模型均在 Siam AI Corporation 提供的 NVIDIA H100 GPU 上训练。衷心感谢他们一直以来对开放泰语 AI 的支持,也感谢 NVIDIA 提供 Nemotron 3.5 Parse。