🎙️ 做到了!泰语实时语音转文字,免费下载
发布于 2026 年 11 月 13 日
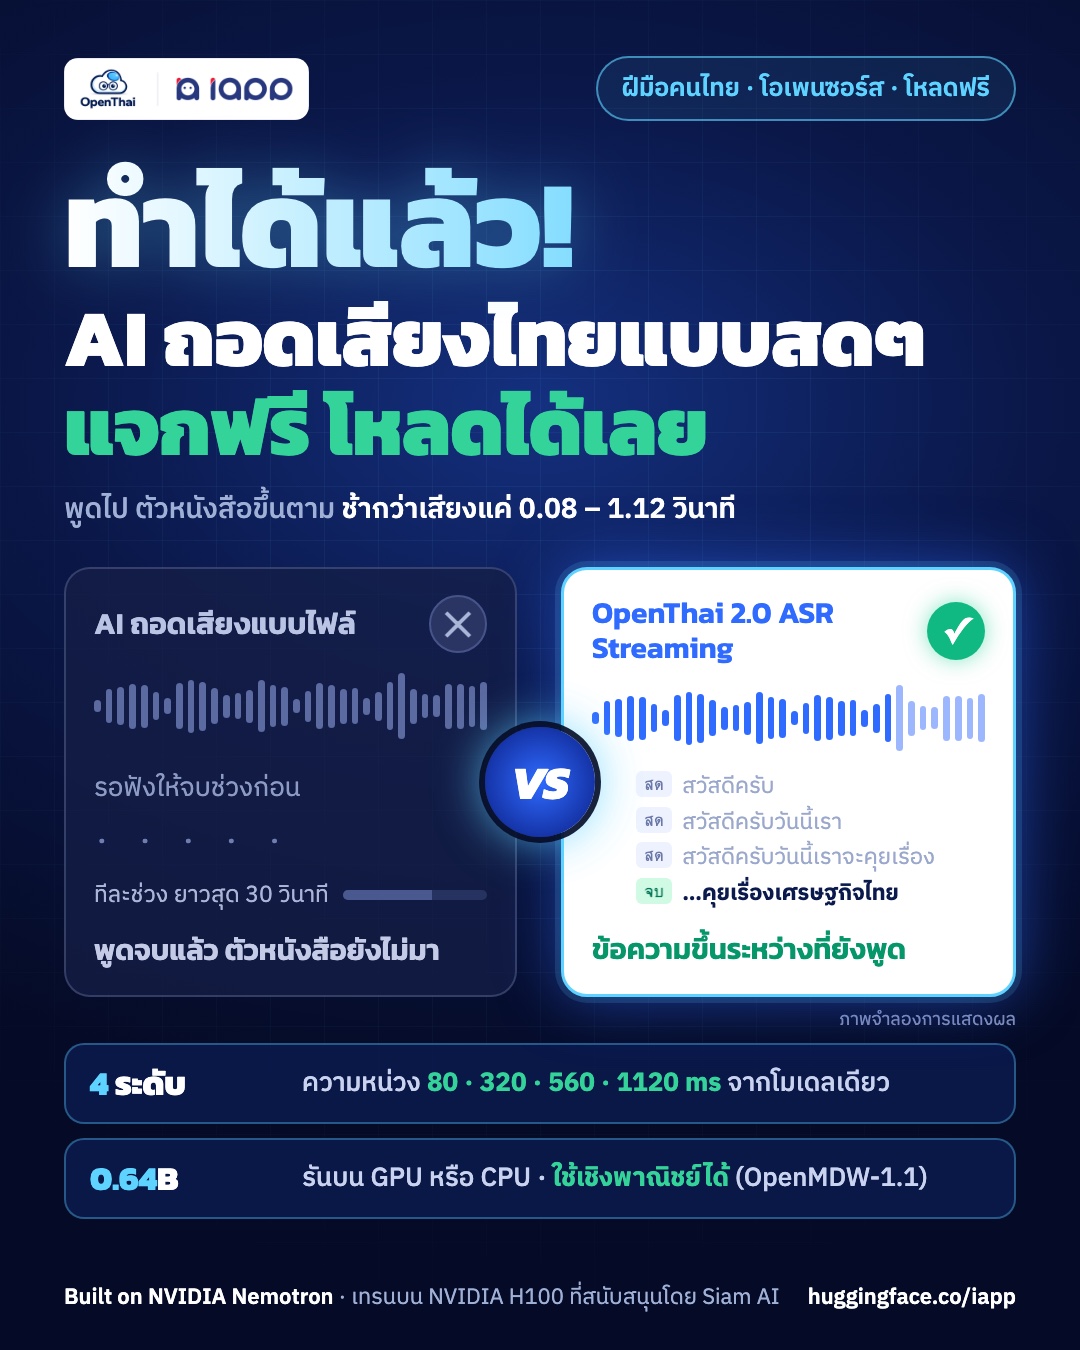
0.64B比声音慢 80–1120 毫秒GPU 或 CPU允许商用OpenMDW-1.1
是否遇到过这种情况? 看直播、上课或开线上会议时想要泰语实时字幕,但大多数开放的泰语语音识别模型必须先听完一整段才开始写,等文字出来时,说话人已经讲到别的事了。
今天 iApp Technology 的 OpenThai 团队发布 OpenThai 2.0 ASR Streaming,免费下载:一款在说话人还在说话时就写出文字的泰语语音识别模型,允许商用。
| OpenThai 2.0 ASR Streaming | |
|---|---|
| 做什么 | 泰语实时语音转文字,比声音慢 80 到 1120 毫秒 |
| 延迟 | 一个模型,四档:80、320、560 和 1120 毫秒 |
| 规模 | 0.64B 参数 |
| 基于 | NVIDIA Nemotron 3.5 ASR Streaming 0.6B |
| GPU | 单张 NVIDIA H100 可同时跟上约 20 路实时音频流(560 毫秒),转写文件约为实时速度的 257 倍 |
| CPU | 8 线程可跟上 1 路实时音频流(320 或 560 毫秒,80 毫秒不行),转写文件约为实时速度的 4 倍,需约 6.5 GB 内存 |
| 文件 | Hugging Face 上的模型权重,以及 ONNX 导出版(全精度和 int8) |
| 许可证 | OpenMDW-1.1,允许商用 |
亮点
- 边说边出字。 文字比声音慢 0.08 到 1.12 秒。一个模型有四档(80、320、560 和 1120 毫秒),速度与准确度任选。
- 一张 GPU 跑多路。 单张 NVIDIA H100 在 560 毫秒下可同时跟上约 20 路实时音频流,转写文件约为实时速度的 257 倍。
- 没有 GPU 也能用。 8 线程 CPU 在 320 或 560 毫秒下可跟上 1 路实时音频流,需约 6.5 GB 内存。
- 可在自己的机器上运行。 语音不出机构,适合不能把语音上传到境外云端的机构,例如医院和银行。
- OpenThai ASR Realtime 背后的模型,即 iApp 的实时语音转文字 WebSocket API。
OpenThai2.0-ASR-Streaming:模型权重、模型卡、运行方法和附带的服务器huggingface.co/iapp/OpenThai2.0-ASR-Streaming
ONNX 导出版:全精度和 int8huggingface.co/iapp/OpenThai2.0-ASR-Streaming-ONNX
测试结果
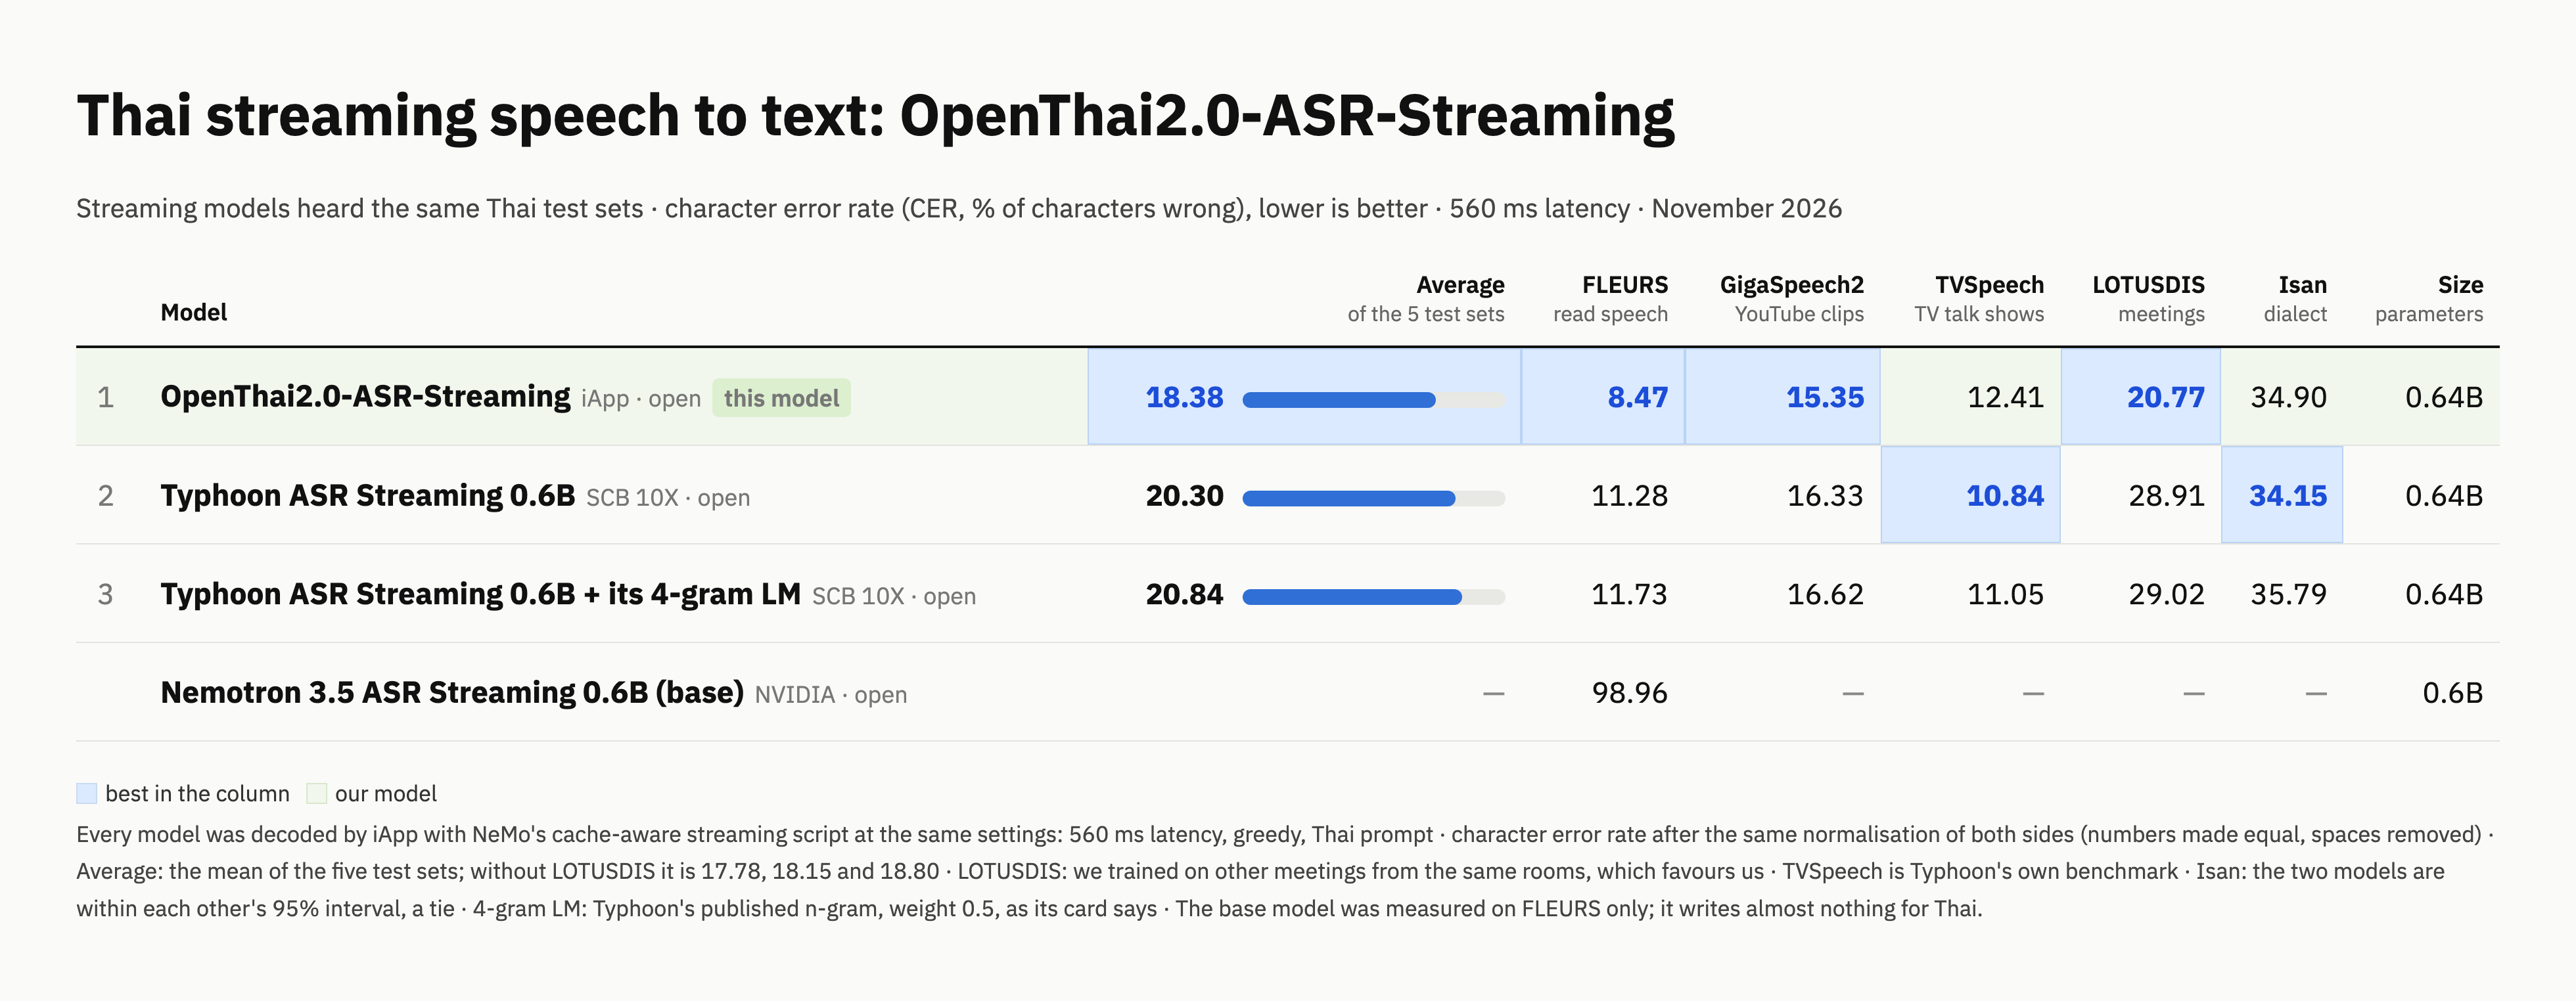
我们与基于同一 NVIDIA 基础模型的 Typhoon ASR Streaming 0.6B 直接比较。两个模型都由我们自己解码,使用相同的测试集和相同的脚本,延迟为 560 毫秒。
| 测试集 | 语音类型 | OpenThai 2.0 ASR Streaming | Typhoon ASR Streaming 0.6B | 结果 |
|---|---|---|---|---|
| FLEURS | 朗读 | 8.47 | 11.28 | 我们领先 |
| GigaSpeech2 | YouTube 视频 | 15.35 | 16.33 | 我们领先 |
| LOTUSDIS | 会议 | 20.77 | 28.91 | 我们领先(对我们有利,见说明) |
| TVSpeech | 电视访谈节目 | 12.41 | 10.84 | Typhoon 领先 |
| 伊散 | 伊散方言 | 34.90 | 34.15 | 持平 |
数字为识别错误的字符百分比,越低越好。粗体为两者中较好的一方。LOTUSDIS: 我们用同一批会议室录制的其他会议做了训练,因此这一集对我们有利。伊散: 差距很小,视为持平。
从 99% 到 8.47%
- 微调之前,NVIDIA 基础模型 Nemotron 3.5 ASR Streaming 0.6B 在 FLEURS 泰语上有 98.96% 的字符识别错误;现在同一测试集上只有 8.47%。
- 我们为分词器新增了 1,901 个泰语单元。
- 训练使用了 12,373 小时泰语语音和 961 小时英语语音。
- 在 Siam AI 支持的 NVIDIA H100 GPU 上训练。
使用方法
hf download iapp/OpenThai2.0-ASR-Streaming --local-dir OpenThai2.0-ASR-Streaming
运行方法、延迟设置,以及用于文件和实时音频的附带服务器,请见模型卡。
- 长录音必须先在停顿处切分再解码。 附带的服务器会自动完成。把一段长录音作为单一音频流解码,会在安静的停顿之后丢字。
- 英语单词: 默认的
th-TH模式全部用泰文字母书写;th-mix模式只会把部分英语单词写成拉丁字母。
不想自己维护 GPU?OpenThai ASR Realtime 以 WebSocket API 提供同一模型,发布期间免费,并非永久免费。
🤔 为什么免费?
我们希望聋人、听障人士和老年人在任何地方都能看直播、看新闻、上课、开会,并有泰语实时字幕。而任何想打造反应迅速的泰语语音助手的人,第一步都是跟上泰语语音。
⚠️ 坦白说:目前还不擅长的地方
- 电视访谈节目: Typhoon 仍然更好(TVSpeech 12.41 对 10.84)。
- 伊散方言: 与 Typhoon 持平(34.90 对 34.15)。
- 英语单词: 默认模式全部写成泰文字母;
th-mix只会把部分单词写成拉丁字母。 - 长录音 必须先在停顿处切分再解码(附带的服务器和 iApp 的托管服务已经这样做)。
- 在 CPU 上 只有 320 和 560 毫秒能跟上实时,80 毫秒不行。
团队正在继续改进。感谢 Typhoon 团队与我们一同提升泰语语音识别的水平。
👨👩👧 OpenThai 2.0 家族
| 模型 | 用途 | 规模 | 状态 |
|---|---|---|---|
| OpenThai 2.0 | 泰语对话与推理 LLM,可读图像 | 27B | 已发布 |
| OpenThai 2.0 Legal | 用于 RAG 的泰国法律模型 | 30B-A3B | 已发布 |
| OpenThai-SystemOne | 泰语+英语决策模型(不生成文本) | 0.8B | 已发布 |
| OpenThai 2.0 OCR Markdown | 文档页面转 Markdown,表格仍是表格 | 0.63B | 已发布 |
| OpenThai 2.0 OCR Text | 在 CPU 上识别印刷文本 | 4 MB | 已发布 |
| OpenThai 2.0 ASR Streaming | 泰语实时语音转文字 | 0.64B | 已发布 |
🤝 参与贡献
- 想为某个活动做实时字幕,或遇到识别效果很差的音频(不含个人信息)?欢迎告诉团队。
- 欢迎在 Discord 和 Facebook 群组 交流。
- iApp 网站上的更多内容:发布文章和模型页面。
📄 许可证与致谢
- OpenThai 2.0 ASR Streaming: OpenMDW-1.1,允许商用。基于 NVIDIA Nemotron 3.5 ASR Streaming 0.6B 的衍生作品。Built on NVIDIA Nemotron
由 iApp Technology / OpenThai 团队开发。
🙏 感谢 Siam AI
本模型在 Siam AI Corporation 支持的 NVIDIA H100 GPU 上训练。衷心感谢他们一直以来对开放泰语 AI 的支持,也感谢 NVIDIA 提供 Nemotron 3.5 ASR Streaming。