🚀 发布 OpenThai 2.0
发布于 2026 年 8 月 27 日
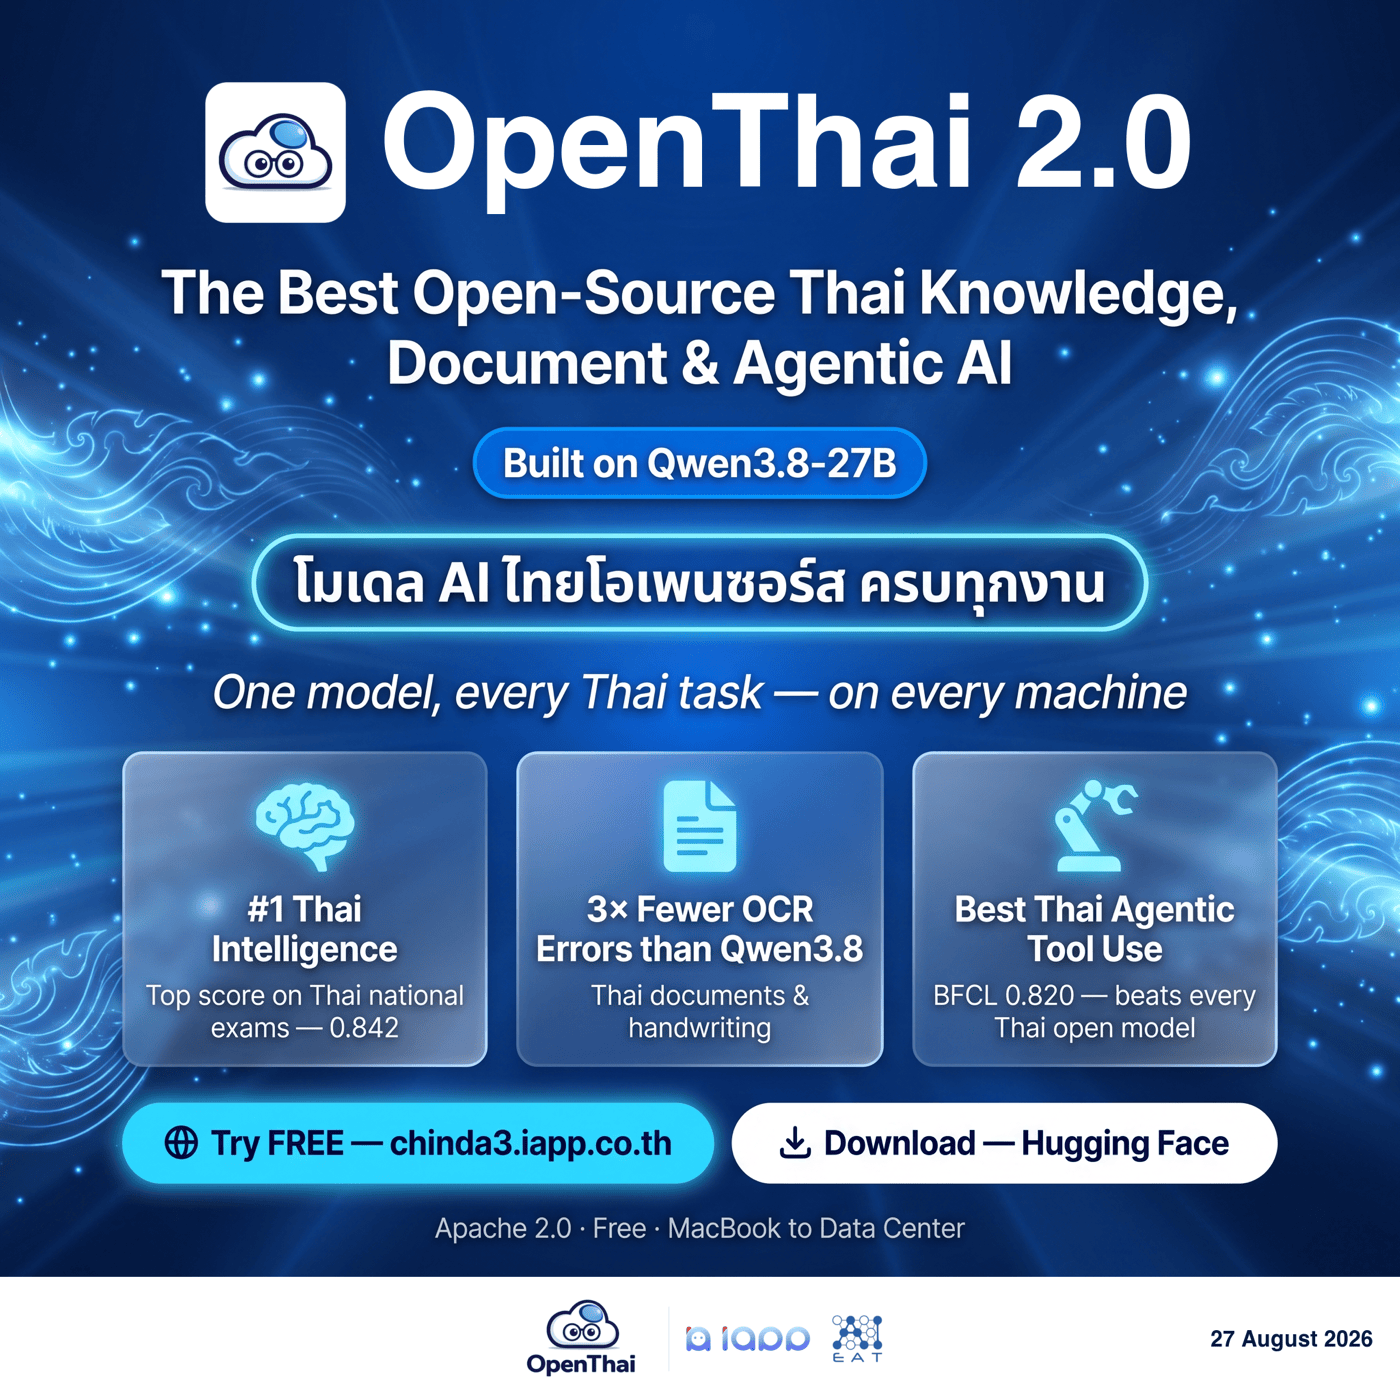
一个全能的开放泰语 AI —— 以专家级水平阅读泰文文档与手写体,用自然、善于讲解的泰语回答泰语知识问题,智能体工具调用超过其基座模型。
OpenThai 项目自豪地推出新旗舰 OpenThai 2.0:一个 27B 参数的多模态(图像 + 文本)语言模型,基于 Qwen3.8-27B 构建,完整权重以 Apache 2.0 协议开放 —— 可免费商用,并可完全在你自己的基础设施内运行,数据不出组织。
由 iApp Technology 与泰国人工智能企业家协会(AIEAT)联合打造,献给所有需要处理泰文文档、泰文手写体、泰语知识与工具调用智能体的人。
在线体验
在浏览器里直接与真实模型对话 —— 免费,无需安装。
免费在线演示 — 无需安装chinda3.iapp.co.th
下载模型
OpenThai 2.0 (27B) — Hugging Facehuggingface.co/iapp/openthai2.0-qwen3.8-27b
iapp/openthai2.0-qwen3.8-27b
或者通过 Ollama 在自己的机器上最简单地运行:
Ollama 上的 OpenThai 2.0 — 一条命令本地运行ollama.com/openthai/openthai2.0-qwen3.8-27b
ollama run openthai/openthai2.0-qwen3.8-27b
提供 5 种格式,从 MacBook 到 NVIDIA Blackwell:
| 格式 | 仓库 | 运行环境 |
|---|---|---|
| bf16 | openthai2.0-qwen3.8-27b | vLLM / transformers · 1× 80 GB GPU |
| GGUF Q4_K_M / Q8_0 + 视觉 mmproj | openthai2.0-qwen3.8-27b-GGUF | llama.cpp · CPU 或消费级 GPU(17 / 29 GB) |
| MLX 4-bit | openthai2.0-qwen3.8-27b-MLX-4bit | Apple 芯片,24 GB+ 统一内存(约 16 GB)· 或通过 TensorFold 在 Mac / NVIDIA 上运行 |
| INT8 W8A8 | openthai2.0-qwen3.8-27b-INT8-W8A8 | vLLM · 约 40 GB 级 GPU |
| NVFP4 | openthai2.0-qwen3.8-27b-NVFP4 | vLLM · NVIDIA Blackwell |
🌟 亮点
- 开放模型中最强的泰语知识 — 泰国国家级考试(OpenThaiEval)0.842,高于基座模型(0.820)、Typhoon 2.5(0.742)与 Pathumma(0.660);泰语指令遵循(IFEval-TH)0.795,同样全场领先。
- 以专家级水平阅读泰文文档与手写体 — 泰文手写体错误率较基座模型降低 60%(CER 0.261 对 0.649),书籍与皇家公报页降低 66%(0.126 对 0.370)—— 是表中唯一既能以专家级水平读文档、又能在同一个模型里回答文档问题的开放泰语模型。
- 真正可用的工具调用智能体 — Berkeley Function-Calling Leaderboard(BFCL)0.820,超过基座模型与 Typhoon 2.5;多轮智能体任务 0.775,对比 Typhoon 的 0.550。代码能力(HumanEval)0.957。
- 以自然、善于讲解的泰语作答 — 需要时可切换为简短回答或 JSON 输出。
- 解码速度提升 1.5 倍 — 内置多 token 预测(MTP)草稿头,可做自推测解码:实测 75.2 tok/s 对 50.1 tok/s,输出逐 token 完全一致。
- 真正开放 — Apache 2.0,完整权重外加独立 LoRA 适配器,并完整保留基座模型的通用智能。
📊 基准测试结果
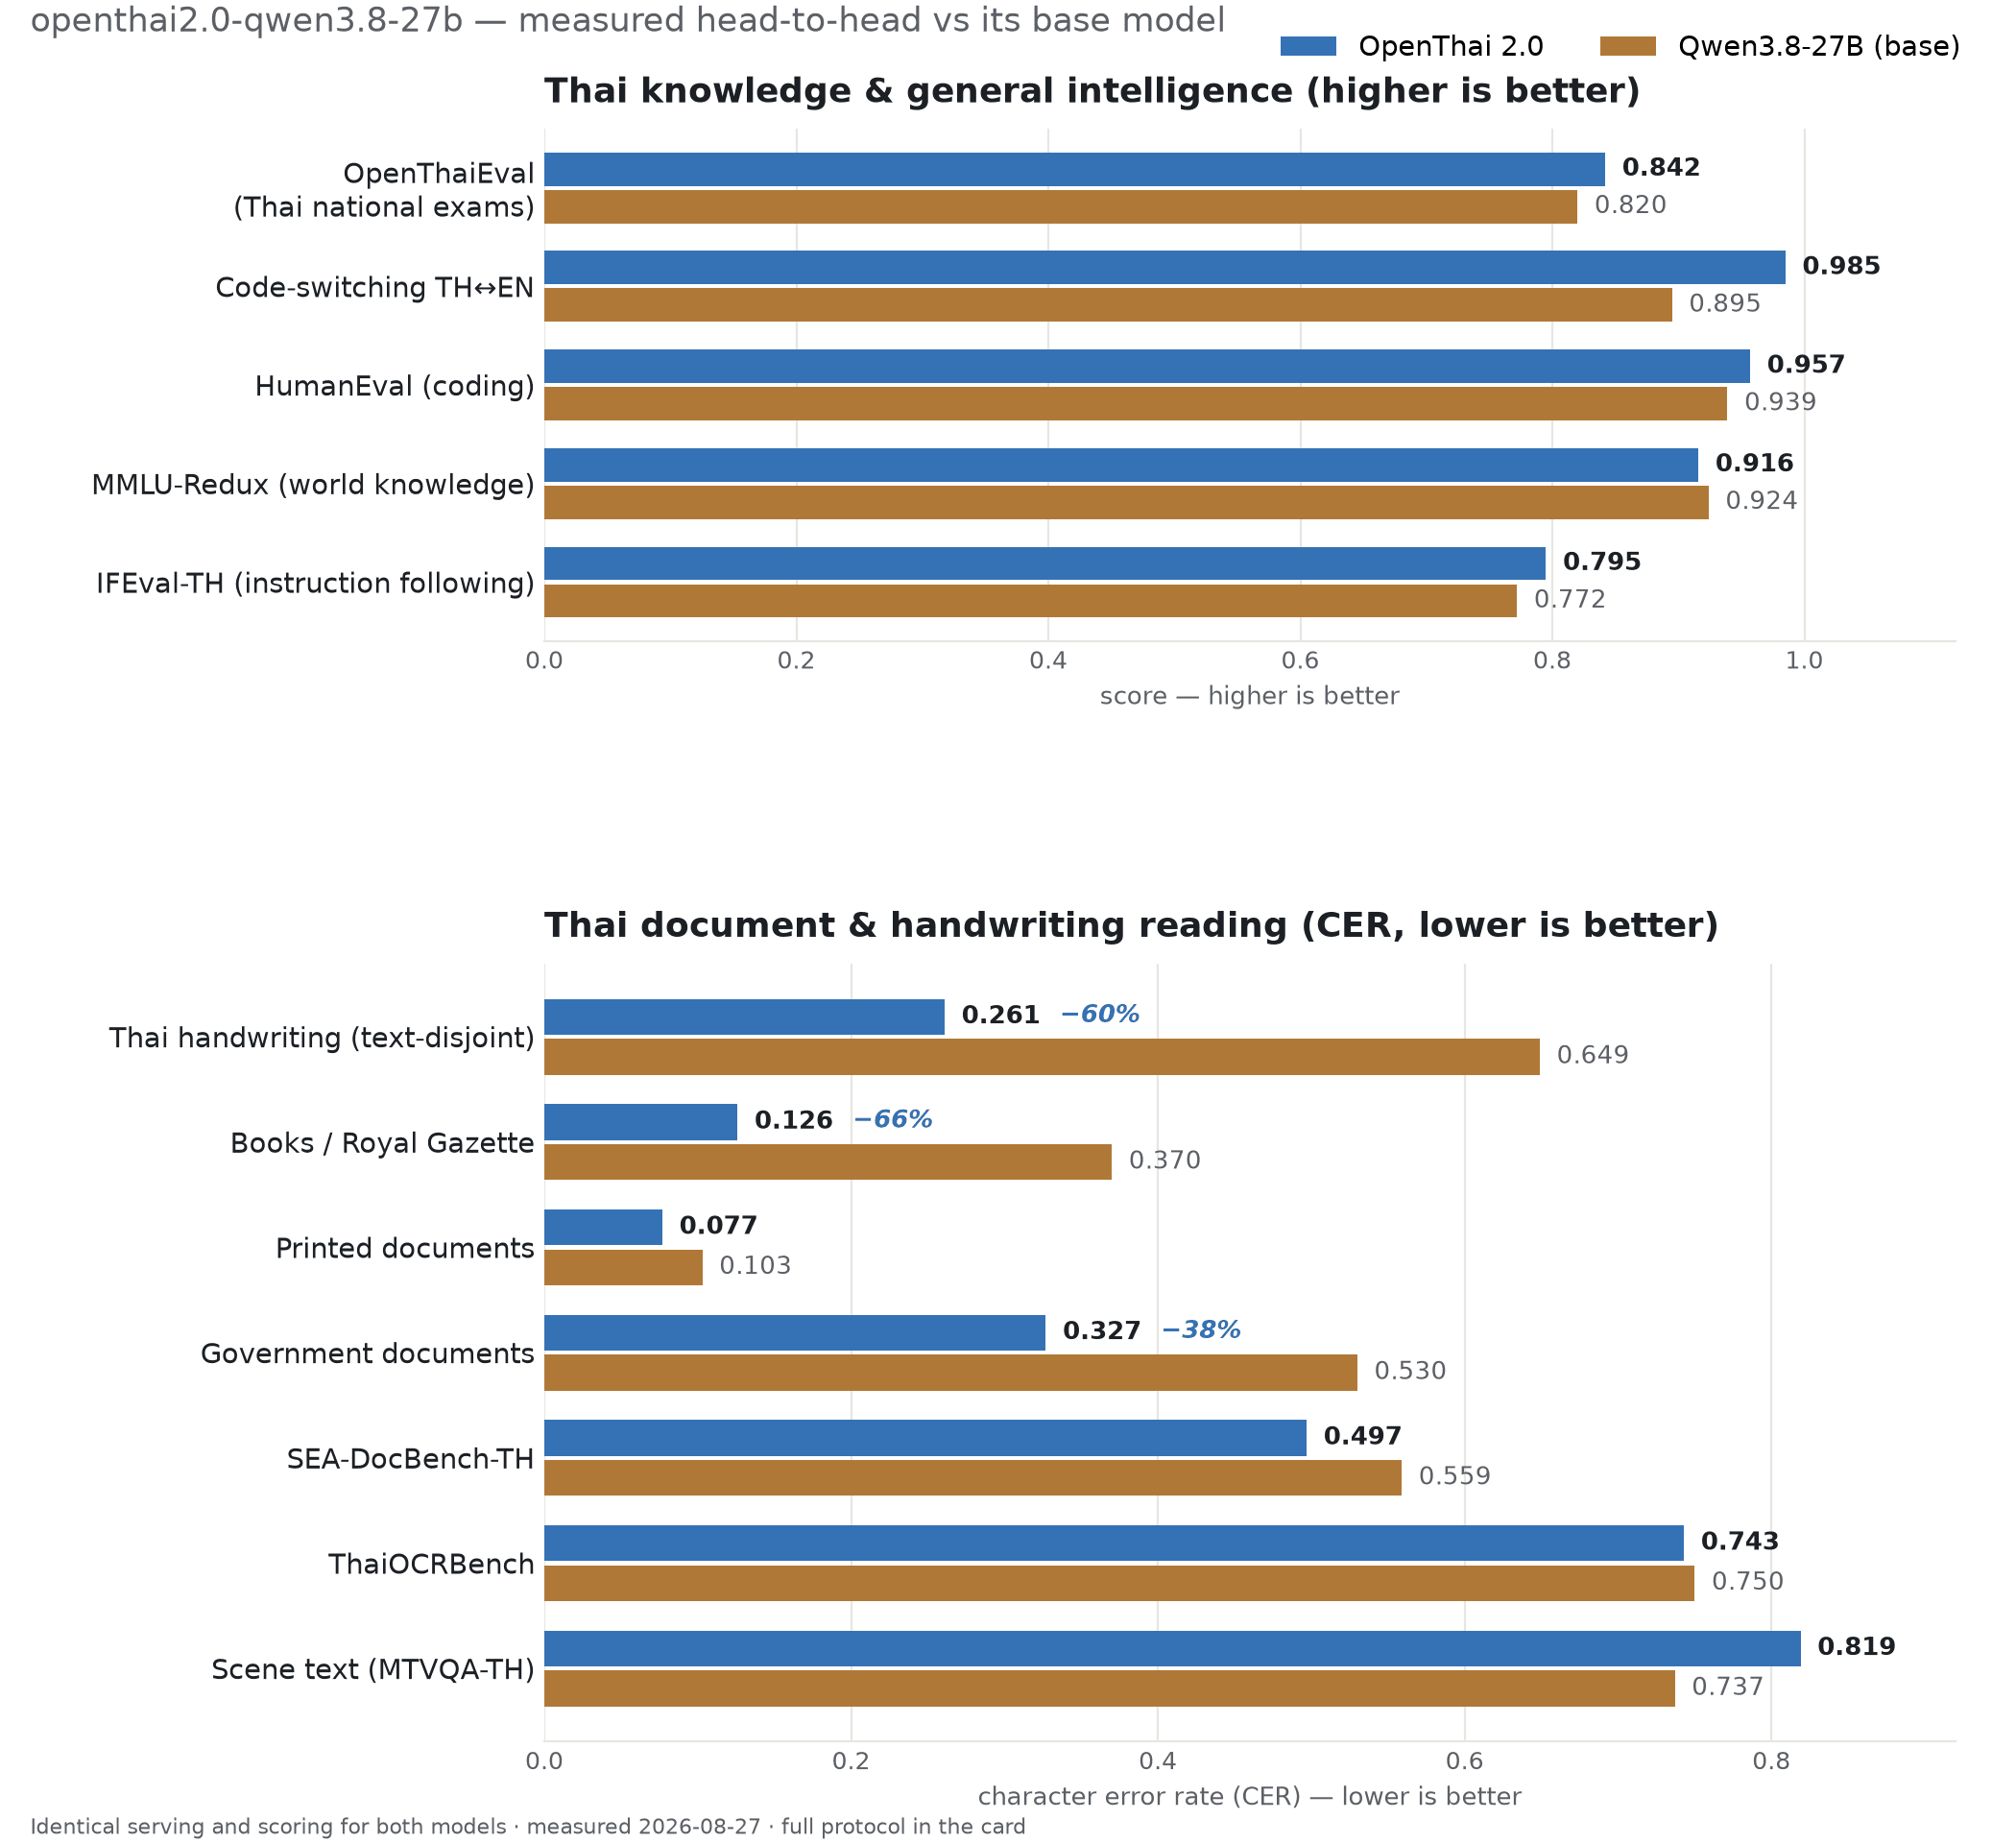
所有数字均由我们在相同的推理服务条件下测得,每个模型使用其官方推荐的提示词与参数,并对所有模型应用同一套答案评分流程 —— 实验可用上面链接的检查点复现。
泰语知识与语言(越高越好)
| 评测 | OpenThai 2.0 (27B) | Qwen3.8-27B(基座) | Typhoon 2.5 (30B-A3B) | Pathumma think 3.0 (8B) |
|---|---|---|---|---|
| OpenThaiEval(泰国国家级考试) | 0.842 | 0.820 | 0.742 | 0.660 |
| 泰英语码切换(n=200) | 0.985 | 0.895 | 0.940 | 0.990 |
| HumanEval(代码) | 0.957 | 0.939 | 0.957 | 0.805 |
| MMLU-Redux(世界知识,5.7k) | 0.916 | 0.924 | 0.884 | 0.762 |
| IFEval-TH(泰语指令遵循) | 0.795 | 0.772 | 0.749 | 0.498 |
| IFEval(英语指令遵循) | 0.914 | 0.902 | 0.846 | 0.630 |
语码切换的 0.985 与 0.990 在 n=200 上仅相差一个样本 —— 属于统计学平局。
泰文文档与手写体阅读(CER — 越低越好)
| 评测 | OpenThai 2.0 (27B) | Qwen3.8-27B(基座) | Typhoon-OCR 1.5 (2B) | Pathumma-vision 2.0 (7B) |
|---|---|---|---|---|
| Wikisource TH — 书籍/公报(n=608) | 0.126 | 0.370 | 0.271 | 0.931 |
| DocBench — 政府文档(n=906) | 0.327 | 0.530 | 0.551 | 0.691 |
| SEA-DocBench-TH(n=1,499) | 0.497 | 0.559 | 0.575 | 0.832 |
| ThaiOCRBench(n=2,808) | 0.743 | 0.750 | 0.793 | 0.894 |
| MTVQA-TH — 场景文字(n=231) | 0.819 | 0.737 | 1.000 | 0.905 |
| 泰文手写体 — 文本不重叠(n=916) | 0.261 | 0.649 | 0.054 | 0.821 |
| OCR-Eval-104 — 印刷体(n=104) | 0.077 | 0.103 | 0.014 | 0.352 |
ℹ️ 诚实地解读对比
Typhoon-OCR 1.5 是一名出色的转写专家 —— 在干净的印刷行与孤立手写体上,它胜过表中包括我们在内的所有模型。但它只是一个转写器:只接受一条固定的 OCR 提示词,因此文档问答与场景文字问题几乎完全失分(MTVQA 1.000),也没有知识或助手能力。OpenThai 2.0 在书籍/公报阅读、泰语知识与指令遵循上领先 —— 是表中唯一既能以专家级水平读文档、又能在同一个模型里回答文档问题的开放泰语模型。场景文字(MTVQA)是它最弱的阅读项。
智能体工具调用 — BFCL(越高越好)
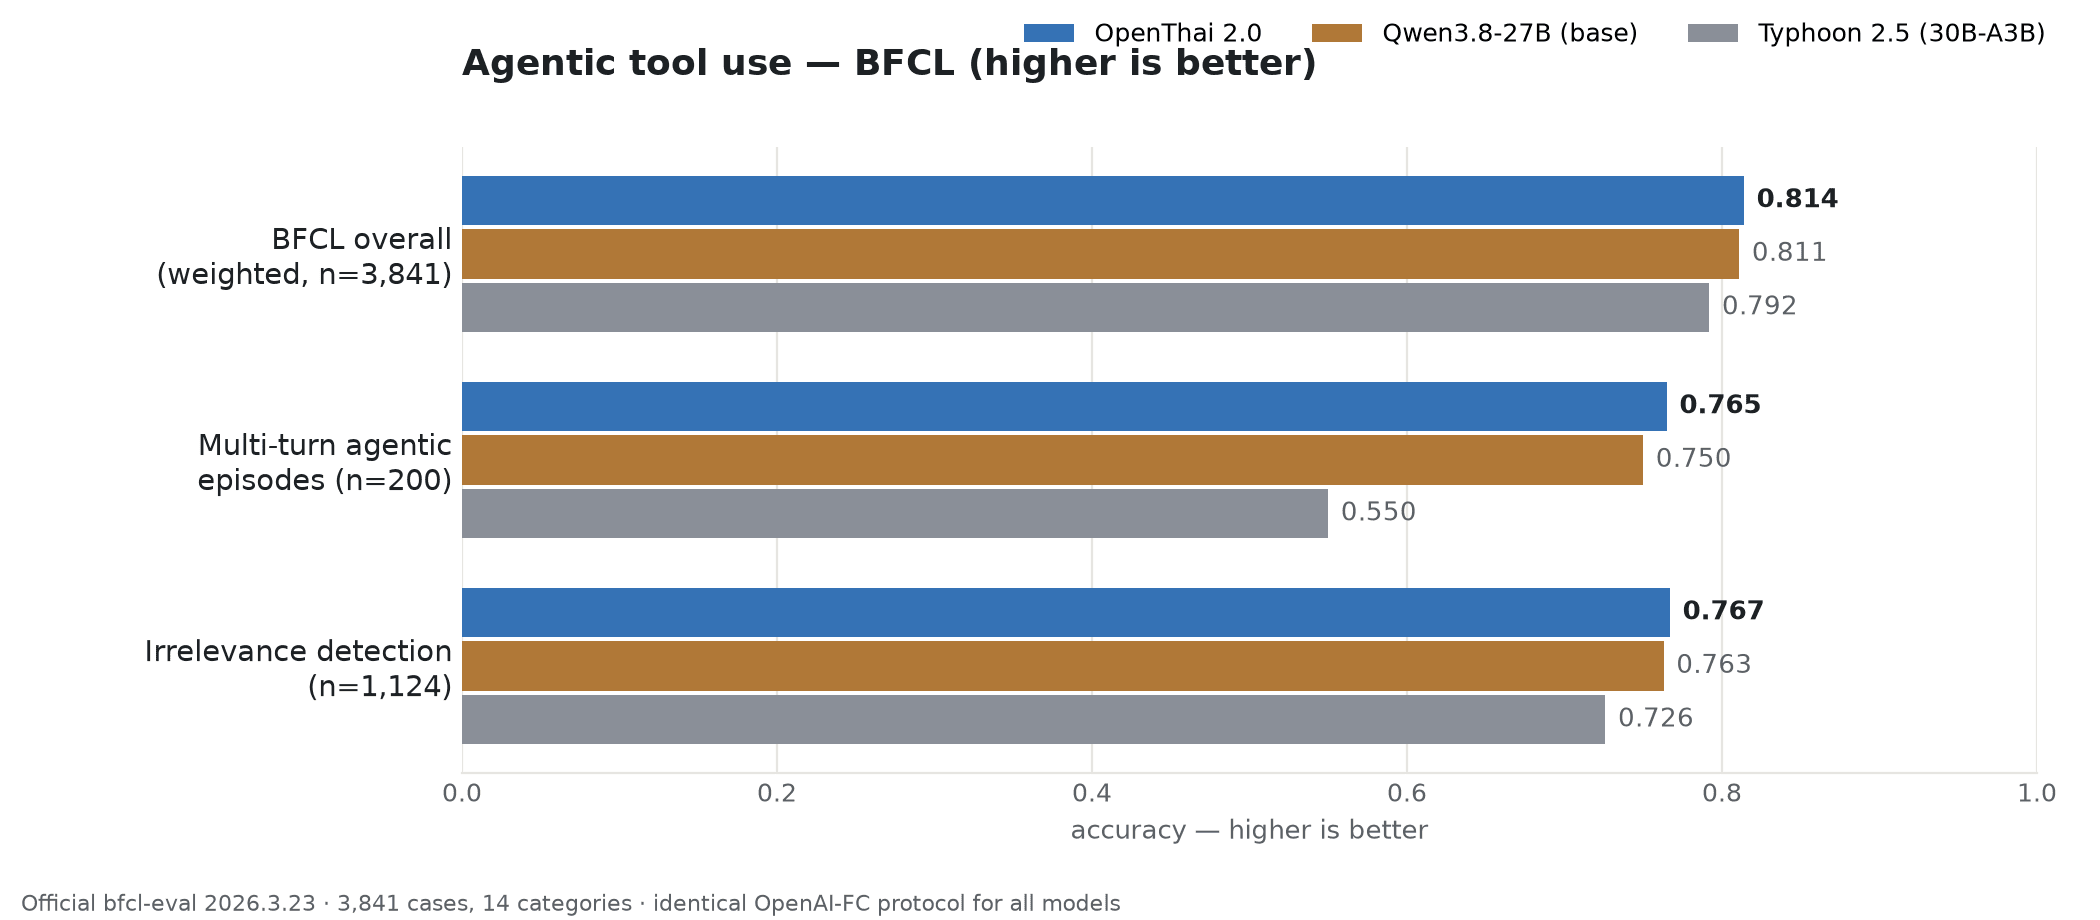
使用 Berkeley Function-Calling Leaderboard 官方评测框架(bfcl-eval 2026.3.23):14 个类别共 3,841 个用例,所有模型采用相同的 OpenAI function calling 协议。
| 评测 | OpenThai 2.0 (27B) | Qwen3.8-27B(基座) | Typhoon 2.5 (30B-A3B) |
|---|---|---|---|
| BFCL 加权总分(n=3,841) | 0.820 | 0.811 | 0.792 |
| 多轮智能体任务(n=200) | 0.775 | 0.750 | 0.550 |
| 判断何时不该调用工具(n=1,124) | 0.779 | 0.763 | 0.726 |
针对泰文文档的微调没有损失工具调用能力:OpenThai 2.0 在每一个汇总行都领先,其中多轮智能体任务差距最大(比 Typhoon 2.5 高 22.5 分)。
🧾 模型详情
| 模型名称 | iapp/openthai2.0-qwen3.8-27b |
| 基座模型 | Qwen/Qwen3.8-27B(稠密 VLM,Mamba-attention 混合架构) |
| 参数量 | 27B |
| 模态 | 图像 + 文本 → 文本 |
| 上下文长度 | 262,144 tokens(max_position_embeddings) |
| 语言 | 泰语(主)、英语 |
| 精度 | bfloat16 safetensors(约 52 GB)+ 独立 LoRA 适配器(7 GB,rank 64)· GGUF / MLX / INT8 / NVFP4 |
| MTP 草稿头 | 内置(1 层)— 自推测解码,约 1.5 倍提速且输出完全一致 |
| 训练栈 | ms-swift 4.3 · LoRA r64/α64 all-linear · 3× NVIDIA H100 |
| 推理服务 | vLLM ≥ 0.19(已验证,OpenAI 兼容) |
| 协议 | Apache 2.0 |
🔬 训练方法
在约 14.3 万条经过验证的数据上进行三阶段 LoRA 微调(r=64,α=64,all-linear):
- 规模化 SFT — 教会阅读 — 经人工核验的转写数据,加上对泰文手写体、书籍、公报与政府文档的讲解式文档问答(92,893 条,2 个 epoch)。
- 知识层 — 教会泰语推理 — 基于泰国法律与政府语料构建的、有出处依据的选择题思维链,并对评测题做泄漏检查。
- 遵循层 — 教会控制 — 只保留答案通过程序化约束检查的指令数据(要点数量、必含词、仅 JSON、长度上限)—— 零幻觉指令数据。
每个阶段都经过全量验证流水线:答案与人工确认的标准答案比对;模型读不清的图片不进入讲解式训练(防幻觉);逐条过滤畸形泰文;语料每次变更都运行基准泄漏防护。
🚀 快速开始
在单张 80 GB GPU 上用 vLLM 部署:
vllm serve iapp/openthai2.0-qwen3.8-27b \
  --max-model-len 32768 --gpu-memory-utilization 0.85 \
  --max-num-seqs 128 --reasoning-parser qwen3 --trust-remote-code
想要约 1.5 倍解码提速且输出完全一致,加上 MTP 参数:
--speculative-config '{"method":"qwen3_5_mtp","num_speculative_tokens":2}'
以 OpenAI 兼容方式调用(示例:读取文档图片):
import base64
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="none")
img = base64.b64encode(open("thai_document.jpg", "rb").read()).decode()

r = client.chat.completions.create(
    model="iapp/openthai2.0-qwen3.8-27b",
    messages=[{"role": "user", "content": [
        {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{img}"}},
        {"type": "text", "text": "อ่านข้อความในเอกสารนี้ทั้งหมด"},
    ]}],
    temperature=0.0,
    extra_body={"repetition_penalty": 1.05,
                "chat_template_kwargs": {"enable_thinking": False}},
)
print(r.choices[0].message.content)
用自然的泰语提问即可获得讲解式回答;需要简短或结构化输出时,加上「ตอบสั้น ๆ」(简答)或「ตอบเป็น JSON เท่านั้น」(仅 JSON)。
⚠️ 给模型留出生成空间 — 头号配置错误
模型先推理再作答,max_tokens 太小会被推理耗尽,回复为空。请以 --max-model-len 32768(或更大)部署,并让 max_tokens 保持未设置或 ≥ 8192。实测:设为 1024 → 约 33% 空回复;不设置 → 约 6%。
部署前须知:
--max-num-seqs 128为必填 — Mamba 混合架构按解码序列分配缓存块,vLLM 默认值(1024)会导致引擎启动失败。- 纯文本请求始终保持 thinking 开启(用
--reasoning-parser qwen3部署)— 仅在附带图片的 OCR/转写请求中关闭 thinking。 - 长篇泰语生成始终发送
repetition_penalty: 1.05。
⚡ 用 TensorFold 运行(Mac 或 NVIDIA)
TensorFold 通过 OpenAI 兼容 API,在 Apple 芯片和 NVIDIA GPU 上部署 MLX 4-bit 检查点 iapp/openthai2.0-qwen3.8-27b-MLX-4bit。它用推测式草稿 token 加速解码,每个草稿 token 都经过模型校验,因此回复与 TensorFold 逐 token 解码该检查点的结果完全相同。同一检查点可在两种后端上运行,并支持图片输入。
以下说明基于 TensorFold v0.6.5。
DGX Spark 及其他 NVIDIA GPU
需要计算能力(compute capability)8.9 或更高:RTX 40 / 50 系列、Hopper、Blackwell,包括 DGX Spark(GB10)。
docker run -it --gpus all --ipc=host --network host \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  nvcr.io/nvidia/pytorch:26.07-py3

# 在容器内
python -m pip install "tensorfold[vision] @ git+https://github.com/ashhart/TensorFold.git@v0.6.5"
tensorfold pull iapp/openthai2.0-qwen3.8-27b-MLX-4bit z-lab/Qwen3.8-27B-DFlash2
tensorfold serve iapp/openthai2.0-qwen3.8-27b-MLX-4bit \
  --name openthai2.0 --host 0.0.0.0 --port 8080 --vision
首次启动会为你的 GPU 编译 CUDA 内核,需要几分钟,仅此一次。加上 --parallel 4 可同时解码最多四个请求。在 CUDA 上必须有草稿模型:按上面的命令拉取,或以 --no-drafts 部署。
Apple 芯片(MLX)
建议 48 GB 或以上统一内存。在 32 GB 的 Mac 上,模型超出 TensorFold 的默认内存预算(RAM 的 70%);可用 TENSORFOLD_MEMORY_LIMIT_GB 调高,但留给其他应用的内存会很少。
python -m pip install "tensorfold[vision] @ git+https://github.com/ashhart/TensorFold.git@v0.6.5"
tensorfold pull iapp/openthai2.0-qwen3.8-27b-MLX-4bit z-lab/Qwen3.8-27B-DFlash2
tensorfold serve iapp/openthai2.0-qwen3.8-27b-MLX-4bit --name openthai2.0 --vision
调用
任何 OpenAI 客户端均可使用,base URL 设为 http://<host>:8080/v1,model 设为 openthai2.0。
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8080/v1", api_key="none")

# 文本
r = client.chat.completions.create(
    model="openthai2.0",
    messages=[{"role": "user", "content": "สรุปสาระสำคัญของ พ.ร.บ. คุ้มครองข้อมูลส่วนบุคคล ใน 3 ข้อ"}],
    max_tokens=4096,
)
print(r.choices[0].message.content)

# 泰语文档图片(data URL;如需接受公开 HTTPS 链接,请以 --vision-urls 启动服务)
import base64
img = base64.b64encode(open("document.png", "rb").read()).decode()
r = client.chat.completions.create(
    model="openthai2.0",
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "อ่านข้อความทั้งหมดในเอกสารนี้"},
        {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{img}"}},
    ]}],
    max_tokens=4096,
)
print(r.choices[0].message.content)
模型默认先思考再作答:推理过程在 reasoning_content 中,答案在 content 中,因此请留足 max_tokens。若要直接作答,请以 --no-thinking 启动服务。
说明
- 草稿模型。
z-lab/Qwen3.8-27B-DFlash2(Apache-2.0)基于 Qwen3.8-27B 基座训练,而非 OpenThai 2.0。它在泰语回复上被接受的草稿 token 更少,因此提速比基座模型小;回复本身不受影响。在请求中发送"draft": false可获得逐 token 解码的参考结果。 - 同一引擎,同一输出。 在该检查点上,TensorFold 内的草稿解码与逐 token 解码结果一致;但与 vLLM 或 transformers 部署的 bf16 模型输出不同,因为权重是 4-bit。
- 为何在 NVIDIA 上也用 MLX 4-bit。 TensorFold 也能在单张 NVIDIA GPU 上读取 NVFP4 检查点,但根据 TensorFold 自己在 DGX Spark 上对 Qwen3.8-27B 基座的测量,MLX 4-bit 检查点解码更快。
⚠️ 局限与负责任的使用
- 结构化抽取仅与基座模型持平,并未更好 — 在判分版 ThaiOCRBench 上为 0.568,对基座的 0.570(统计学平局);失分集中在表格解析、键值映射与图表 VQA。重度表单/表格抽取流水线请先在自己的文档上评估。
- 长篇自由回答在不同生成之间会有波动 — 需要可复现输出时设 temperature 0 加 repetition_penalty 1.05,且无论如何都应独立核实事实。
- 简答指令的遵循率约 40% — 模型默认讲解式风格;需要机器解析的输出请使用明确格式,如「ตอบเป็น JSON เท่านั้น」。
- 场景文字(招牌、店面)是最弱的阅读项 — 招牌照片建议使用基座模型或场景文字专用模型。
- 未评估范围:泰语方言、竖排/旋转文字、医疗或法律建议。手写体依然很难 —— CER 0.261 意味着困难样本上约每四个字符仍错一个;对无法辨认的输入,模型仍可能产生幻觉。
推荐:在事实性与受监管领域搭配 RAG 使用
这个模型最擅长阅读、讲解并回答你提供的文档。税务、法律、医疗等合规敏感工作,请搭配基于权威来源的检索增强生成(RAG)并辅以人工审核,而不要依赖闭卷记忆。
OpenThaiRAG — 泰语原生 RAG 框架openthai.ai/openthairag
法律领域请使用我们专门打造的泰语法律模型:OpenThai 2.0 Legal
🙏 致谢
由 OpenThai 团队(iApp Technology)打造,与**泰国人工智能企业家协会(AIEAT)**联合发布,基于 Qwen/Qwen3.8-27B 基座模型(Apache 2.0)。
训练与评估在 Siam AI Corporation 慷慨提供的 8× NVIDIA H100 GPU 上完成 —— 感谢对开放泰语 AI 的支持。