🎯 泰语版 Jev 来了!OpenThai-SystemOne
发布于 2026 年 9 月 20 日
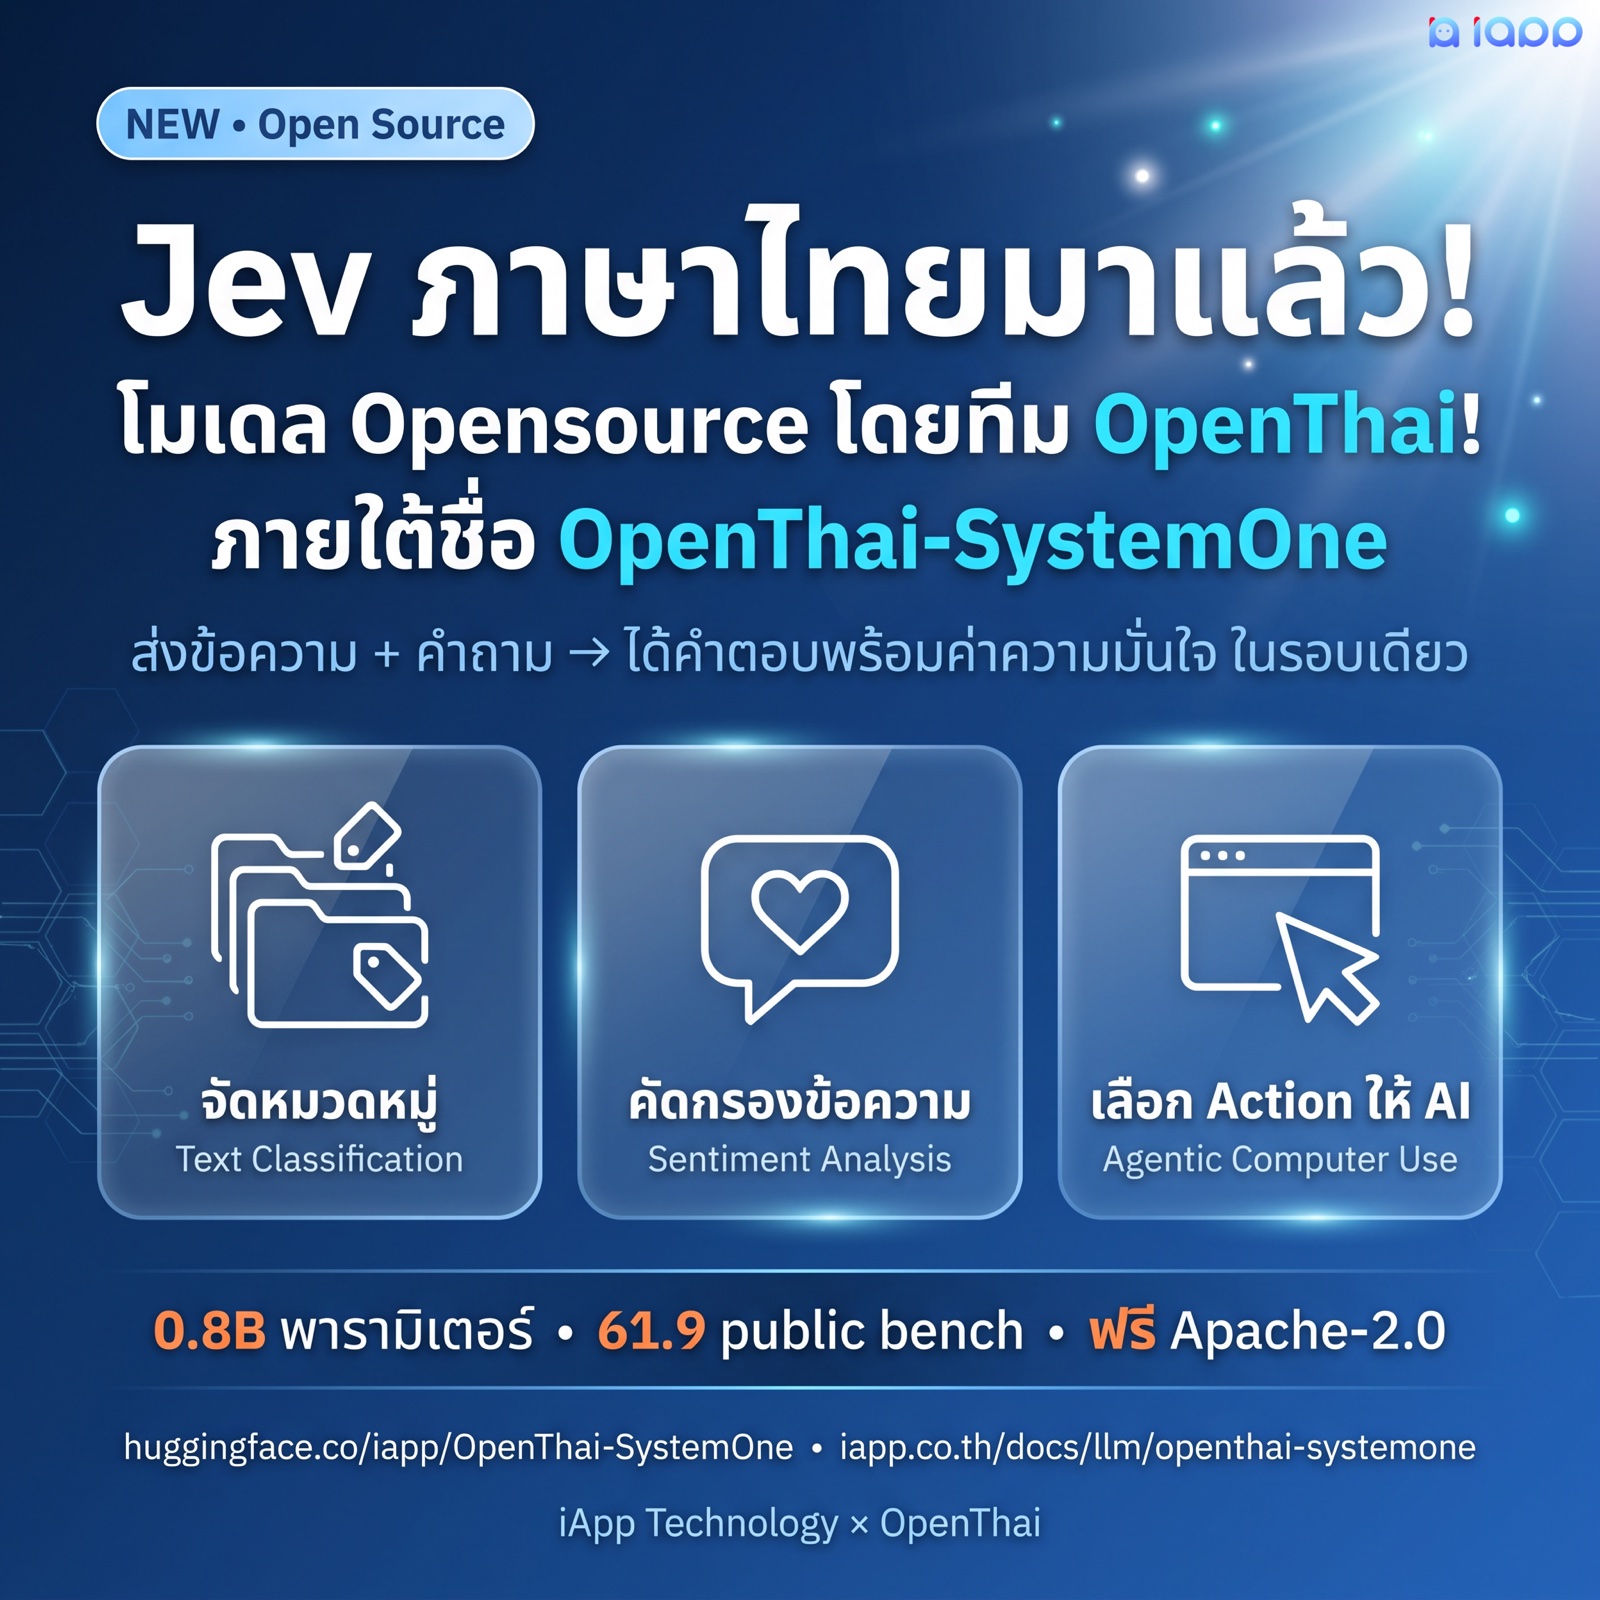
0.8B 参数v0.3公开基准 74.3免费 Apache-2.0泰语 + 英语
输入文本 + 问题 → 一次计算即得带置信度的答案。
TypeSafe 发布 Jev(一种不生成文本、而是一次计算即以概率给出决策的 "System One model")五天之后,OpenThai 团队推出了面向泰语 + 英语的开源版本,命名为 OpenThai-SystemOne。
- 0.8B 参数,可在笔记本上运行
- 基座 Qwen3.5-0.8B,用约 50 亿泰语 token 继续预训练,并把 248k 词表的 LM 头替换为"256 槽位决策头"
- 输入状态(文本/JSON)+ 单选 / 打分 / 是否问题 → 一次前向计算返回所有问题的答案及置信度
- 在与 Bespoke-Nimble-9B 相同的 13 子集公开基准上:我们 74.3(v0.3)/ Nimble-9B 74.8 / Jev 76.0(与 9B 模型仅差 0.5,13 个子集中 8 个领先)。泰语任务:意图 90.0%、新闻主题 98.1%、XNLI-th 77.1%
- 用途:文本分类(Text Classification)、情感分析(Sentiment Analysis)、为 AI 选择动作(Agentic Computer Use)
- Apache-2.0 全部开放:权重、训练脚本、配置与合成数据
API 格式与 TypeSafe AI 的 POST /v1/systemone(Jev)一致,现有代码可直接指向本模型。
在浏览器中试玩
在浏览器中试玩 OpenThai-SystemOne + API 文档iapp.co.th/docs/llm/openthai-systemone
下载与安装
OpenThai-SystemOne — 权重与含基准表的模型卡huggingface.co/iapp/OpenThai-SystemOne
代码、配置与全部训练脚本 — GitHubgithub.com/iapp-technology/openthai-systemone
pip install openthai-systemone # 或:pip install "git+https://github.com/iapp-technology/openthai-systemone"
试一试
模型的真实输出:一条客服工单,两个问题,一次前向计算全部作答(输入 91 token,输出 0 token)。
curl -s https://api.iapp.co.th/v3/store/openthai/systemone -H "apikey: $IAPP_API_KEY" -H "content-type: application/json" -d '{
  "state": {"ticket": "โดนหักเงินซ้ำสองครั้ง ขอเงินคืนด่วน"},
  "questions": {
    "department": {"type": "choice", "instructions": "ทีมใดควรรับผิดชอบ",
                   "criteria": {"billing": "การเงิน/คืนเงิน", "technical": "ระบบใช้งานไม่ได้", "sales": null}},
    "refund":     {"type": "noul", "instructions": "ลูกค้าขอเงินคืนหรือไม่"}
  }}'
{"answers": {"department": {"choice": "billing", "probabilities": {"billing": 0.972, "technical": 0.009, "sales": 0.018}, "confidence": 0.87},
             "refund": {"noul": 0.954}}, "usage": {"input_tokens": 91, "output_tokens": 0}}
🔑 公开 API(免费预览)
端点 https://api.iapp.co.th/v3/store/openthai/systemone 可用任意 iApp API key(免费注册)调用。预览期间 0 积分,每个 key 每天限 1,000 次决策、每分钟 100 次请求;按决策计价将于 2026 年 10 月公布。API 当前运行 v0.3,与 Hugging Face 上的权重为同一检查点。详情与在线试玩见 iapp.co.th/docs/llm/openthai-systemone,也可按下面的方式在自己的机器上运行模型。
本地运行(CUDA、Apple MPS 或 CPU):
from openthai_systemone import SystemOneClient, Choice, Score, Noul

c = SystemOneClient("iapp/OpenThai-SystemOne")
r = c.system_one(
    state={"ticket": "โดนหักเงินซ้ำสองครั้ง ขอเงินคืนด่วน โทรไปสามรอบแล้วไม่มีใครรับ"},
    questions={
        "department": Choice(instructions="ทีมใดควรรับผิดชอบ", criteria={"billing": "การเงิน/คืนเงิน", "technical": "ระบบใช้งานไม่ได้", "sales": None}),
        "frustration": Score(instructions="ลูกค้าหงุดหงิดแค่ไหน", criteria=["ใจเย็น", "หงุดหงิดแต่สุภาพ", "โกรธมาก"]),
        "refund": Noul(instructions="ลูกค้าขอเงินคืนอย่างชัดเจนหรือไม่"),
    },
)
print(r.answers["department"].choice, r.answers["department"].probabilities)
print(r.answers["frustration"].score, r.answers["refund"].noul)
以 HTTP 服务方式运行,接口与 POST /v1/systemone 相同:
OPENTHAI_SYSTEMONE_MODEL=iapp/OpenThai-SystemOne uvicorn openthai_systemone.server:app --port 8000
或直接用 transformers 加载(远程代码随模型仓库提供):
from transformers import AutoModel
model = AutoModel.from_pretrained("iapp/OpenThai-SystemOne", trust_remote_code=True)
🎮 演示:不看画面、不生成文本地玩 Doom
模型实时控制 Doom(ViZDoom)中的角色。每 4 个游戏 tic,引擎的符号状态被序列化为文本,例如:
health 100/100 | ammo 50 | kills 1
crosshair: empty; nearest visible enemy 39deg to the RIGHT
enemies: Zombieman 5m right -39deg VISIBLE; ChaingunGuy 19m right -24deg; Zombieman 19m ahead -12deg
items: GreenArmor 41m right -18deg
depth ahead: 35/255 (obstacle near)
last actions: ATTACK ATTACK ATTACK ATTACK
模型在一次前向计算中回答两个结构化问题:对 7 个动作的 choice(要按下的键)和 "准星中是否有敌人" 的 noul。单张 H100 上每次决策约 41 毫秒(约每秒 24 次决策),输出 token 为 0,且训练中没有任何 Doom 数据:一切都来自阅读状态与选项描述。它会打偏、也会在高难度关卡阵亡;重点在于速度与校准过的概率,这与分流工单或为智能体选择 UI 元素是同一套机制。
在你的机器上运行(iApp API key 或本地权重,泰/英实时 HUD,可选录制):github.com/iapp-technology/openthai-systemone-doom
🇹🇭 泰语任务展示(v0.3 通过 API 的真实输出,2026 年 9 月 22 日)
七个日常泰语任务,每个都在一次前向计算中作答;概率为模型的实际输出。
| 任务 | 状态(节选) | 问题 | 回答 |
|---|---|---|---|
| 工单分流 | "转账 App 从昨晚起一直报 error 502 … 明天要给孩子交学费"(泰语) | 哪个团队(4 个)· 紧急程度(score)· 措辞是否礼貌 | technical 72%(billing 27%)· 2.13 = 紧急(85%)· 礼貌 1%(错误,见注) |
| 新闻主题 | "内阁批准全国最低工资上调至 400 泰铢,1 月 1 日生效;工业联合会担忧影响中小企业" | 主题(8 类)· 是否与劳工相关 | 经济 62%(劳工 36%)· 98% |
| 助手意图 | "帮我设明早六点半的闹钟,醒来时再放点轻音乐" | 意图(10 类) | alarm set 99.5% |
| 评论审核 | 一条辱骂性泰语评论 | 是否有害 · 情感 | 有害 94% · 负面 97% |
| 基于文档的问答 | 关于拉玛八世大桥的段落(2002 年 5 月 7 日通车,长 475 米) | "桥有多长" 可回答 · "是否说明了建设预算" | 98.5% · 0.6% |
| 智能体工具选择 | 任务 "今晚八点订 4 人餐位";历史显示 search_restaurants 已找到空位 | 下一个工具(5 个) | make_reservation 96.5% |
| RAG 相关性 + 抽取 | 关于楼宇租金预扣税的问题;段落写明 5% | 段落是否相关 · 税率 | 98% · 5%(76%) |
第一行的说明:该工单使用了礼貌的 "รบกวน…นะครับ",正确答案应为是,而模型以 99% 回答否。对正式泰语礼貌程度的判断是已知短板,v0.4 将加入针对性数据。我们保留这个失误,因为只展示成功的案例没有意义。
三种问题类型
| 类型 | 你提供 | 你得到 |
|---|---|---|
choice | 指令 + 最多 255 个选项(名称 → 描述或 null) | choice、每个选项的 probabilities、confidence |
score | 指令 + 2–10 个有序等级描述 | score(按概率加权,可为小数)、probabilities、confidence |
noul | 一个是/否问题 | noul = p(是) |
一次请求中的所有问题在同一次前向计算中一起作答。confidence 为 1 − 归一化熵,abstain 为"没有任何选项合适"的概率。
📊 数据(v0.3,2026 年 9 月 22 日)
所有数字均为零样本:模型只看到状态、指令以及选项名称与描述,且均为经过校准的 v0.3 版本的结果;早期版本见下方版本表。
Bespoke Labs 的 13 子集公开基准(与对比 Jev 时相同的数据源、切分、指令和采样器)。choice 与 noul 报告准确率,score 报告等级完全匹配率。粗体为 0.8B 模型领先 Nimble-9B 的子集。
| 子集 | 类型 | n | OpenThai-SystemOne 0.8B | Nimble-9B | Jev 1.13.0 | 我们的 ECE |
|---|---|---|---|---|---|---|
| aegis2 | noul | 250 | 83.2 | 81.2 | 80.4 | 0.065 |
| boolq | noul | 300 | 79.7 | 86.0 | 89.7 | 0.049 |
| civil_comments | noul | 300 | 79.0 | 70.3 | 81.0 | 0.087 |
| helpsteer2 | score | 250 | 41.6 | 39.0 | 34.1 | 0.371 |
| massive-de-DE | choice | 350 | 88.3 | 83.4 | 86.9 | 0.057 |
| massive-en-US | choice | 350 | 88.3 | 86.9 | 87.4 | 0.070 |
| multinli | choice | 299 | 89.0 | 85.3 | 82.9 | 0.053 |
| paws | noul | 250 | 94.0 | 82.8 | 89.2 | 0.035 |
| pubmedqa | choice | 250 | 64.0 | 75.6 | 77.2 | 0.259 |
| squad2 | noul | 299 | 89.3 | 80.6 | 82.9 | 0.041 |
| summeval-consistency | score | 144 | 75.0 | 75.7 | 81.2 | 0.076 |
| summeval-relevance | score | 240 | 21.7 | 49.2 | 35.0 | 0.356 |
| vitaminc-dev | choice | 599 | 72.5 | 76.6 | 80.1 | 0.118 |
| 宏平均 | 74.3 | 74.8 | 76.0 |
如实解读:0.8B 模型宏平均 74.3,与 Nimble-9B(74.8)仅差 0.5 分,并在 13 个子集中的 8 个领先(aegis2、civil_comments、helpsteer2、massive-de、massive-en、multinli、paws、squad2)。仍明显落后的是 pubmedqa(64.0)以及两项摘要打分任务(relevance 21.7;consistency 75.0,较 v0.2 的 84.0 回退)。13 个子集中有 11 个的 ECE 得到改善。Nimble-9B 与 Jev 的数字来自 Bespoke Labs 的公开结果(2026 年 9 月 18 日);我们的数字用 scripts/06_eval.py 在 scripts/06b_public_benchmarks.py 重建的相同子集上测得。注意:自 v0.3 起,SQuAD2、BoolQ、PAWS、Aegis2 与 MASSIVE-de 的训练切分已进入训练数据;基准子集仍仅使用验证/测试切分。作为参照,Bespoke 报告的原始 Qwen3.5-0.8B 45.4 是在其私有的 324 条留出集上测得(Nimble-9B 90.1、Jev 93.2),并非本基准。
泰语留出测试集(完整评测集;标 * 的数据集整体留出;ECE 越低,confidence 越可信):
| 测试集 | 任务 | 准确率 | ECE | 备注 |
|---|---|---|---|---|
| Prachathai67k | 新闻主题(choice) | 98.1 | 0.004 | v0.2:97.6 |
| Prachathai67k | 逐主题是/否(noul) | 94.2 | 0.008 | |
| MASSIVE-th | 60 类意图(choice) | 90.0 | 0.043 | v0.2:88.6 |
| XNLI-th | 自然语言推理(choice) | 77.1 | 0.045 | |
| XNLI-th | 蕴含是/否(noul) | 84.3 | 0.049 | |
| SIB-200 Thai* | 7 类主题(choice) | 77.9 | 0.084 | 从 v0.2 的 74.0 恢复 |
| 泰语对比句对(单一事实翻转) | choice / noul / score | 80.7 / 83.5 / 78.6 | 0.098 / 0.109 / 0.156 | |
| Wongnai | 评论星级 1–5(score) | 63.5 完全匹配(MAE 0.44) | 0.039 | |
| xLAM 工具选择(英语) | 工具选择(choice) | 99.4 | 0.006 | |
| Wisesight* | 4 类社交媒体情感(choice) | 51.6 | 0.353 | 仍是最弱的泰语测试集;请使用顺序不变模式 |
| banking77*(英语) | 77 类意图(choice) | 45.4 | 0.236 | v0.2:37.8(v0.2 顺序不变模式下 61.7) |
在泰语任务及 NLI/主题任务上可以信任 confidence(ECE 不超过 0.05)。英语多级打分任务(helpsteer2、summeval-relevance)的 ECE 仍然偏高,低置信度的案例应转给更大的模型或人工。
顺序不变模式 — 与 Jev 一样,单次前向计算对选项的顺序敏感(在 v0.2 上测得:不超过 10 个选项时随机打乱会使 5–12% 的 argmax 答案翻转,77 类的 banking77 则为 72%)。客户端与 API 提供顺序不变模式,在一次批量计算中对多个循环选项顺序的答案取平均(order_invariant: true / permutations: n,选项超过 10 个的 choice 问题自动启用)。在 360 条泰语留出问题上:翻转率 18.9% → 3.3%,平均概率偏移 0.19 → 0.08,准确率 68.6 → 73.6,banking77 41.7 → 63.3。代价约为 2 倍延迟(批量),usage.input_tokens 不会增加。
延迟 — 3 个问题的请求在 H100 上约 40 毫秒,在 MacBook M3 Max(Apple GPU,MPS)上 154 毫秒;从笔记本经 API 往返含网络约 170–220 毫秒。255 个选项的问题在 H100 上 44 毫秒,在 MacBook 上 1.5 秒。纯 CPU 仍较慢(约 4.6 秒),请使用 GPU 或 MPS。
⚙️ 工作原理

- 骨干 — Qwen3.5-0.8B-Base 的文本塔(24 层,Gated-DeltaNet 与注意力混合,262k 上下文),去掉视觉编码器,再用约 50 亿泰语 token 继续预训练(网页、维基百科、泰英平行语料,以及无障碍树、JSON 等机器状态文本)。
- 决策头 — 248k 词表的 LM 头被替换为 256 路槽位头。每个选项由控制 token
<|ts_opt_0|> … <|ts_opt_254|>引入;每个问题<|ts_answer|>位置的隐状态被投影为 256 个 logit,超出选项数的槽位被掩码,softmax 给出分布。槽位 255 为 abstain(没有选项合适)。 - 读取答案 —
choice= argmax,score= 在有序等级上的 Σ pᵢ·i,noul= p(是)。 - 无位置偏差 — 训练时打乱选项顺序并混入 abstain 样本,因此这是架构层面的设计,而不是读取 A/B/C 字母 logprob 的技巧。
🔬 训练流程
每个阶段都在 GitHub 仓库中,一个阶段一个脚本,单张 H100 即可复现。
scripts/00_prepare_base.py— 去掉 Qwen3.5-0.8B 的视觉编码器,保留文本塔(752M 参数)。scripts/01_cpt_data.py+scripts/02_cpt_train.py— 以泰语为主的继续预训练(过滤后的 FineWeb-2 泰语、泰语维基百科、泰语指令与摘要文本、OPUS 泰英平行语料、FineWeb-Edu 回放、合成无障碍树与 JSON)。单张 H100 约 40 小时,留出集困惑度 31.4 → 5.38。scripts/03_decision_data.py— 从 21 个公开数据集转换出 181 万条决策记录(泰语:wisesight*、wongnai、prachathai、XNLI-th、MASSIVE-th、SIB-200*、ThaiExam、iapp_wiki_qa、Thai toxicity;英语:MNLI、MMLU、ARC、HelpSteer2、AG News、DBpedia、CLINC、banking77*、Mind2Web、xLAM tools)。标 * 的数据集整体留出仅用于评测。scripts/03b_synth_generate.py— 用 Qwen3.6-35B-A3B 生成约 10 万条合成泰/英决策任务,逐条盲标复核并过滤答案泄漏(数据集iapp/openthai2.0-systemone-synth)。scripts/04_decision_train.py— 换头 + 12k 步 SFT,随后进行校准阶段(Brier 损失 + 按问题类型的温度),使更高的 confidence 确实对应更高的准确率。v0.2 在 v0.1 基础上继续训练 3,000 步,使用 22k 条合成泰语社交媒体情感数据(含"提问"类的 4 类、3/5 类变体、是/否标记、5 级打分),然后重新校准。v0.3 在 v0.2 基础上继续训练 5,000 步,使用 177k 条真实训练切分记录(SQuAD2、BoolQ、PubMedQA-artificial、PAWS、Aegis2、ToxicChat、XQuAD-th、MASSIVE-de)和 78k 条针对弱项的合成记录(基于文档的是/否问答、摘要打分、40–120 类近似重复意图、安全判断、对抗性改写),情感数据集权重由 4× 降至 2×,然后重新校准。scripts/06b_public_benchmarks.py— 重建 Bespoke Nimble 的 13 子集公开基准,以便同口径比较。
👨👩👧 OpenThai 2.0 家族
| 模型 | 用途 | 规模 | 状态 |
|---|---|---|---|
| OpenThai 2.0 | 泰语对话/推理 LLM,支持图像 | 27B | 已发布 |
| OpenThai 2.0 Legal | 面向 RAG 的泰国法律模型 | 30B-A3B | 已发布 |
| OpenThai-SystemOne | 泰英决策模型(不生成文本) | 0.8B | 已发布 |
| OpenThai-SystemOne CPT | 其底层的泰语继续预训练基座(研究用途) | 0.8B | 暂未公开 |
⚠️ 局限
- 版本 0.3 — 0.8B 模型不是推理模型,不会做多步验证或算术。
- 只能在给定选项中作答,但仍可能出错 — 它无法输出不存在的选项,但可能选错。请使用
confidence字段,把低置信度的案例转给更大的模型或人工。 - 仅支持文本 — 不接受图像。每个问题最多 255 个选项(更多请分组),每次请求最多 64k token。
- 纯 CPU 仍较慢 — 请使用 GPU 或 Apple MPS。
- v0.3 已知弱项 — 两项 5 级打分任务(摘要相关性 22、有用性 42)、细粒度 77 类英语意图(banking77 单一顺序 45)、泰语社交媒体情感(Wisesight 52)、PubMedQA 三分类(64),以及正式泰语的礼貌判断(v0.4 将加入针对性数据)。
- 对选项顺序敏感 — 与 Jev 一样,单次计算的答案在打乱选项后可能改变。请使用
order_invariant: true(超过 10 个选项时自动启用),代价约为 2 倍延迟。 - 英语校准弱于泰语 — ECE 中位数 0.15,泰语不超过 0.05,因为训练数据有意以泰语为主。
🗓 版本
| 版本 | 日期 | 变更 | 公开基准宏平均 | Wisesight |
|---|---|---|---|---|
| v0.3 | 2026-09-22 | 在 v0.2 基础上继续 SFT 5,000 步,使用 177k 条真实训练切分记录 + 78k 条针对弱项的合成记录(基于文档的问答、摘要打分、细粒度意图、安全、改写),并重新校准 | 74.3 | 51.6 |
| v0.2 | 2026-09-21 | 在 v0.1 基础上用 22k 条合成泰语社交情感数据继续 SFT 3,000 步并重新校准;客户端与 API 加入顺序不变模式 | 63.2 | 51.5 |
| v0.1 | 2026-09-20 | 首次发布:泰语 CPT 44.7 亿 token、12k 步 SFT、校准 | 61.9 | 38.7 |
v0.3 使 SQuAD2 50.2 → 89.3、PAWS 68.0 → 94.0、Aegis2 61.6 → 83.2、MASSIVE-de 67.4 → 88.3、BoolQ 64.7 → 79.7、MASSIVE-en 79.1 → 88.3、PubMedQA 56.4 → 64.0、SummEval-relevance 14.2 → 21.7、VitaminC 68.6 → 72.5、MultiNLI 87.3 → 89.0,13 个子集中 11 个的 ECE 得到改善。SummEval-consistency 回退 84.0 → 75.0(合成一致性数据仅覆盖 1/3/5 级,将补充 2/4 级)。泰语留出测试集全部持平或上升(SIB-200 74.0 → 77.9、banking77 37.8 → 45.4)。完整变更记录见模型卡。
🤝 一起完善它
- 更多泰语测试集 — 尤其是选项很多的任务和 UI/智能体任务。欢迎在 GitHub 提 issue。
- GGUF / ONNX / MLX — 决策头只是普通的 Linear 层,熟悉工具链的朋友可以帮忙转换。
- 领域 LoRA 适配器 — 欢迎分享,计划是"一个基座,N 个适配器"。
- 欢迎到 OpenThaiGPT Discord 和 Facebook 群组交流。
📄 许可与致谢
Apache-2.0。由 iApp Technology / OpenThaiGPT 基于 Qwen3.5-0.8B-Base(Apache-2.0)构建。灵感来自 TypeSafe AI 的 System One 模型(Jev);本模型是独立的开放复现,与 TypeSafe AI 无关。
🙏 感谢 Siam AI
泰语继续预训练、SFT 与全部评测均在 Siam AI Corporation 慷慨提供的 NVIDIA H100 GPU 上完成。感谢其对开放泰语 AI 的持续支持。