升级了!OpenThai 2.1 OCR 能读手机拍摄的文档照片了,因真实用户而变得更好
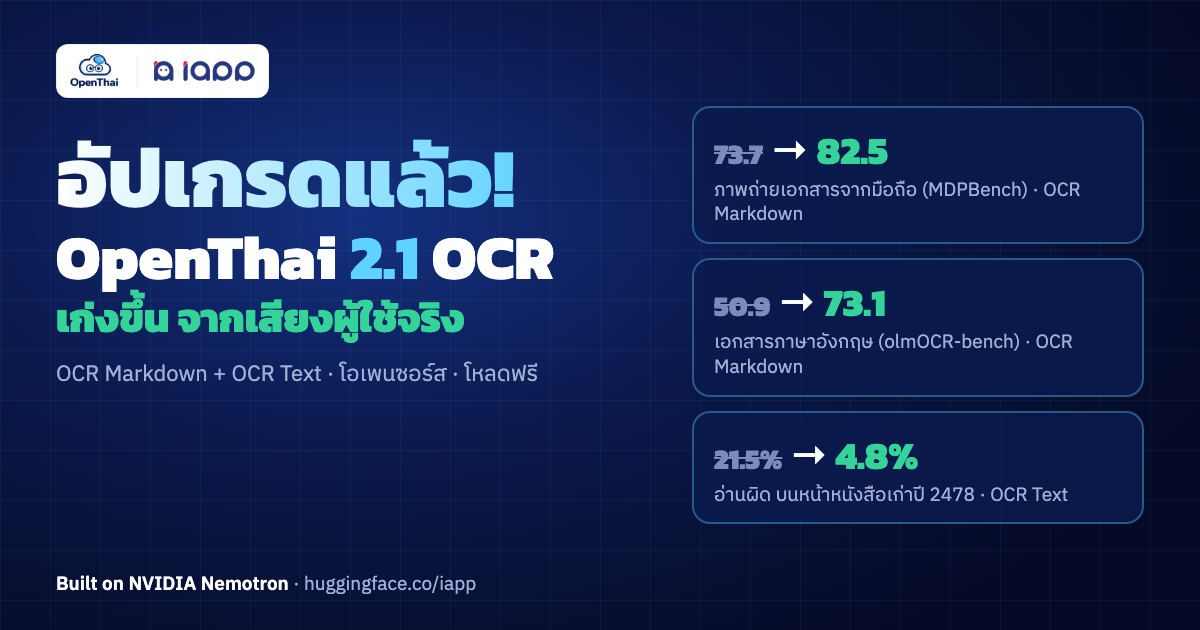
升级了! OpenThai 2.1 OCR 能读手机拍摄的文档照片了,数学公式输出为 LaTeX,在 CPU 上运行的小模型也因真实用户的反馈而变得更好。依旧免费,允许商用。
六天前我们发布了 OpenThai 2.0 OCR,很多人把它用在了实际工作中:在浏览器里识别文档的网站、Windows 应用,以及在近千页政府文件上的测试。评论中提到的每个问题,团队都修复了。以下是 2.1 版的改进。
1) OpenThai 2.1 OCR Markdown(文档页面转 Markdown,表格仍是表格)
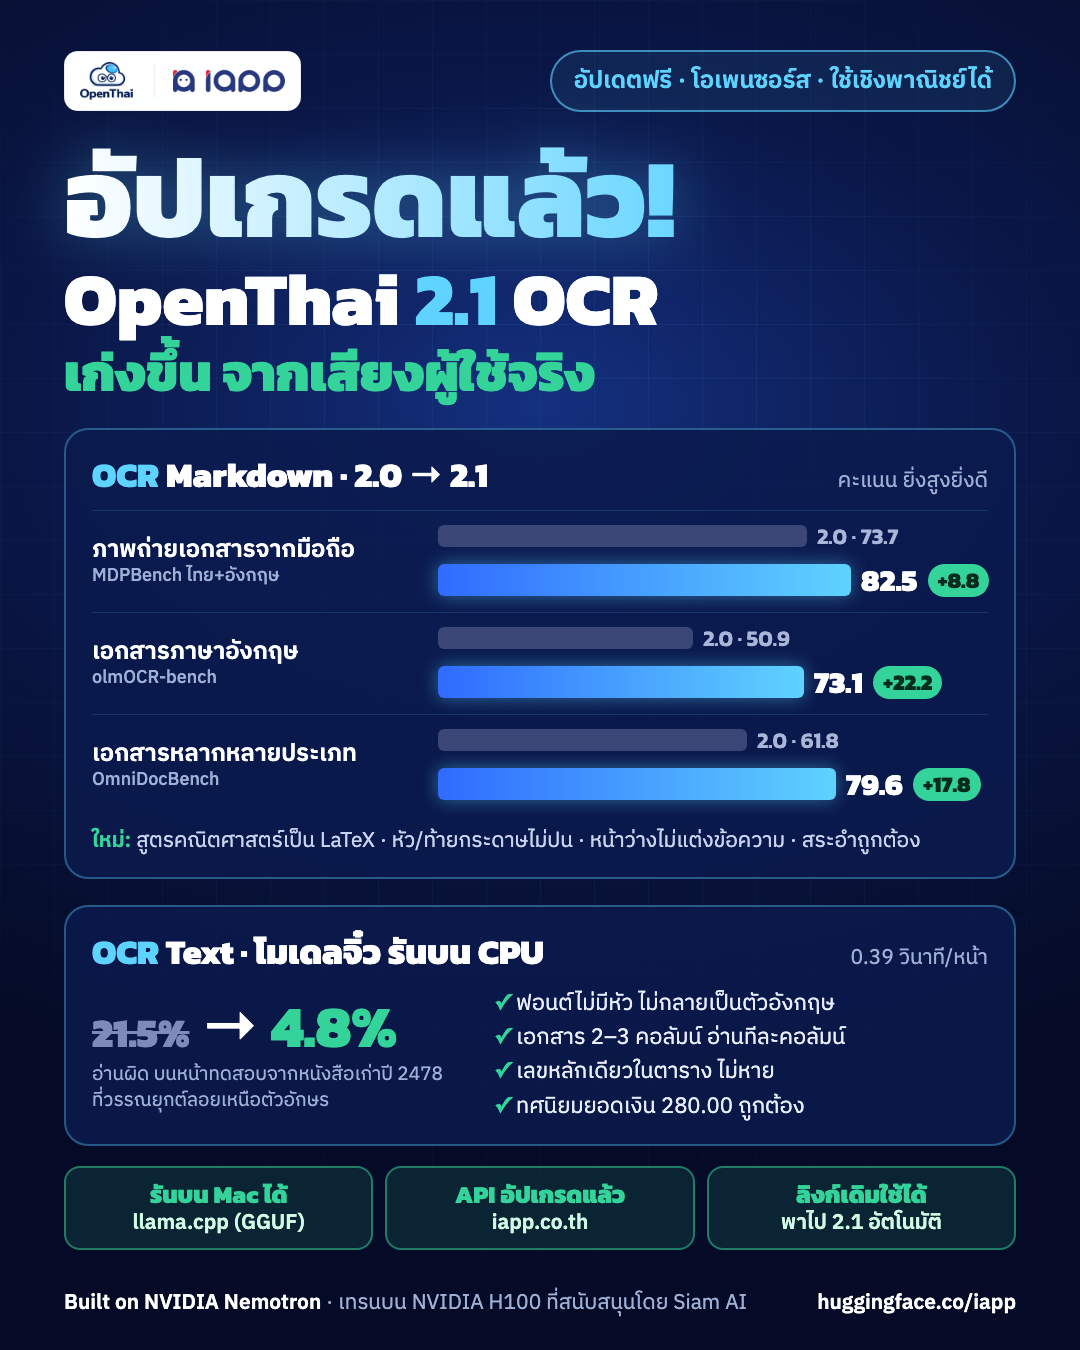
- 手机拍摄的文档照片(MDPBench,泰语与英语):73.7 提升到 82.5
- 仅泰语:72.7 提升到 80.7
- 英文文档(olmOCR-bench):50.9 提升到 73.1
- OmniDocBench:61.8 提升到 79.6
- 支持更多类型的页面:学术论文、书籍、漫画、试卷、杂志、报纸、报告、幻灯片和教科书
- 公式输出为 LaTeX,页眉页脚不再混入正文,空白页不再生成虚构文字,ำ 书写正确
- 泰国政府文件表格依旧准确(94.0,高于 Typhoon OCR V2 2B 的 91.6)
- 规模不变,0.63B;速度不变,H100 上每页 1.5 秒
- 新增: 可通过 llama.cpp(GGUF)在 Mac 上运行,M3 Max 上约每页 6 秒,无需 vLLM
2) OpenThai 2.1 OCR Text(6.6 MB 的小模型,在 CPU 上运行)
- 声调符号悬浮的旧书:在 1935 年一本书的测试页上,错误率从 21.5% 降到 4.8%
- 无头字体(Kanit、Prompt、Sukhumvit Set)不再被读成拉丁字母
- 两栏和三栏页面按栏读取,不再混在一起
- 表格中的单个数字(数量 2)、M T W 等星期代码以及金额中的小数,不再丢失或出错
- Mac 与 Windows 上内存占用更少
- 速度不变:每页 0.39 秒,无需 GPU,无需联网
坦白说: 在手机照片、英文页面和公式上,Typhoon OCR V2 2B 仍然领先我们(MDPBench 87.0)。下一版团队正在收集真实的泰语文档照片。
感谢所有试用并反馈的朋友,无论是在评论区还是在 GitHub 上。这一版的每一项修复都来自真实用户。
正在使用 2.0? 旧链接仍然可用,会自动跳转到新版本。想保留 2.0,下载时传入 revision="v2.0.0" 即可。
免费下载:huggingface.co/iapp/OpenThai2.1-OCR-Markdown-20261118 与 huggingface.co/iapp/OpenThai2.1-OCR-Text-20261118 适用于 Mac 与 CPU 的 GGUF:huggingface.co/iapp/OpenThai2.1-OCR-Markdown-20261118-GGUF 不想自己维护 GPU?API 已升级到 2.1,每页 0.15 IC:iapp.co.th/docs/ocr/document-markdown 完整结果、使用方法与局限:OpenThai 2.1 OCR 模型页
Built on NVIDIA Nemotron · 在 Siam AI 支持的 NVIDIA H100 GPU 上训练