OpenThai 2.0:一个开放模型,读泰文文档、懂泰国、还能调用工具
今天我们公开 OpenThai 2.0(openthai2.0-qwen3.8-27b)的模型权重。这是一个 27B 模型,以 Apache 2.0 许可发布,可在 Hugging Face 免费下载,研究与商业用途皆可。
它的特别之处不在于某一项分数,而在于三种能力共存于同一套权重之中——阅读泰文文档与手写体、回答泰国相关知识、以及作为智能体调用工具——无需独立的 OCR 环节,也不必在系统之间传递数据。
为什么"单一模型"很重要
如今大多数泰文文档系统都是流水线:先把图像送进专用 OCR 模型得到文本,再把文本交给第二个大模型回答问题。每一个接缝都是信息流失的地方——版式丢失、表格错乱、识别环节的置信度传不到回答环节。而当答案出错时,你无法判断是读错了还是答错了。
在我们的对比中,OpenThai 2.0 是唯一一个既能以接近专用模型的水平阅读文档、又能自行回答文档相关问题的开放泰语模型。像素与知识共享同一套权重。
关键数据
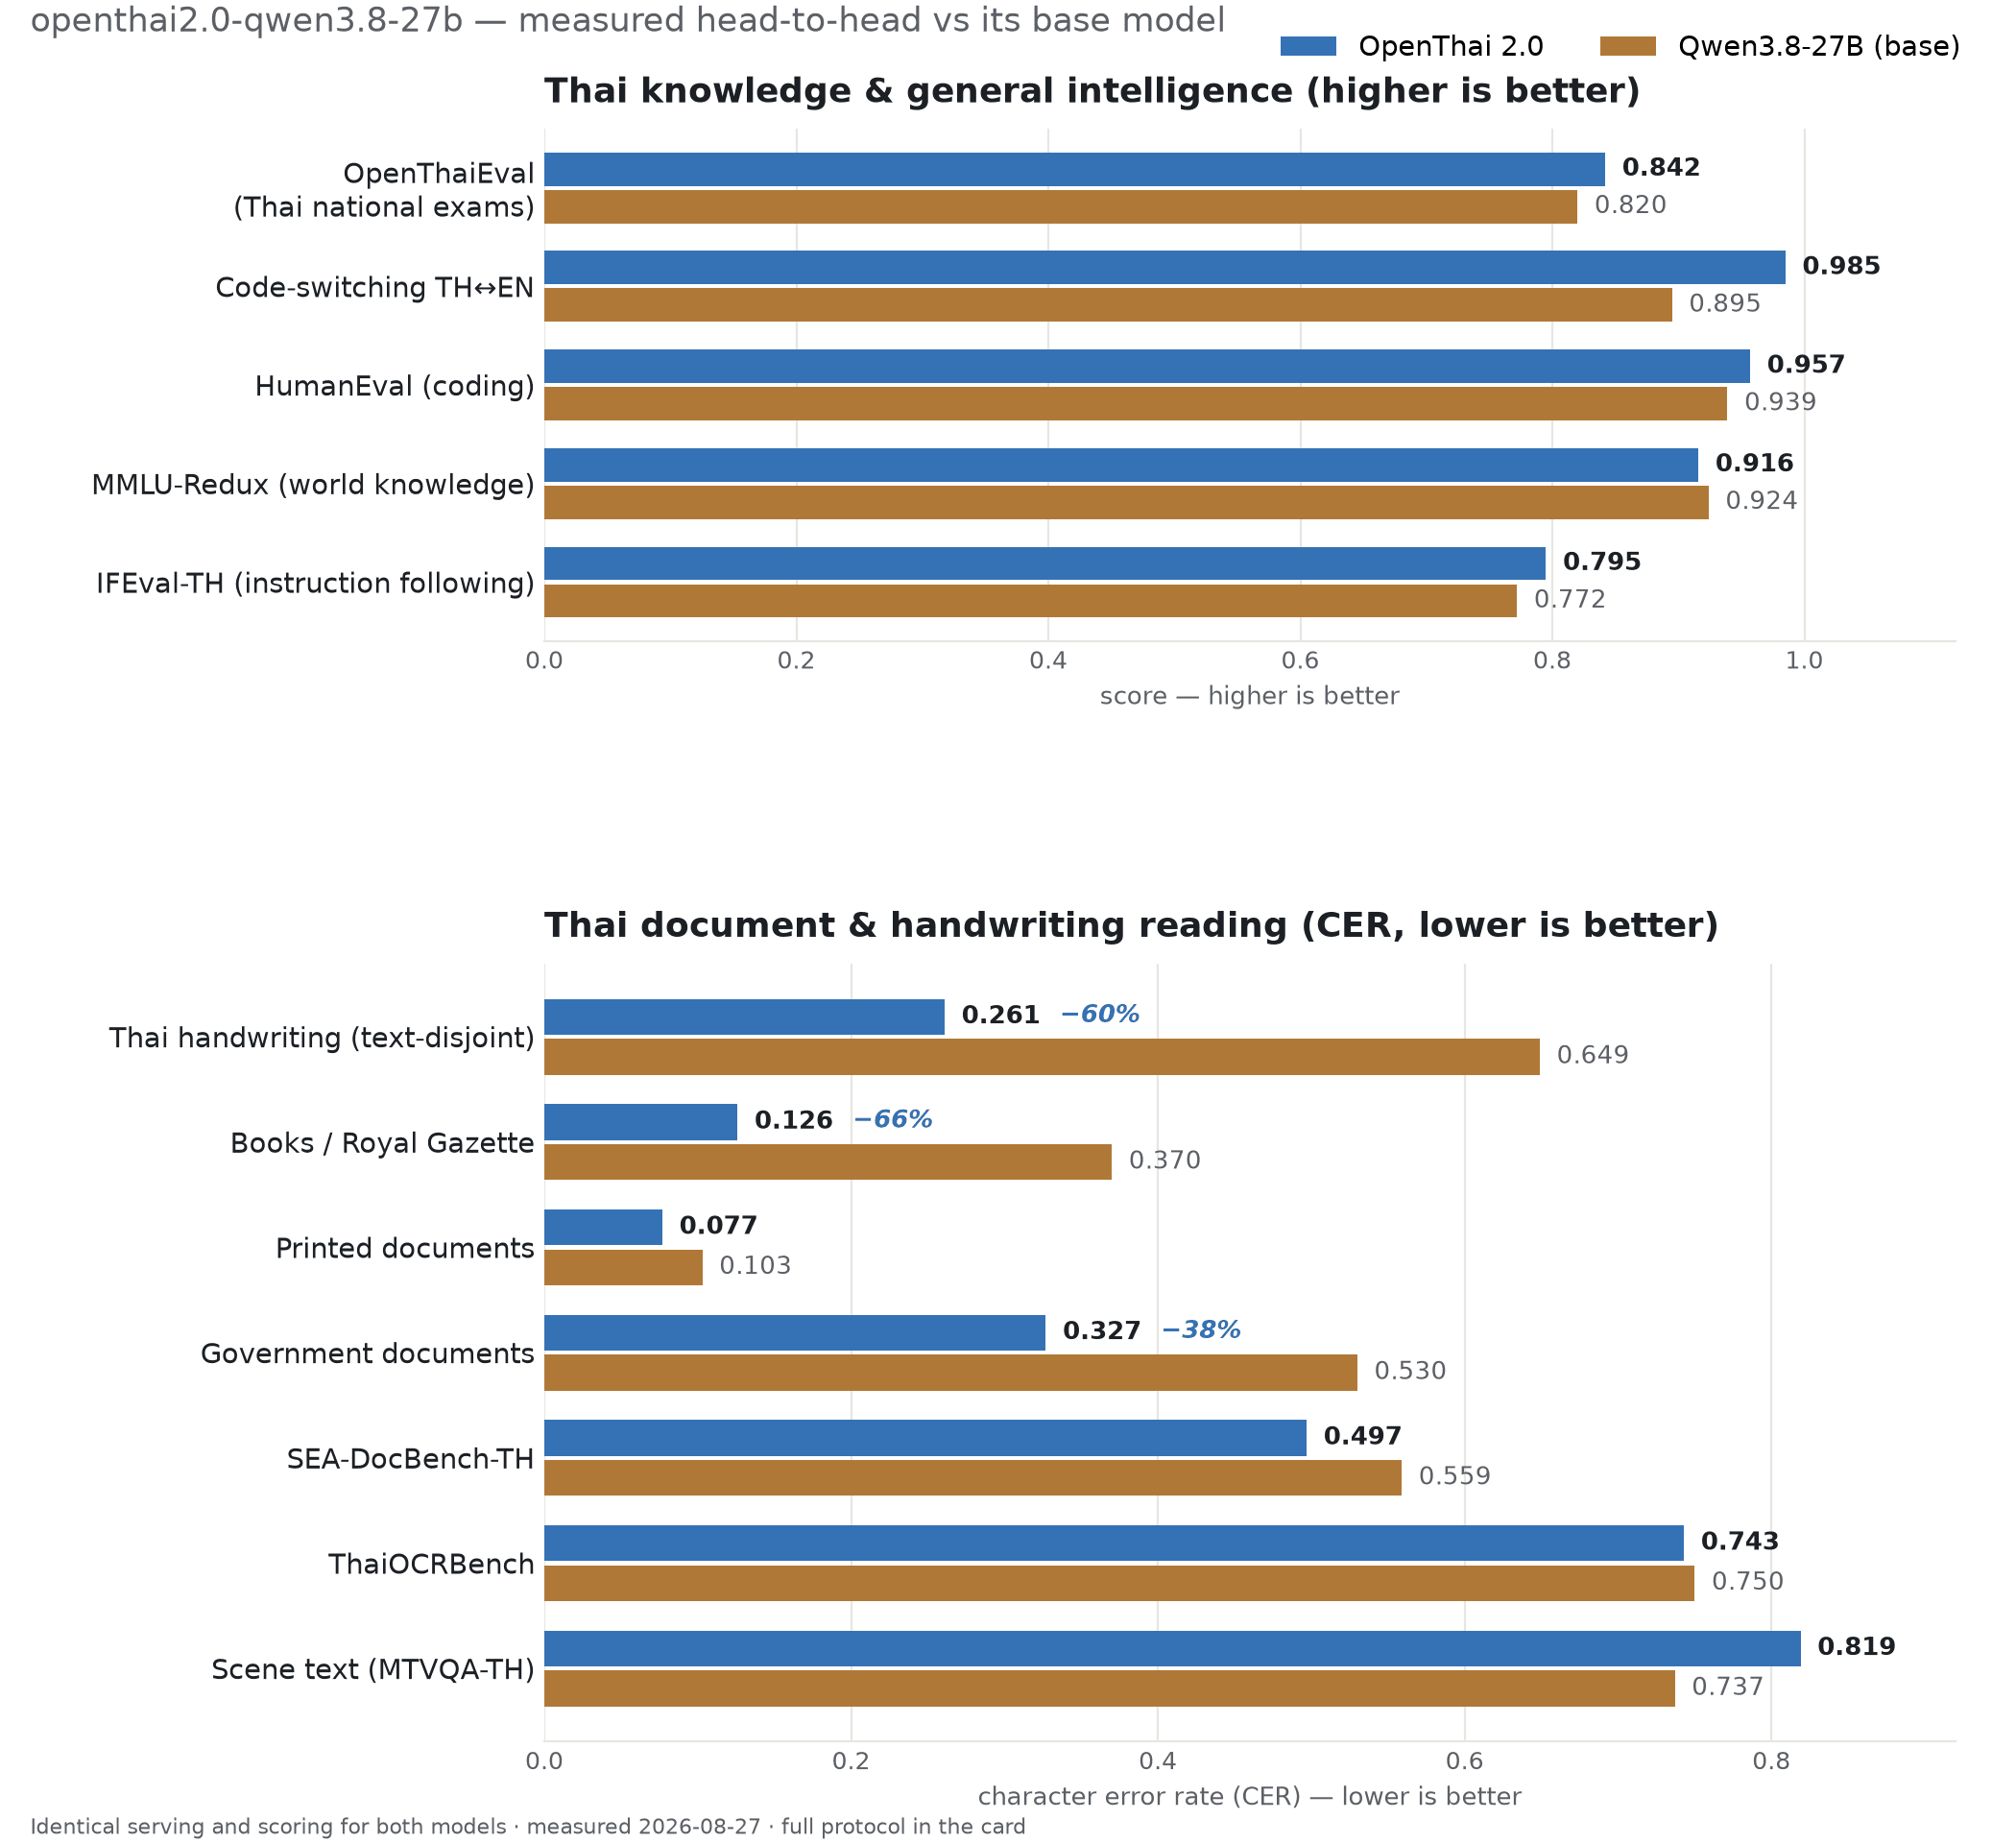
泰文手写体。 字符错误率(CER)从基座模型的 0.649 降至 0.261,错误减少 60%。书籍与皇家公报为 0.126,而基座模型为 0.370,降幅 66%。
泰国知识。 在泰国国家级考试题集 OpenThaiEval 上取得 0.842,高于基座模型(0.820)、Typhoon 2.5(0.742)与 Pathumma(0.660)。泰语指令遵循(IFEval-TH)达到 0.795。
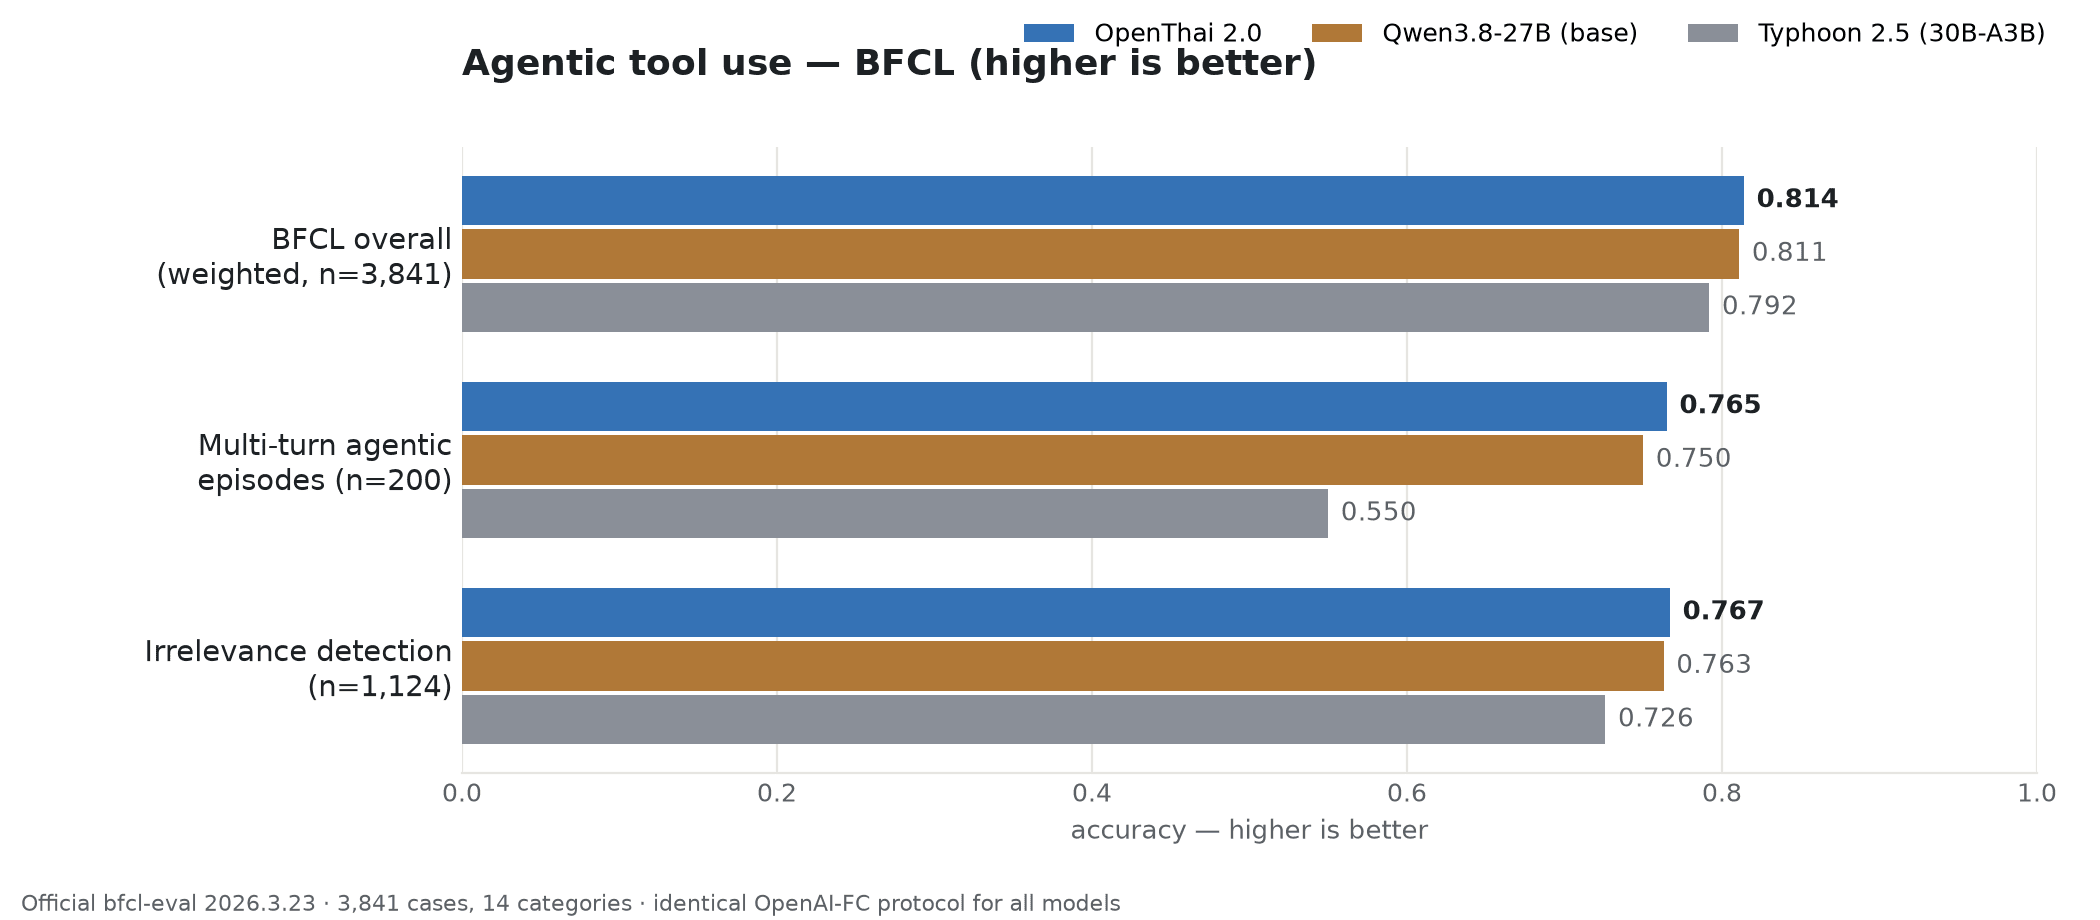
智能体能力。 在 Berkeley Function-Calling Leaderboard 上取得 0.820,领先基座模型(0.811)与 Typhoon 2.5(0.792)。差距最大的是多轮智能体任务:0.775 对 Typhoon 的 0.550,相差 22.5 分。
还有一点我们同样看重:针对泰文文档的微调并未削弱模型的其他能力。 它在 HumanEval 上的代码能力仍为 0.957,英文通识(MMLU-Redux)为 0.916,接近基座模型的 0.924。
这个模型的不足
我们宁愿你如实读到结果,而不是只看到好看的那部分。
在纯转写任务上,Typhoon-OCR 1.5 仍然胜过我们。 在干净的印刷体行与文本无重叠的手写样本上,它优于表中所有模型,包括我们的。但它只能转写——只接受一种固定的提示形式,无法回答文档问题,也不具备知识或助手能力。
场景文字是我们最弱的阅读能力。 如果你的场景是招牌或店面照片,建议改用基座模型或专门的场景文字模型。
模型默认以解释性方式作答。 要求简短回答的成功率只有约 40%。若输出需要由程序解析,请明确指定格式,例如"只返回 JSON"。
手写识别依然是真正的难题。 CER 0.261 意味着在困难样本上仍有约四分之一的字符出错,且当原文难以辨认时模型可能自行编造文字。涉及事实性与合规性的工作,请配合检索增强(RAG)与人工复核。法律领域请使用专门构建的 OpenThai 2.0 Legal。
快速上手
最快的方式是 Ollama,一条命令即可:
ollama run openthai/openthai2.0-qwen3.8-27b
我们提供五种格式,覆盖从 MacBook 到 NVIDIA Blackwell 服务器的全部场景——bf16、GGUF(17/29 GB)、面向 Apple silicon 的 MLX 4-bit、INT8 W8A8 与 NVFP4——另有独立的 LoRA adapter(7 GB,rank 64),供希望以动态 LoRA 在基座模型上部署的用户使用。
该检查点还内置了多 token 预测头。在 vLLM 中开启自推测解码后,我们实测达到 75.2 tokens/秒,而未开启时为 50.1(H100 上快 50%),且输出逐 token 完全一致,因为主模型会校验草稿头提出的每一个 token。
如果你完全不想自己跑 GPU,iApp 提供 OpenAI 兼容的托管 API,在 2026 年 9 月 30 日前免费,只需申请一个免费 API key。
自行部署前请注意
不要把 max_tokens 设得过低——模型会先思考再作答,限制在 1,024 时约有三分之一的请求返回空答案。使用 vLLM 时必须传入 --max-num-seqs 128:混合架构会为每个解码序列预留一个状态缓存块,vLLM 的默认值会导致引擎无法启动。
enable_thinking: false 仅用于带图像的转写请求;纯文本请求请始终保持思考模式开启。
鸣谢赞助
本模型的训练与评测使用了由暹罗 AI 公司(Siam AI Corporation)赞助的 8 张 NVIDIA H100 GPU。感谢他们对开放泰语 AI 的持续支持。
OpenThai 2.0 由 iApp Technology 开发,与泰国人工智能创业者协会(AIEAT)共同发布,基座模型为 Qwen/Qwen3.8-27B。
延伸阅读:包含全部评测表格的完整发布公告 · 在 Hugging Face 下载 · 在浏览器中免费试用