📄 อัปเกรดแล้ว! AI อ่านเอกสารภาษาไทย แจกฟรี 2 โมเดล
เวอร์ชัน 2.1 ออกเมื่อ 18 พฤศจิกายน 2569 (2026) · เวอร์ชัน 2.0 ประกาศเมื่อ 12 พฤศจิกายน 2569
OCR Markdown 0.63BOCR Text 6.6 MBใช้เชิงพาณิชย์ได้ไทย + อังกฤษv2.1
เคยไหม สแกนเอกสารราชการมาทั้งปึก หรือถ่ายรูปเอกสารด้วยมือถือ อยากได้ตัวหนังสือ แต่ OCR อ่านตารางออกมาเป็นบรรทัดยาวเหยียด ไม่รู้ตัวเลขไหนอยู่แถวไหน สุดท้ายต้องนั่งคีย์ใหม่ทีละช่อง
ทีม OpenThai ของ iApp Technology แจก OCR ภาษาไทย 2 โมเดลให้ทุกคนโหลดไปใช้ได้ฟรี ใช้ในงานเชิงพาณิชย์ได้ด้วย เวอร์ชัน 2.1 อ่านภาพถ่ายเอกสารจากมือถือได้ดีขึ้นมาก และแก้ปัญหาที่ผู้ใช้แจ้งเข้ามาหลังเปิดตัว 2.0 (อ่านว่ามีอะไรใหม่)
| OpenThai 2.1 OCR Markdown | OpenThai 2.1 OCR Text | |
|---|---|---|
| ทำอะไร | หน้าเอกสารหรือภาพถ่ายเอกสาร → Markdown ตารางเป็น HTML (รองรับเซลล์ผสาน) สูตรเป็น LaTeX พร้อมกล่องและประเภทของทุกบล็อก | หน้าเอกสาร → ข้อความตามลำดับการอ่าน พร้อมกล่องและค่าความมั่นใจทุกบรรทัด |
| ขนาด | 0.63B พารามิเตอร์ | 1.60M พารามิเตอร์ ไฟล์ ONNX รวม 6.6 MB (ตัวตรวจจับ 1.8 MB ตัวอ่าน 2.4 MB และตัวอ่านสำรองสำหรับฟอนต์ไม่มีหัว 2.4 MB) |
| รันบน | GPU NVIDIA ใบเดียว ผ่าน vLLM หรือ Mac และ CPU ผ่าน llama.cpp (GGUF) | CPU อย่างเดียว ไม่ต้องใช้ GPU |
| ความเร็ว | 1.5 วินาทีต่อหน้าบน H100 ราว 6 วินาทีต่อหน้าบน Apple M3 Max (GGUF) | 0.39 วินาทีต่อหน้า ราว 950 หน้าต่อนาทีบน 8 คอร์ |
| ต่อยอดจาก | NVIDIA Nemotron 3.5 Parse | PaddlePaddle PP-OCRv6-tiny |
| สัญญาอนุญาต | OpenMDW-1.1 | Apache-2.0 |
| เหมาะกับ | เอกสารที่มีตาราง ภาพถ่ายเอกสาร งานวิจัย สไลด์ เตรียมข้อมูลทำ RAG | ข้อความล้วนปริมาณมาก เครื่องไม่มี GPU เอกสารลับที่ออกนอกเครื่องไม่ได้ |
1) OpenThai 2.1 OCR Markdown: ตารางยังเป็นตาราง อ่านภาพถ่ายจากมือถือได้
อ่านหน้าเอกสารภาษาไทยและอังกฤษออกมาเป็น Markdown โดยตารางเป็น HTML พร้อม rowspan และ colspan เป็นการเทรนต่อแบบเต็มโมเดลจาก NVIDIA Nemotron 3.5 Parse (0.63B) จึงยังได้กล่องเลย์เอาต์ ประเภทบล็อก ลำดับการอ่าน และใช้ชุดเสิร์ฟเดิมของ Parse ได้ทุกที่
ใหม่ใน 2.1
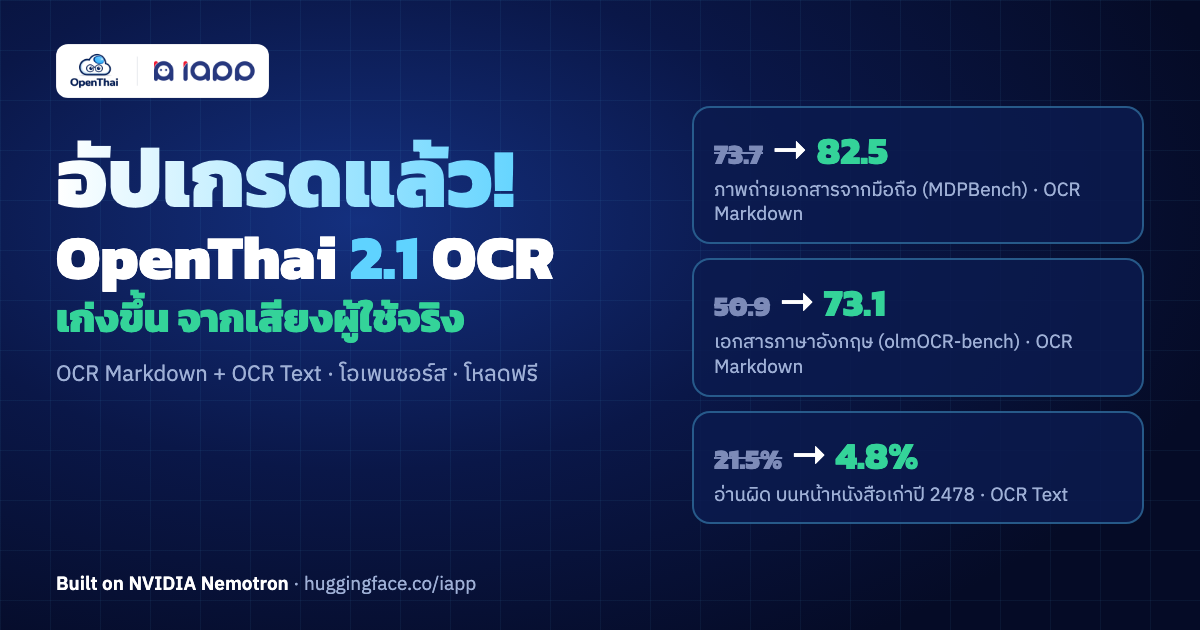
- ภาพถ่ายเอกสารจากมือถือ ทั้งกระดาษงอ ยับ และมีเงา: MDPBench (ไทยและอังกฤษ ส่วนใหญ่เป็นภาพถ่าย) จาก 73.7 เป็น 82.5 เฉพาะภาษาไทยจาก 72.7 เป็น 80.7
- อ่านเอกสารได้อีก 9 แบบ: งานวิจัย หนังสือ การ์ตูน ข้อสอบ นิตยสาร หนังสือพิมพ์ รายงาน สไลด์ และตำราเรียน ภาษาไทยและอังกฤษ: เอกสาร PDF ภาษาอังกฤษ (olmOCR-bench) จาก 50.9 เป็น 73.1 และ OmniDocBench v1.6 จาก 61.8 เป็น 79.6
- สูตรคณิตศาสตร์ออกมาเป็น LaTeX หัวกระดาษและท้ายกระดาษไม่ปนใน Markdown หน้าว่างไม่แต่งข้อความขึ้นมาเอง และสระอำเป็นตัวอักษรตัวเดียวถูกต้อง
- ตารางเอกสารราชการไทยยังแม่นเหมือนเดิม: th-docs-tables v1 ได้ 94.0 (2.0 ได้ 95.2 ต่างกันแบบไม่มีนัยสำคัญ) เทียบ Typhoon OCR V2 2B 91.6
- ขนาดและความเร็วเท่าเดิม: 1.5 วินาทีต่อหน้าบน NVIDIA H100 ใบเดียว
- ใหม่: ไฟล์ GGUF สำหรับ llama.cpp รันบน Mac หรือ CPU ได้โดยไม่ต้องมี vLLM ราว 6 วินาทีต่อหน้าบน Apple M3 Max (Metal) และได้ Markdown ตรงกับโมเดลต้นฉบับครบทั้ง 30 หน้าที่ทดสอบ
| โมเดล | th-docs-tables v1 (65 หน้า) | ThaiOCRBench ตาราง (193 ภาพ) | ข้อความไทยตัวพิมพ์ (12 ชุด) | MDPBench ไทย+อังกฤษ (320 หน้า) | MDPBench ไทย | olmOCR-bench | OmniDocBench v1.6 | วินาทีต่อหน้า |
|---|---|---|---|---|---|---|---|---|
| OpenThai2.1-OCR-Markdown | 94.0 | 69.5 | 90.2 | 82.5 | 80.7 | 73.1 | 79.6 | 1.5 |
| OpenThai2.0-OCR-Markdown | 95.2 | 68.9 | 90.3 | 73.7 | 72.7 | 50.9 | 61.8 | 1.5 |
| Nemotron 3.5 Parse (ฐาน) | 91.3 | 68.3 | 89.0 | 79.6 | 77.4 | 62.4 | 80.1 | 1.8 |
| Typhoon OCR V2 2B | 91.6 | 67.6 | 89.6 | 87.0 | 85.0 | 84.7 | 91.5 | 1.0 |
ตัวหนาคือดีที่สุดในแต่ละคอลัมน์ (วินาทีต่อหน้าคือเร็วที่สุด) เทียบกับ Typhoon OCR V2 2B ด้วยช่วงความเชื่อมั่น 95%: th-docs-tables นำ +2.3 [+0.4, +4.8] ส่วน ThaiOCRBench ตารางและข้อความไทยต่างกันแบบไม่มีนัยสำคัญ บน MDPBench ตามหลัง 4.5 [−7.0, −2.0] ส่วนใหญ่ที่ภาพถ่ายและตารางในภาพถ่าย บน olmOCR-bench และ OmniDocBench ตามหลังราว 12 คะแนน ส่วนใหญ่ที่สูตรคณิตศาสตร์ MDPBench ไม่รวมคะแนนสูตร (CDM) และราชกิจจานุเบกษาชุดใหม่ที่อยู่ในหน้าของ 2.0 ยังไม่ได้วัดใหม่สำหรับ 2.1 รายละเอียดทั้งหมดอยู่ใน model card
วิธีใช้
เสิร์ฟด้วย vLLM เหมือนโมเดลฐาน แล้วอ่านหน้าเอกสารด้วย DocumentParser ของ NVIDIA จากแพ็กเกจ nemotron_parse ที่อยู่ในโมเดล (โหมดกล่องและประเภท อ่านรอบเดียว) vLLM รันบน Linux ถ้าใช้ Windows ให้รันใน WSL2
hf download iapp/OpenThai2.1-OCR-Markdown-20261118 --local-dir OpenThai2.1-OCR-Markdown
pip install -e "./OpenThai2.1-OCR-Markdown[vllm,client]"
vllm serve ./OpenThai2.1-OCR-Markdown --served-model-name nemotron-parse --trust-remote-code
from nemotron_parse.inference import DocumentParser, GenerationError

with DocumentParser(base_url="http://localhost:8000/v1", model="nemotron-parse") as parser:
    doc = parser.parse("page.png", mode="single")
    print(doc["markdown"])  # Markdown; ตารางเป็น HTML พร้อม rowspan/colspan; สูตรเป็น $$...$$
- ต้องการผลแบบ 2.0 (เก็บหัวกระดาษและท้ายกระดาษไว้ใน Markdown สูตรแบบ
\(...\)) ตั้งค่าได้ด้วยPostprocessOptionsดูใน model card - รันบน Mac หรือ CPU: ใช้ ไฟล์ GGUF กับ llama.cpp ฉบับของเรา (iapp-technology/llama.cpp branch
nemotron-parse) เพราะ llama.cpp ต้นฉบับยังไม่รองรับสถาปัตยกรรมนี้ - คู่มือทีละขั้นตอน สำหรับ Windows, Mac และ Linux พร้อมสคริปต์อ่านรูปและ PDF: อ่านบนบล็อก iApp (เขียนสำหรับ 2.0 ใช้กับ 2.1 ได้เลย เพียงเปลี่ยนชื่อโมเดล)
2) OpenThai 2.1 OCR Text: โมเดลจิ๋ว 6.6 MB ไม่ต้องใช้ GPU
OCR ข้อความภาษาไทยและอังกฤษตัวพิมพ์ที่รันบน CPU ธรรมดา ตัวตรวจจับบรรทัด PP-OCRv6-tiny (1.8 MB) และตัวอ่านบรรทัดภาษาไทยที่ iApp เทรนเอง (2.4 MB) รันด้วย OpenVINO หรือ ONNX Runtime เป็นเอนจินเบื้องหลัง iApp Document OCR
ใหม่ใน 2.1 (ไฟล์โมเดลเดิมของ 2.0 กับรันไทม์ใหม่ และตัวอ่านสำรองสำหรับฟอนต์ไม่มีหัว)
- หนังสือเก่าที่วรรณยุกต์ลอย ไม่ทำวรรณยุกต์หายแล้ว: หน้าทดสอบจากหนังสือปี 2478 ที่ผู้ใช้ส่งมา อ่านผิดลดจาก 21.5% เหลือ 4.8% (วัดบนหน้าเดียว ไม่ใช่ชุดทดสอบ)
- ฟอนต์ไม่มีหัว (Kanit, Prompt, Sukhumvit Set) ไม่ถูกอ่านเป็นตัวอังกฤษอีกแล้ว
- เอกสาร 2–3 คอลัมน์ อ่านทีละคอลัมน์ ส่วนรายการและตารางยังอ่านทีละแถว
- ตัวเลขหรือตัวอักษรตัวเดียวในช่องตาราง ไม่หายแล้ว และยอดเงินที่มีจุลภาคก่อนทศนิยม เช่น "280,00" ออกมาเป็น "280.00"
- ใช้หน่วยความจำน้อยลงบน Mac และ Windows
- ข้อความตัวพิมพ์ 12 ชุด เฉลี่ยจาก 87.8 เป็น 88.3 และ ThaiOCRBench หน้าเต็มจาก 82.0 เป็น 84.1
- เร็วเท่าเดิม 0.39 วินาทีต่อหน้า ไม่ต้องต่อเน็ต เอกสารลับไม่ต้องออกจากเครื่อง
ส่วนใหญ่ของการแก้ไขรอบนี้มาจากผู้ใช้จริง ทั้งคอมเมนต์ใน Facebook และโปรเจกต์บน GitHub ที่สร้างบนโมเดลนี้ ขอบคุณทุกคนครับ
ทุกเอนจินอ่านหน้าเดียวกันและให้คะแนนแบบเดียวกัน คะแนนคือความแม่นยำระดับตัวอักษร 100 × (1 − CER) ยิ่งสูงยิ่งดี
| เอนจิน | เฉลี่ย 12 ชุดตัวพิมพ์ | คำพิพากษา | ราชกิจจาฯ | งบประมาณ | หนังสือเก่า | ThaiOCRBench | ลายมือ |
|---|---|---|---|---|---|---|---|
| OpenThai2.1-OCR-Text (v2.1.1, CPU) | 88.2 | 97.0 | 96.3 | 99.6 | 78.8 | 83.8 | 10.3 |
| OpenThai2.0-OCR-Text (v2.0.0, CPU) | 87.8 | 97.0 | 96.3 | 99.5 | 77.1 | 82.0 | 10.3 |
| OpenThai2.0-OCR-Markdown (GPU) | 90.3 | 96.2 | 98.0 | 98.2 | 79.7 | 90.6 | 78.9 |
| Typhoon OCR V2 2B | 89.6 | 96.2 | 94.6 | 97.3 | 77.2 | 87.3 | 76.7 |
| NVIDIA Nemotron 3.5 Parse | 89.0 | 96.9 | 92.2 | 98.9 | 76.9 | 92.0 | 57.3 |
| Typhoon OCR 1.5 2B | 87.5 | 92.4 | 92.5 | 97.2 | 78.6 | 71.4 | 94.5 |
| Gemini 2.5 Flash | 87.1 | 94.7 | 92.6 | 81.0 | 77.9 | 88.8 | 86.7 |
| dots.mocr | 86.4 | 96.3 | 93.1 | 99.5 | 76.3 | 78.8 | 39.4 |
| OneOCR (Microsoft, Windows) | 85.0 | 95.1 | 96.6 | 99.8 | 78.6 | 81.8 | 91.0 |
| Google Cloud Vision | 83.6 | 93.9 | 87.8 | 75.0 | 73.6 | 85.6 | 60.8 |
| PaddleOCR 3 PP-OCRv5 (th) | 81.1 | 90.4 | 82.9 | 93.1 | 55.5 | 75.8 | 41.6 |
| Qwen3.5-9B | 80.1 | 34.5 | 88.2 | 91.8 | 68.5 | 82.0 | 54.1 |
| Tesseract 5 (tha+eng) | 75.4 | 71.7 | 82.3 | 71.3 | 52.2 | 75.0 | 26.4 |
| PaddleOCR-VL 1.6 | 72.4 | 80.8 | 79.7 | 70.3 | 57.6 | 68.2 | 13.4 |
| DeepSeek-OCR-2 | 69.0 | 92.8 | 84.7 | 91.4 | 55.2 | 77.5 | 3.9 |
ตัวหนาคือดีที่สุดในแต่ละคอลัมน์ แถวของ 2.1 วัดที่ v2.1.1 ตาม model card ส่วนเวอร์ชันล่าสุด v2.1.4 ได้ค่าเฉลี่ย 12 ชุด 88.3 และ ThaiOCRBench 84.1 ค่าเฉลี่ยรวม 12 ชุดตัวพิมพ์ (งบประมาณ ราชกิจจาฯ SEA-DocBench หนังสือเก่าจากวิกิซอร์ซ คำพิพากษาศาลปกครอง ThaiOCRBench th-docs-tables และ OCR104 อีก 3 ชุด) ไม่รวมลายมือ ตารางเต็มและความเร็วของทุกเอนจินอยู่ใน model card คำพิพากษาศาลเป็นเอกสารประเภทที่อยู่ในชุดเทรน (คนละฉบับกับที่ทดสอบ)
วิธีใช้
hf download iapp/OpenThai2.1-OCR-Text-20261118 --local-dir OpenThai2.1-OCR-Text
pip install -r OpenThai2.1-OCR-Text/requirements.txt
cd OpenThai2.1-OCR-Text
from runtime.line_engine import LineOCR

ocr = LineOCR(".", threads=1)
r = ocr.read("page.png")      # path, bytes, ndarray หรือ PIL image
print(r["text"])              # ข้อความตามลำดับการอ่าน (ทีละคอลัมน์)
r["lines"]                    # [{"text", "confidence", "row", "box"}]
ถ้าต้องการปริมาณงานสูง ให้รัน worker หนึ่ง process ต่อหนึ่งคอร์ด้วย threads=1
🔁 ใช้เวอร์ชัน 2.0 อยู่?
- ลิงก์และชื่อโมเดลเดิมยังใช้ได้ (
iapp/OpenThai2.0-OCR-Markdownและiapp/OpenThai2.0-OCR-Text) Hugging Face พาไปชื่อใหม่ให้อัตโนมัติ และจะได้เวอร์ชัน 2.1 - ต้องการเวอร์ชันเดิม ใส่
revision="v2.0.0"ตอนโหลด - ไม่อยากให้ผลเปลี่ยนเองเมื่อมีอัปเดต ปักเวอร์ชันไว้ด้วย
revision="v2.1.0"(OCR Markdown) หรือrevision="v2.1.4"(OCR Text)
🤔 ทำไมแจกฟรี
เอกสารไทยอีกหลายล้านหน้าในหน่วยงานรัฐ โรงพยาบาล และบริษัท ส่งขึ้นคลาวด์ต่างประเทศไม่ได้ เราอยากให้ทุกที่รันในเครื่องตัวเองได้ และใครจะทำแชทบอท AI จากเอกสารองค์กร ก็ต้องเริ่มจากอ่านเอกสารให้ถูกก่อน
⚠️ พูดกันตรง ๆ: สิ่งที่ยังไม่ใช่จุดแข็ง
- ภาพถ่ายเอกสาร เอกสารภาษาอังกฤษ และสูตรคณิตศาสตร์ Typhoon OCR V2 2B ยังนำเราอยู่ (MDPBench 87.0, olmOCR-bench 84.7, OmniDocBench 91.5) เวอร์ชันหน้าทีมกำลังเก็บภาพถ่ายเอกสารไทยจริงและข้อมูลสูตรมาพัฒนาต่อ
- สูตรคณิตศาสตร์ ยังเป็นจุดที่อ่อนที่สุดของ OCR Markdown
- ภาพหรือแผนภาพที่ไม่มีตัวหนังสือ อาจยังได้ข้อความที่แต่งขึ้นมา (หน้าว่างล้วนข้ามให้แล้ว)
- ภาษาจีน ไม่ใช่ภาษาเป้าหมาย อ่านได้แย่กว่าภาษาอังกฤษชัดเจน
- ลายมือทั้งหน้า ยังไม่ใช่เป้าหมาย OCR Markdown อ่านลายมือได้ระดับบรรทัด ส่วน OCR Text อ่านเฉพาะตัวพิมพ์
- ภาพตัดสั้นของข้อความที่ถ่ายด้วยกล้อง อ่านได้แย่กว่าหน้าเต็ม: OCR Markdown ได้ 94.5 บนภาพถ่ายเอกสาร OCR104
- ตารางที่ไม่เหมือนเอกสารราชการไทย บางตารางยังได้แถวไม่ครบหรือ rowspan ผิด
- เลขไทย บางครั้งออกมาเป็นเลขอารบิก
- OCR Text: ฟอนต์ตกแต่งหนัก ๆ อาจอ่านผิด ฟอนต์ไม่มีหัวยังสลับตัวอักษรได้บ้าง (ท กับ า) ตราประทับจะออกมาเป็นข้อความ และความเร็วแบบ bf16 ต้องใช้ CPU ที่มี AMX (Sapphire Rapids ขึ้นไป)
ทีมกำลังพัฒนาต่อครับ และขอบคุณทีม Typhoon ที่ช่วยกันยกมาตรฐาน OCR ภาษาไทยมาด้วยกัน
👨👩👧 ตระกูล OpenThai 2
| โมเดล | ทำอะไร | ขนาด | สถานะ |
|---|---|---|---|
| OpenThai 2.0 | LLM สนทนา/ให้เหตุผลภาษาไทย อ่านภาพได้ | 27B | เปิดตัวแล้ว |
| OpenThai 2.0 Legal | โมเดลกฎหมายไทยสำหรับ RAG | 30B-A3B | เปิดตัวแล้ว |
| OpenThai-SystemOne | โมเดลตัดสินใจไทย+อังกฤษ (ไม่สร้างข้อความ) | 0.8B | เปิดตัวแล้ว |
| OpenThai 2.1 OCR Markdown | หน้าเอกสาร → Markdown ตารางเป็นตาราง | 0.63B | อัปเดต 18 พ.ย. |
| OpenThai 2.1 OCR Text | OCR ข้อความตัวพิมพ์บน CPU | 6.6 MB | อัปเดต 18 พ.ย. |
| OpenThai 2.0 ASR Streaming | ถอดเสียงพูดภาษาไทยแบบสด | 0.64B | เปิดตัวแล้ว |
🏷️ แอปที่ใช้ OpenThai OCR
ถ้าแอปของคุณใช้โมเดลนี้ ส่งชื่อแอปมาลงรายการได้ที่ openthai.ai/powered-by ที่นั่นมีป้าย Powered by ให้ติดในแอปด้วย
🤝 ร่วมพัฒนา
- มีเอกสารภาษาไทยที่ OCR ตัวไหนก็อ่านไม่ออก (ที่ไม่มีข้อมูลส่วนตัว) ส่งมาให้เราลองได้
- พูดคุยกันได้ที่ Discord OpenThaiGPT และ กลุ่ม Facebook
📄 สัญญาอนุญาตและเครดิต
- OpenThai 2.1 OCR Markdown: OpenMDW-1.1 อนุญาตให้ใช้ได้โดยไม่มีข้อจำกัด รวมถึงเชิงพาณิชย์ เป็นงานต่อยอดจาก NVIDIA Nemotron 3.5 Parse ซึ่งใช้ OpenMDW-1.1 เช่นกัน tokenizer ใช้สัญญาอนุญาต MIT ส่วน llama.cpp ฉบับของเราใช้ MIT เหมือน llama.cpp Built on NVIDIA Nemotron
- OpenThai 2.1 OCR Text: Apache-2.0 ตัวตรวจจับและจุดเริ่มต้นของตัวอ่านคือ PP-OCRv6-tiny ของ PaddlePaddle (Apache-2.0)
พัฒนาโดย iApp เปิดตัวร่วมกับ AIEAT
🙏 ขอบคุณ Siam AI
ทั้งสองโมเดลเทรนบน GPU NVIDIA H100 ที่ได้รับการสนับสนุนจาก บริษัท สยาม เอไอ คอร์เปอเรชั่น จำกัด ขอขอบคุณเป็นอย่างยิ่งที่ร่วมสนับสนุน AI ไทยแบบเปิดมาอย่างต่อเนื่อง และขอบคุณ NVIDIA สำหรับ Nemotron 3.5 Parse