📄 ทำได้แล้ว! AI อ่านเอกสารภาษาไทย แจกฟรี 2 โมเดล
ประกาศเมื่อ 12 พฤศจิกายน 2569 (2026)
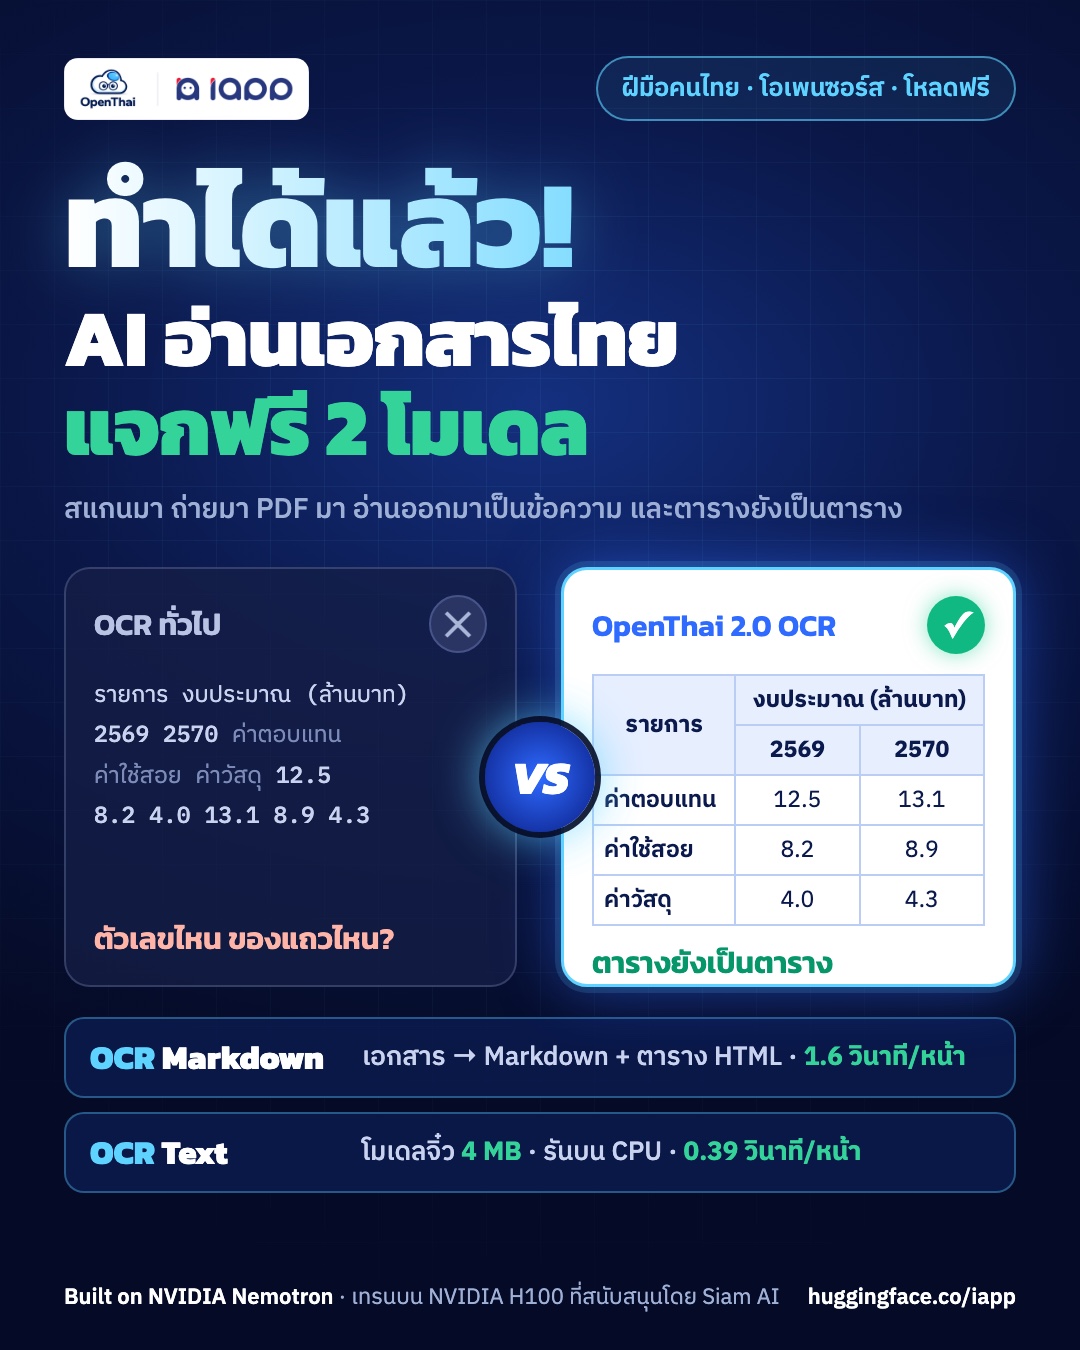
OCR Markdown 0.63BOCR Text 4 MBใช้เชิงพาณิชย์ได้ไทย + อังกฤษv1.0.0
เคยไหม สแกนเอกสารราชการมาทั้งปึก อยากได้ตัวหนังสือ แต่ OCR อ่านตารางออกมาเป็นบรรทัดยาวเหยียด ไม่รู้ตัวเลขไหนอยู่แถวไหน สุดท้ายต้องนั่งคีย์ใหม่ทีละช่อง
วันนี้ทีม OpenThai ของ iApp Technology เปิดให้ทุกคนโหลด OCR ภาษาไทย 2 โมเดลไปใช้ได้ฟรี ใช้ในงานเชิงพาณิชย์ได้ด้วย
| OpenThai 2.0 OCR Markdown | OpenThai 2.0 OCR Text | |
|---|---|---|
| ทำอะไร | หน้าเอกสาร → Markdown ตารางเป็น HTML (รองรับเซลล์ผสาน) พร้อมกล่องและประเภทของทุกบล็อก | หน้าเอกสาร → ข้อความตามลำดับการอ่าน พร้อมกล่องและค่าความมั่นใจทุกบรรทัด |
| ขนาด | 0.63B พารามิเตอร์ | 1.02M พารามิเตอร์ ไฟล์ ONNX รวม 4.2 MB |
| รันบน | GPU NVIDIA ใบเดียว ผ่าน vLLM | CPU อย่างเดียว ไม่ต้องใช้ GPU |
| ความเร็ว | 1.6 วินาทีต่อหน้า บน H100 | 0.39 วินาทีต่อหน้า ราว 950 หน้าต่อนาทีบน 8 คอร์ |
| ต่อยอดจาก | NVIDIA Nemotron 3.5 Parse | PaddlePaddle PP-OCRv6-tiny |
| สัญญาอนุญาต | OpenMDW-1.1 | Apache-2.0 |
| เหมาะกับ | เอกสารที่มีตาราง งบประมาณ ราชกิจจานุเบกษา เตรียมข้อมูลทำ RAG | ข้อความล้วนปริมาณมาก เครื่องไม่มี GPU เอกสารลับที่ออกนอกเครื่องไม่ได้ |
1) OpenThai 2.0 OCR Markdown: ตารางยังเป็นตาราง
อ่านหน้าเอกสารภาษาไทยออกมาเป็น Markdown โดยตารางเป็น HTML พร้อม rowspan และ colspan เป็นการเทรนต่อแบบเต็มโมเดลจาก NVIDIA Nemotron 3.5 Parse (0.63B) จึงยังได้กล่องเลย์เอาต์ ประเภทบล็อก ลำดับการอ่าน และใช้ชุดเสิร์ฟเดิมของ Parse ได้ทุกที่
- ตารางในเอกสารจริงของหน่วยงานรัฐและมหาวิทยาลัยไทย 65 หน้า (th-docs-tables v1) ได้ 95.2 เทียบ Typhoon OCR V2 2B 91.6 (ต่าง +3.6 ช่วงความเชื่อมั่น 95% [+1.2, +6.2])
- ราชกิจจานุเบกษา 339 หน้าที่ประกาศหลังเราเทรนเสร็จ (4–9 พ.ย. 2569) อ่านตัวอักษรถูก 98.7% (Typhoon OCR V2 2B 94.6)
- ข้อความภาษาไทยตัวพิมพ์ 12 ชุด เฉลี่ย 90.3 สูงสุดจาก 15 เอนจินที่เราทดสอบ (Typhoon OCR V2 2B 89.6 ซึ่งต่างกันแบบไม่มีนัยสำคัญ)
- 1.6 วินาทีต่อหน้า บน NVIDIA H100 ใบเดียว (ค่ามัธยฐานของหน้าตาราง 12 หน้า ส่งทีละหน้า)
- ไม่ติดลูปซ้ำคำเลยสักหน้า ทั้งบนหน้าทดสอบทุกชุดและหน้าพัฒนาอีก 6,137 หน้า
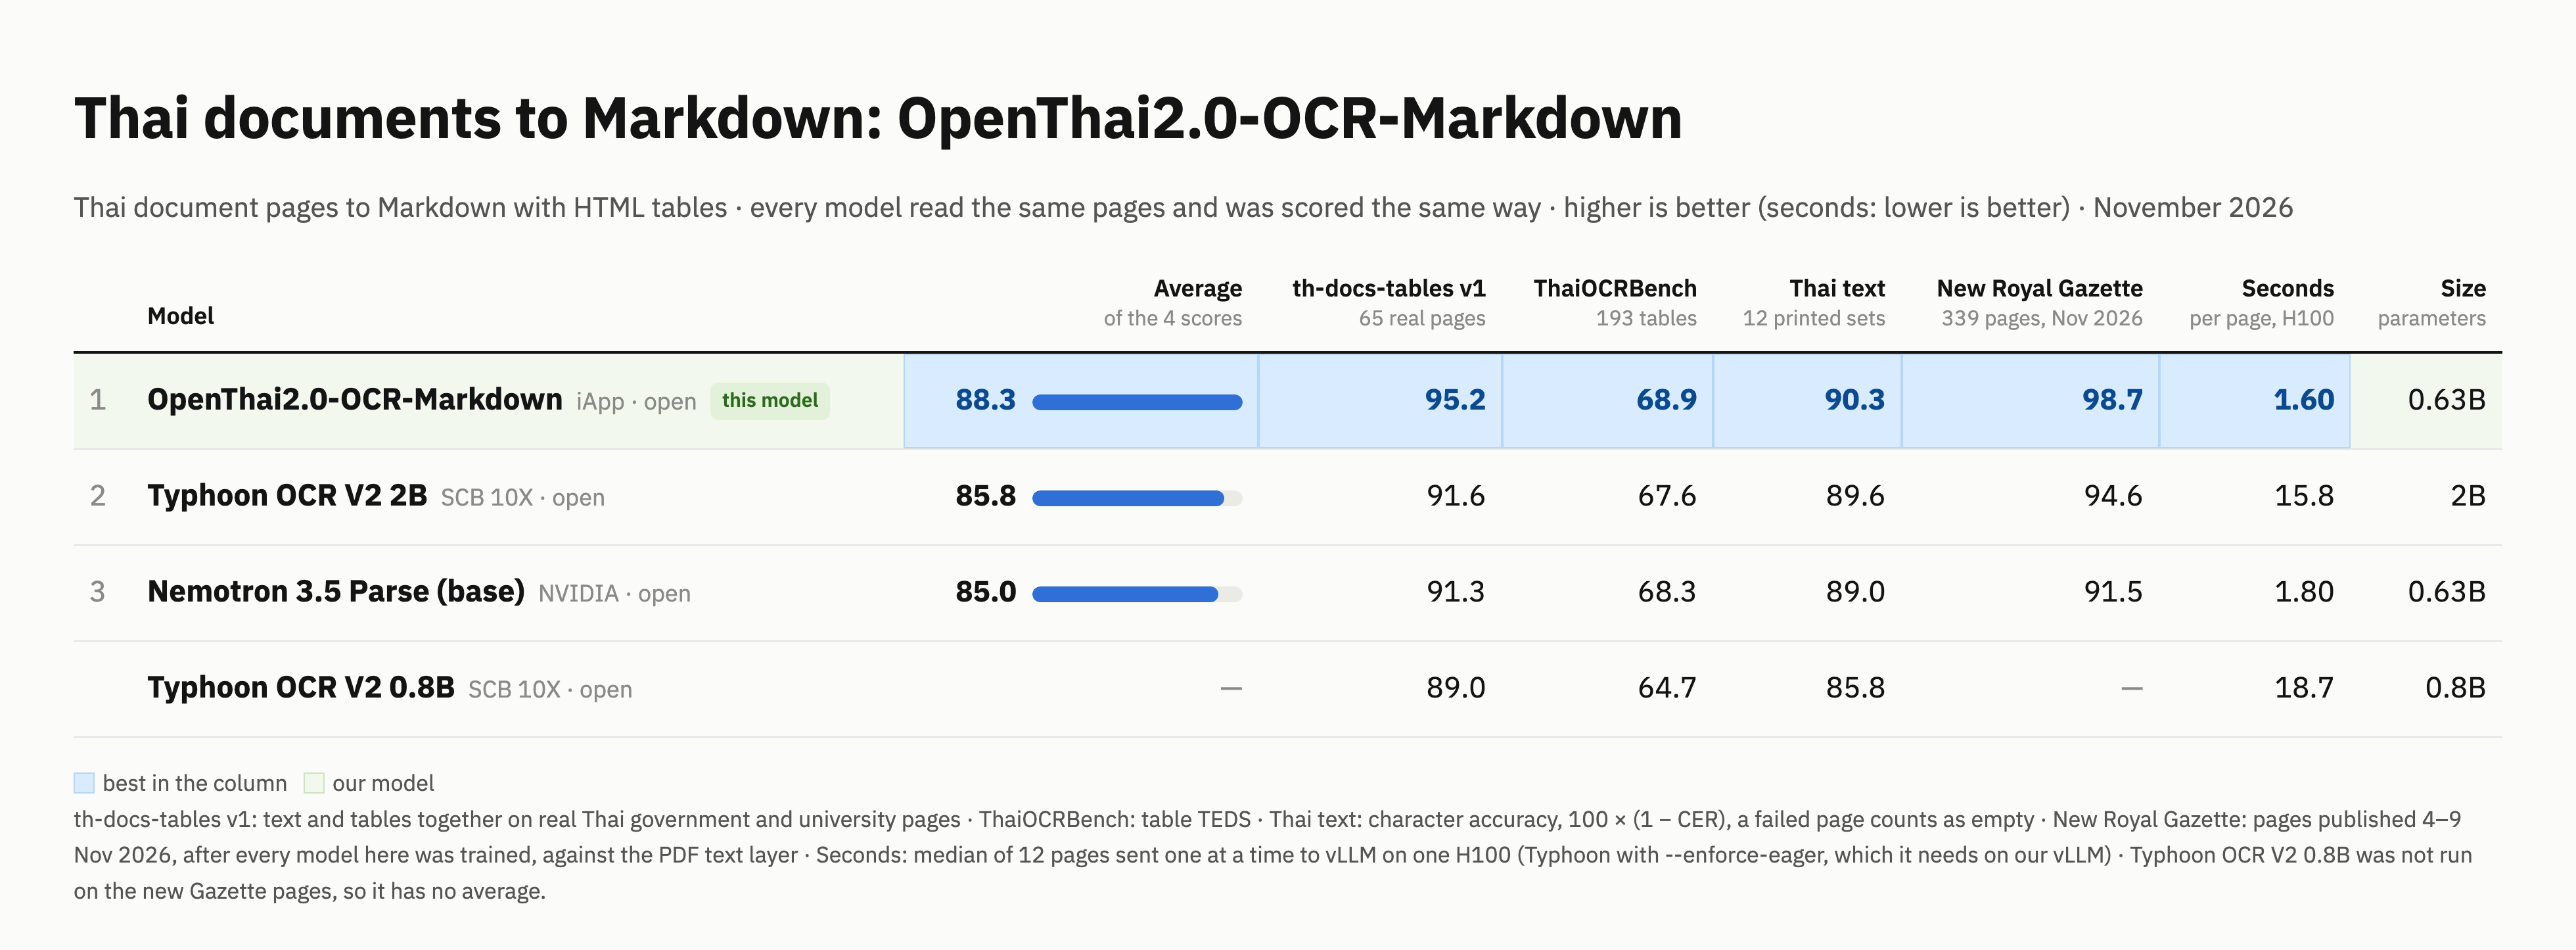
| โมเดล | ขนาด | th-docs-tables v1 (65 หน้า) | ThaiOCRBench ตาราง (193 ภาพ) | ข้อความไทยตัวพิมพ์ (12 ชุด) | ราชกิจจาฯ ใหม่ (339 หน้า) | เฉลี่ย | วินาทีต่อหน้า |
|---|---|---|---|---|---|---|---|
| OpenThai2.0-OCR-Markdown | 0.63B | 95.2 | 68.9 | 90.3 | 98.7 | 88.3 | 1.6 |
| Nemotron 3.5 Parse (ฐาน) | 0.63B | 91.3 | 68.3 | 89.0 | 91.5 | 85.0 | 1.8 |
| Typhoon OCR V2 2B | 2B | 91.6 | 67.6 | 89.6 | 94.6 | 85.8 | 15.8 |
| Typhoon OCR V2 0.8B | 0.8B | 89.0 | 64.7 | 85.8 | — | — | 18.7 |
ตัวหนาคือดีที่สุดในแต่ละคอลัมน์ ค่าเฉลี่ยคือค่าเฉลี่ยของ 4 คอลัมน์ความแม่นยำ ส่วน ThaiOCRBench ตาราง (+1.3) และข้อความตัวพิมพ์ (+0.76) ต่างจาก Typhoon OCR V2 2B แบบไม่มีนัยสำคัญ ความเร็วของ Typhoon วัดโดยรันด้วย --enforce-eager ซึ่งโมเดลต้องใช้บน vLLM เวอร์ชันของเรา ถ้าใช้ CUDA graphs ได้จะเร็วกว่านี้ ราชกิจจาฯ ใหม่เป็นเอกสารแบบที่โมเดลคุ้นเคย (ชุดเทรนมีราชกิจจาฯ ของเดือนก่อน ๆ) แต่ไม่มีหน้าใดเคยถูกเทรน
วิธีใช้
เสิร์ฟด้วย vLLM เหมือนโมเดลฐาน แล้วอ่านหน้าเอกสารด้วย DocumentParser ของ NVIDIA (โหมดกล่องและประเภท อ่านรอบเดียว)
vllm serve iapp/OpenThai2.0-OCR-Markdown --served-model-name nemotron-parse --trust-remote-code
from nemotron_parse.inference import DocumentParser, GenerationError

with DocumentParser(base_url="http://localhost:8000/v1", model="nemotron-parse") as parser:
    doc = parser.parse("page.png", mode="single")
    print(doc["markdown"])  # Markdown; ตารางเป็น HTML พร้อม rowspan/colspan
ใช้โหมดกล่อง (box mode) ซึ่งเป็นโหมดที่เราทดสอบ วิธีติดตั้งแบบละเอียดอยู่ใน model card
2) OpenThai 2.0 OCR Text: โมเดลจิ๋ว 4 MB ไม่ต้องใช้ GPU
OCR ข้อความภาษาไทยและอังกฤษตัวพิมพ์ที่รันบน CPU ธรรมดา ตัวตรวจจับบรรทัด PP-OCRv6-tiny (1.8 MB) และตัวอ่านบรรทัดภาษาไทยที่ iApp เทรนเอง (2.4 MB) รันด้วย OpenVINO หรือ ONNX Runtime
- 0.39 วินาทีต่อหน้า A4 ที่ตัวหนังสือแน่น และราว 950 หน้าต่อนาทีบน Xeon 8 คอร์ ใช้ RAM ราว 450 MB ต่อ worker
- ไม่ต้องต่อเน็ต เอกสารลับไม่ต้องออกจากเครื่อง
- เอกสารงบประมาณ 99.5 และราชกิจจานุเบกษา 96.3 (Gemini 2.5 Flash 81.0 และ 92.6, Google Cloud Vision 75.0 และ 87.8)
- หมุนหน้ากระดาษ ปรับเอียง อ่านหลายคอลัมน์ตามลำดับ และอ่านตัวหนังสือบนพื้นสีให้เอง ผ่านชุดทดสอบความทนทานครบทั้ง 22 สภาพ
- OpenThai 2.0 OCR Text API ของ iApp สร้างบนโมเดลนี้
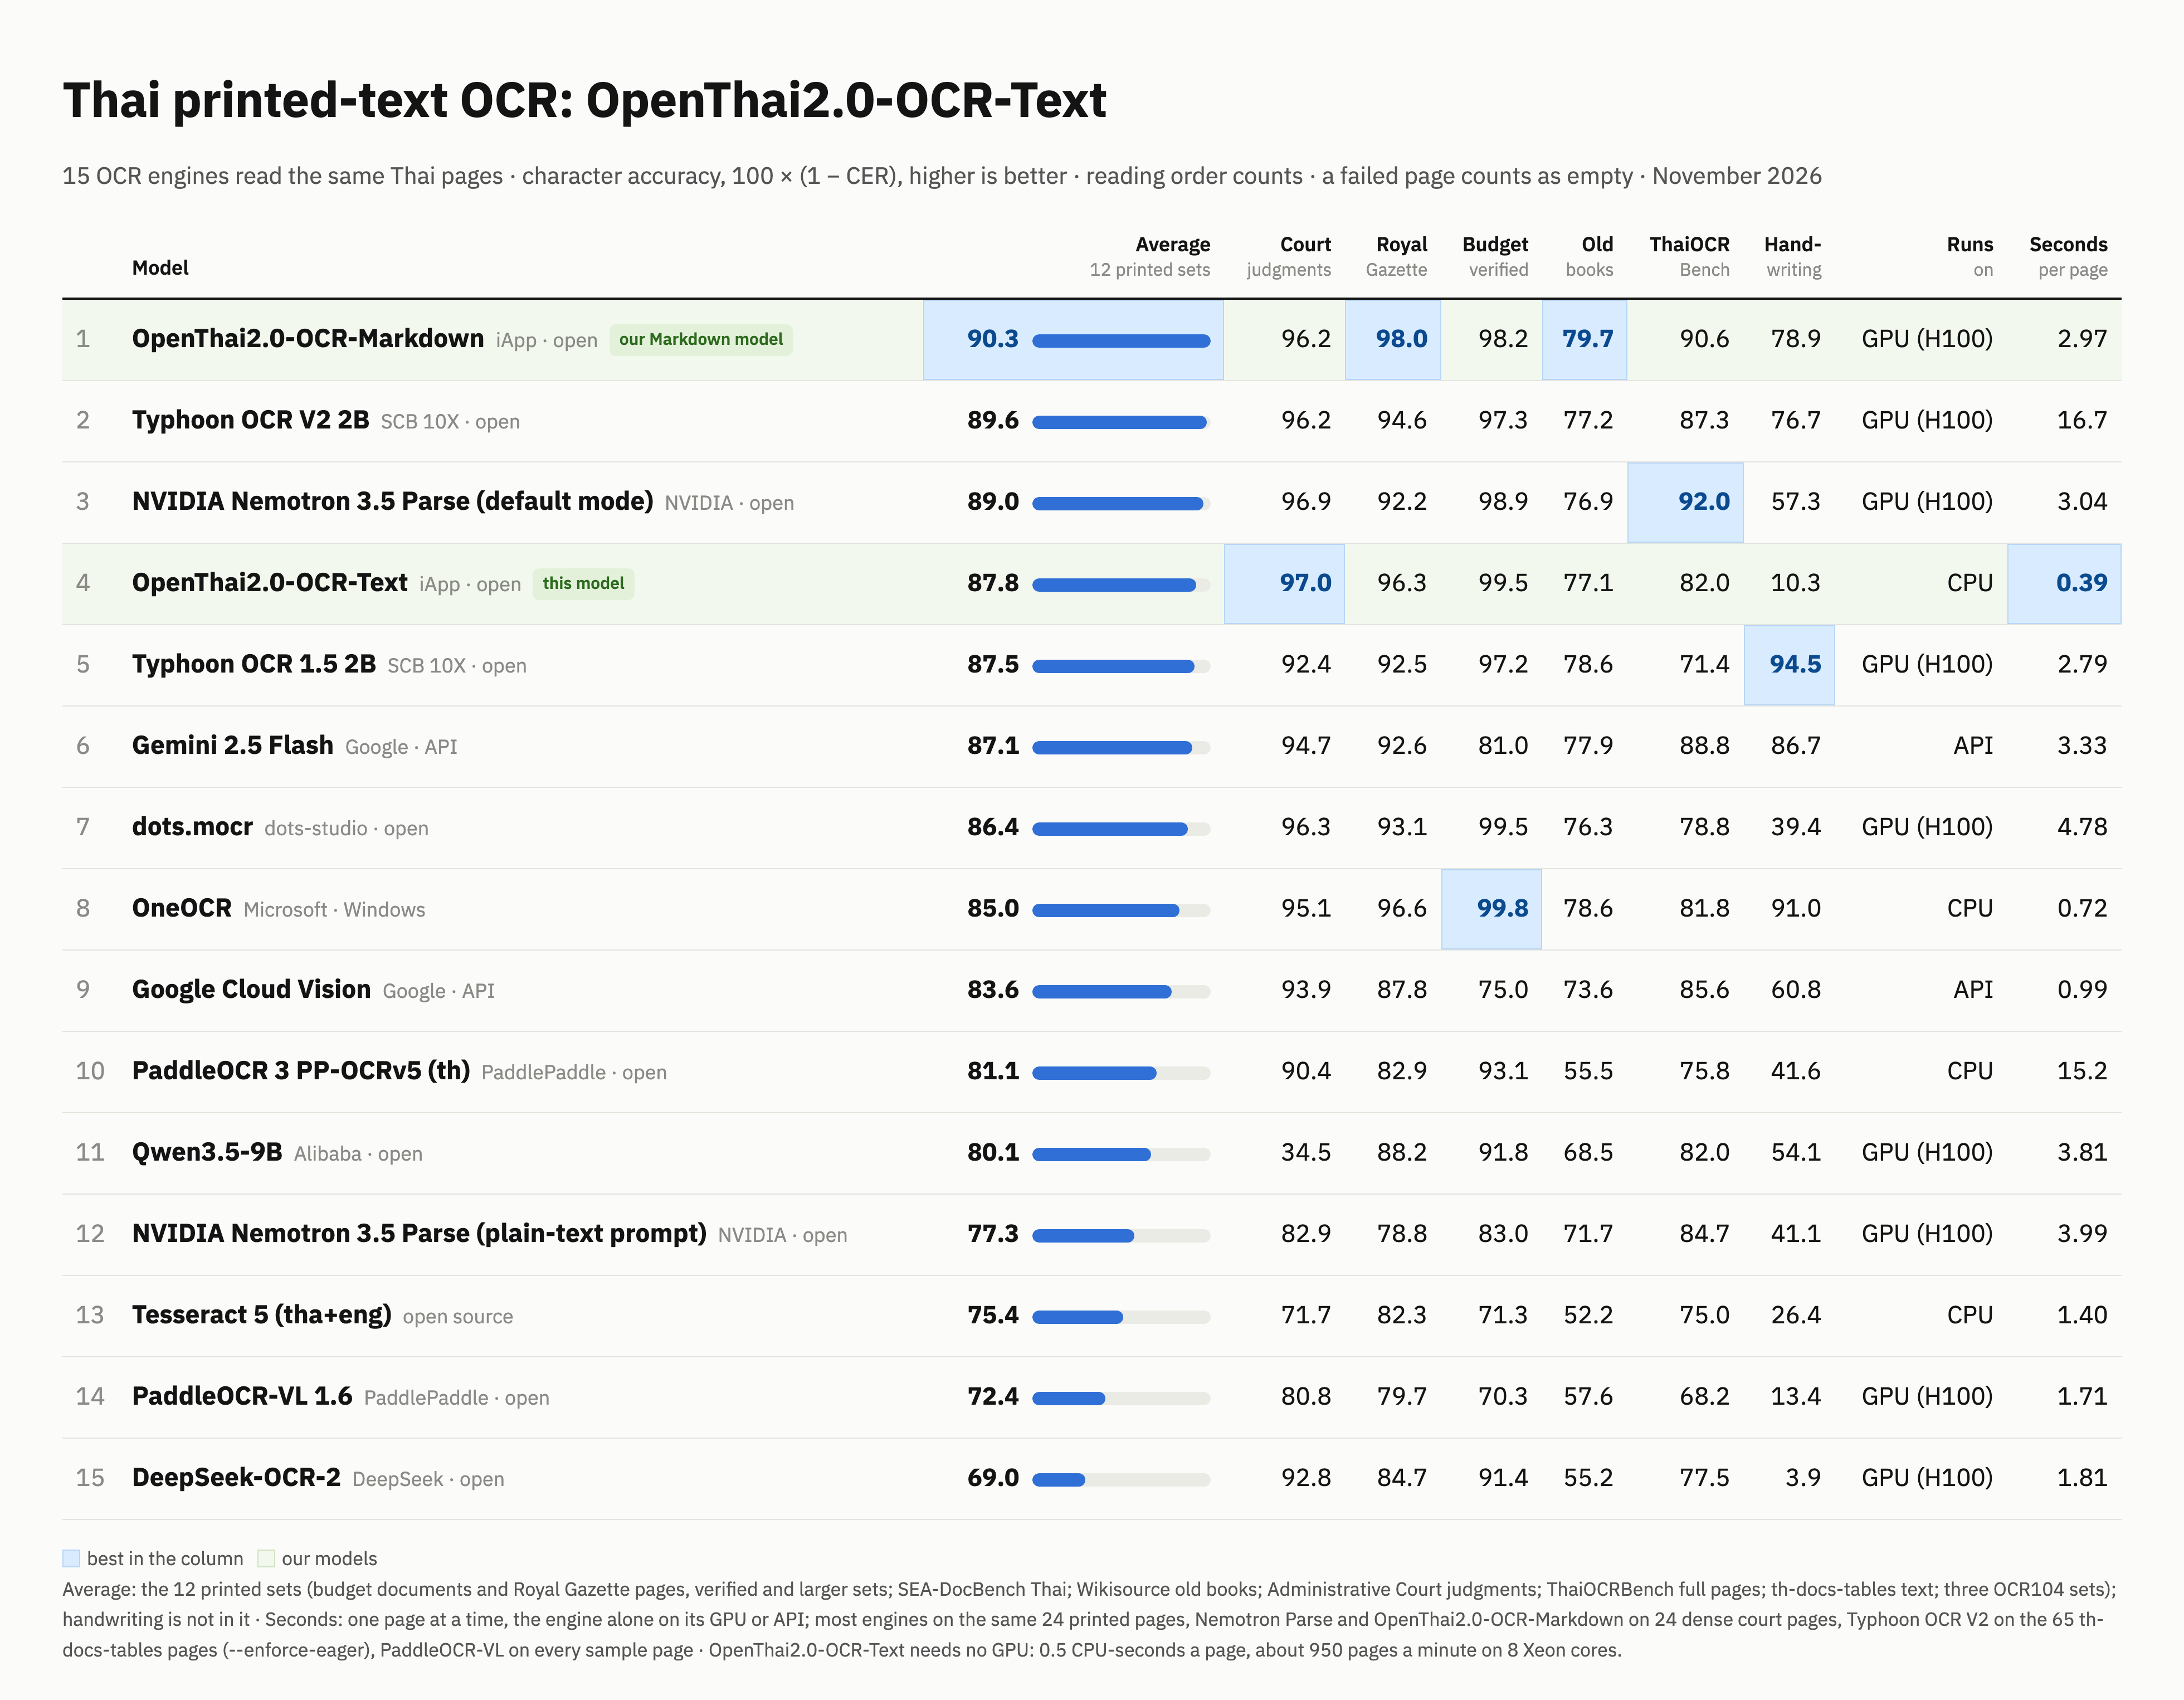
ทุกเอนจินอ่านหน้าเดียวกันและให้คะแนนแบบเดียวกัน คะแนนคือความแม่นยำระดับตัวอักษร 100 × (1 − CER) ยิ่งสูงยิ่งดี
| เอนจิน | เฉลี่ย 12 ชุดตัวพิมพ์ | คำพิพากษา | ราชกิจจาฯ | งบประมาณ | หนังสือเก่า | ThaiOCRBench | ลายมือ |
|---|---|---|---|---|---|---|---|
| OpenThai2.0-OCR-Text (โมเดลนี้, CPU) | 87.8 | 97.0 | 96.3 | 99.5 | 77.1 | 82.0 | 10.3 |
| OpenThai2.0-OCR-Markdown (GPU) | 90.3 | 96.2 | 98.0 | 98.2 | 79.7 | 90.6 | 78.9 |
| Typhoon OCR V2 2B | 89.6 | 96.2 | 94.6 | 97.3 | 77.2 | 87.3 | 76.7 |
| NVIDIA Nemotron 3.5 Parse | 89.0 | 96.9 | 92.2 | 98.9 | 76.9 | 92.0 | 57.3 |
| Typhoon OCR 1.5 2B | 87.5 | 92.4 | 92.5 | 97.2 | 78.6 | 71.4 | 94.5 |
| Gemini 2.5 Flash | 87.1 | 94.7 | 92.6 | 81.0 | 77.9 | 88.8 | 86.7 |
| dots.mocr | 86.4 | 96.3 | 93.1 | 99.5 | 76.3 | 78.8 | 39.4 |
| OneOCR (Microsoft, Windows) | 85.0 | 95.1 | 96.6 | 99.8 | 78.6 | 81.8 | 91.0 |
| Google Cloud Vision | 83.6 | 93.9 | 87.8 | 75.0 | 73.6 | 85.6 | 60.8 |
| PaddleOCR 3 PP-OCRv5 (th) | 81.1 | 90.4 | 82.9 | 93.1 | 55.5 | 75.8 | 41.6 |
| Qwen3.5-9B | 80.1 | 34.5 | 88.2 | 91.8 | 68.5 | 82.0 | 54.1 |
| Tesseract 5 (tha+eng) | 75.4 | 71.7 | 82.3 | 71.3 | 52.2 | 75.0 | 26.4 |
| PaddleOCR-VL 1.6 | 72.4 | 80.8 | 79.7 | 70.3 | 57.6 | 68.2 | 13.4 |
| DeepSeek-OCR-2 | 69.0 | 92.8 | 84.7 | 91.4 | 55.2 | 77.5 | 3.9 |
ตัวหนาคือดีที่สุดในแต่ละคอลัมน์ ค่าเฉลี่ยรวม 12 ชุดตัวพิมพ์ (งบประมาณ ราชกิจจาฯ SEA-DocBench หนังสือเก่าจากวิกิซอร์ซ คำพิพากษาศาลปกครอง ThaiOCRBench th-docs-tables และ OCR104 อีก 3 ชุด) ไม่รวมลายมือ ตารางเต็มรวม Nemotron 3.5 Parse แบบ plain-text prompt และความเร็วของทุกเอนจินอยู่ใน model card คำพิพากษาศาลเป็นเอกสารประเภทที่อยู่ในชุดเทรน (คนละฉบับกับที่ทดสอบ)
วิธีใช้
hf download iapp/OpenThai2.0-OCR-Text --local-dir OpenThai2.0-OCR-Text
pip install openvino opencv-python-headless pyclipper numpy
cd OpenThai2.0-OCR-Text
from runtime.line_engine import LineOCR

ocr = LineOCR(".", threads=1)
r = ocr.read("page.png")      # path, bytes, ndarray หรือ PIL image
print(r["text"])              # ข้อความตามลำดับการอ่าน
r["lines"]                    # [{"text", "confidence", "row", "box"}]
ถ้าต้องการปริมาณงานสูง ให้รัน worker หนึ่ง process ต่อหนึ่งคอร์ด้วย threads=1
🤔 ทำไมแจกฟรี
เอกสารไทยอีกหลายล้านหน้าในหน่วยงานรัฐ โรงพยาบาล และบริษัท ส่งขึ้นคลาวด์ต่างประเทศไม่ได้ เราอยากให้ทุกที่รันในเครื่องตัวเองได้ และใครจะทำแชทบอท AI จากเอกสารองค์กร ก็ต้องเริ่มจากอ่านเอกสารให้ถูกก่อน
⚠️ พูดกันตรง ๆ: สิ่งที่ยังไม่ใช่จุดแข็ง
- ลายมือทั้งหน้า ยังไม่ใช่เป้าหมาย OCR Markdown อ่านลายมือได้ระดับบรรทัด ส่วน OCR Text อ่านเฉพาะตัวพิมพ์
- ภาพถ่ายคำเดี่ยวและภาพตัดสั้นมาก อ่านได้แย่กว่าหน้าเต็ม: OCR Markdown ได้ 96.4 บนภาพถ่ายเอกสาร OCR104 เทียบ Typhoon OCR V2 2B 99.8
- ตารางที่ไม่เหมือนเอกสารราชการไทย อ่านได้ใกล้เคียงโมเดลฐาน (ThaiOCRBench ตาราง 68.9 เทียบฐาน 68.3) บางตารางยังได้แถวไม่ครบหรือ rowspan ผิด
- เลขไทย บางครั้งออกมาเป็นเลขอารบิก (112 ตัวจากเลขไทยราว 22,000 ตัวบนราชกิจจาฯ 339 หน้า)
- ตัวพิมพ์ดอตแมทริกซ์ (สมุดบัญชีธนาคาร) ได้ 89% บนชุดพัฒนาที่สร้างขึ้น ยังไม่มีชุดทดสอบจริง
- ข้อความแนวตั้ง เช่นหัวตารางที่หมุน อาจอ่านผิด
- OCR Text: ฟอนต์ตกแต่งหนัก ๆ อาจอ่านผิด ตราประทับจะออกมาเป็นข้อความ และความเร็วแบบ bf16 ต้องใช้ CPU ที่มี AMX (Sapphire Rapids ขึ้นไป)
ทีมกำลังพัฒนาต่อครับ และขอบคุณทีม Typhoon ที่ช่วยกันยกมาตรฐาน OCR ภาษาไทยมาด้วยกัน
👨👩👧 ตระกูล OpenThai 2.0
| โมเดล | ทำอะไร | ขนาด | สถานะ |
|---|---|---|---|
| OpenThai 2.0 | LLM สนทนา/ให้เหตุผลภาษาไทย อ่านภาพได้ | 27B | เปิดตัวแล้ว |
| OpenThai 2.0 Legal | โมเดลกฎหมายไทยสำหรับ RAG | 30B-A3B | เปิดตัวแล้ว |
| OpenThai-SystemOne | โมเดลตัดสินใจไทย+อังกฤษ (ไม่สร้างข้อความ) | 0.8B | เปิดตัวแล้ว |
| OpenThai 2.0 OCR Markdown | หน้าเอกสาร → Markdown ตารางเป็นตาราง | 0.63B | เปิดตัวแล้ว |
| OpenThai 2.0 OCR Text | OCR ข้อความตัวพิมพ์บน CPU | 4 MB | เปิดตัวแล้ว |
🤝 ร่วมพัฒนา
- มีเอกสารภาษาไทยที่ OCR ตัวไหนก็อ่านไม่ออก (ที่ไม่มีข้อมูลส่วนตัว) ส่งมาให้เราลองได้
- พูดคุยกันได้ที่ Discord OpenThaiGPT และ กลุ่ม Facebook
📄 สัญญาอนุญาตและเครดิต
- OpenThai 2.0 OCR Markdown: OpenMDW-1.1 อนุญาตให้ใช้ได้โดยไม่มีข้อจำกัด รวมถึงเชิงพาณิชย์ เป็นงานต่อยอดจาก NVIDIA Nemotron 3.5 Parse ซึ่งใช้ OpenMDW-1.1 เช่นกัน tokenizer ใช้สัญญาอนุญาต MIT Built on NVIDIA Nemotron
- OpenThai 2.0 OCR Text: Apache-2.0 ตัวตรวจจับและจุดเริ่มต้นของตัวอ่านคือ PP-OCRv6-tiny ของ PaddlePaddle (Apache-2.0)
พัฒนาโดย iApp Technology / ทีม OpenThai
🙏 ขอบคุณ Siam AI
ทั้งสองโมเดลเทรนบน GPU NVIDIA H100 ที่ได้รับการสนับสนุนจาก บริษัท สยาม เอไอ คอร์เปอเรชั่น จำกัด ขอขอบคุณเป็นอย่างยิ่งที่ร่วมสนับสนุน AI ไทยแบบเปิดมาอย่างต่อเนื่อง และขอบคุณ NVIDIA สำหรับ Nemotron 3.5 Parse