🎯 Jev ภาษาไทยมาแล้ว! OpenThai-SystemOne
ประกาศเมื่อ 20 กันยายน 2569 (2026)
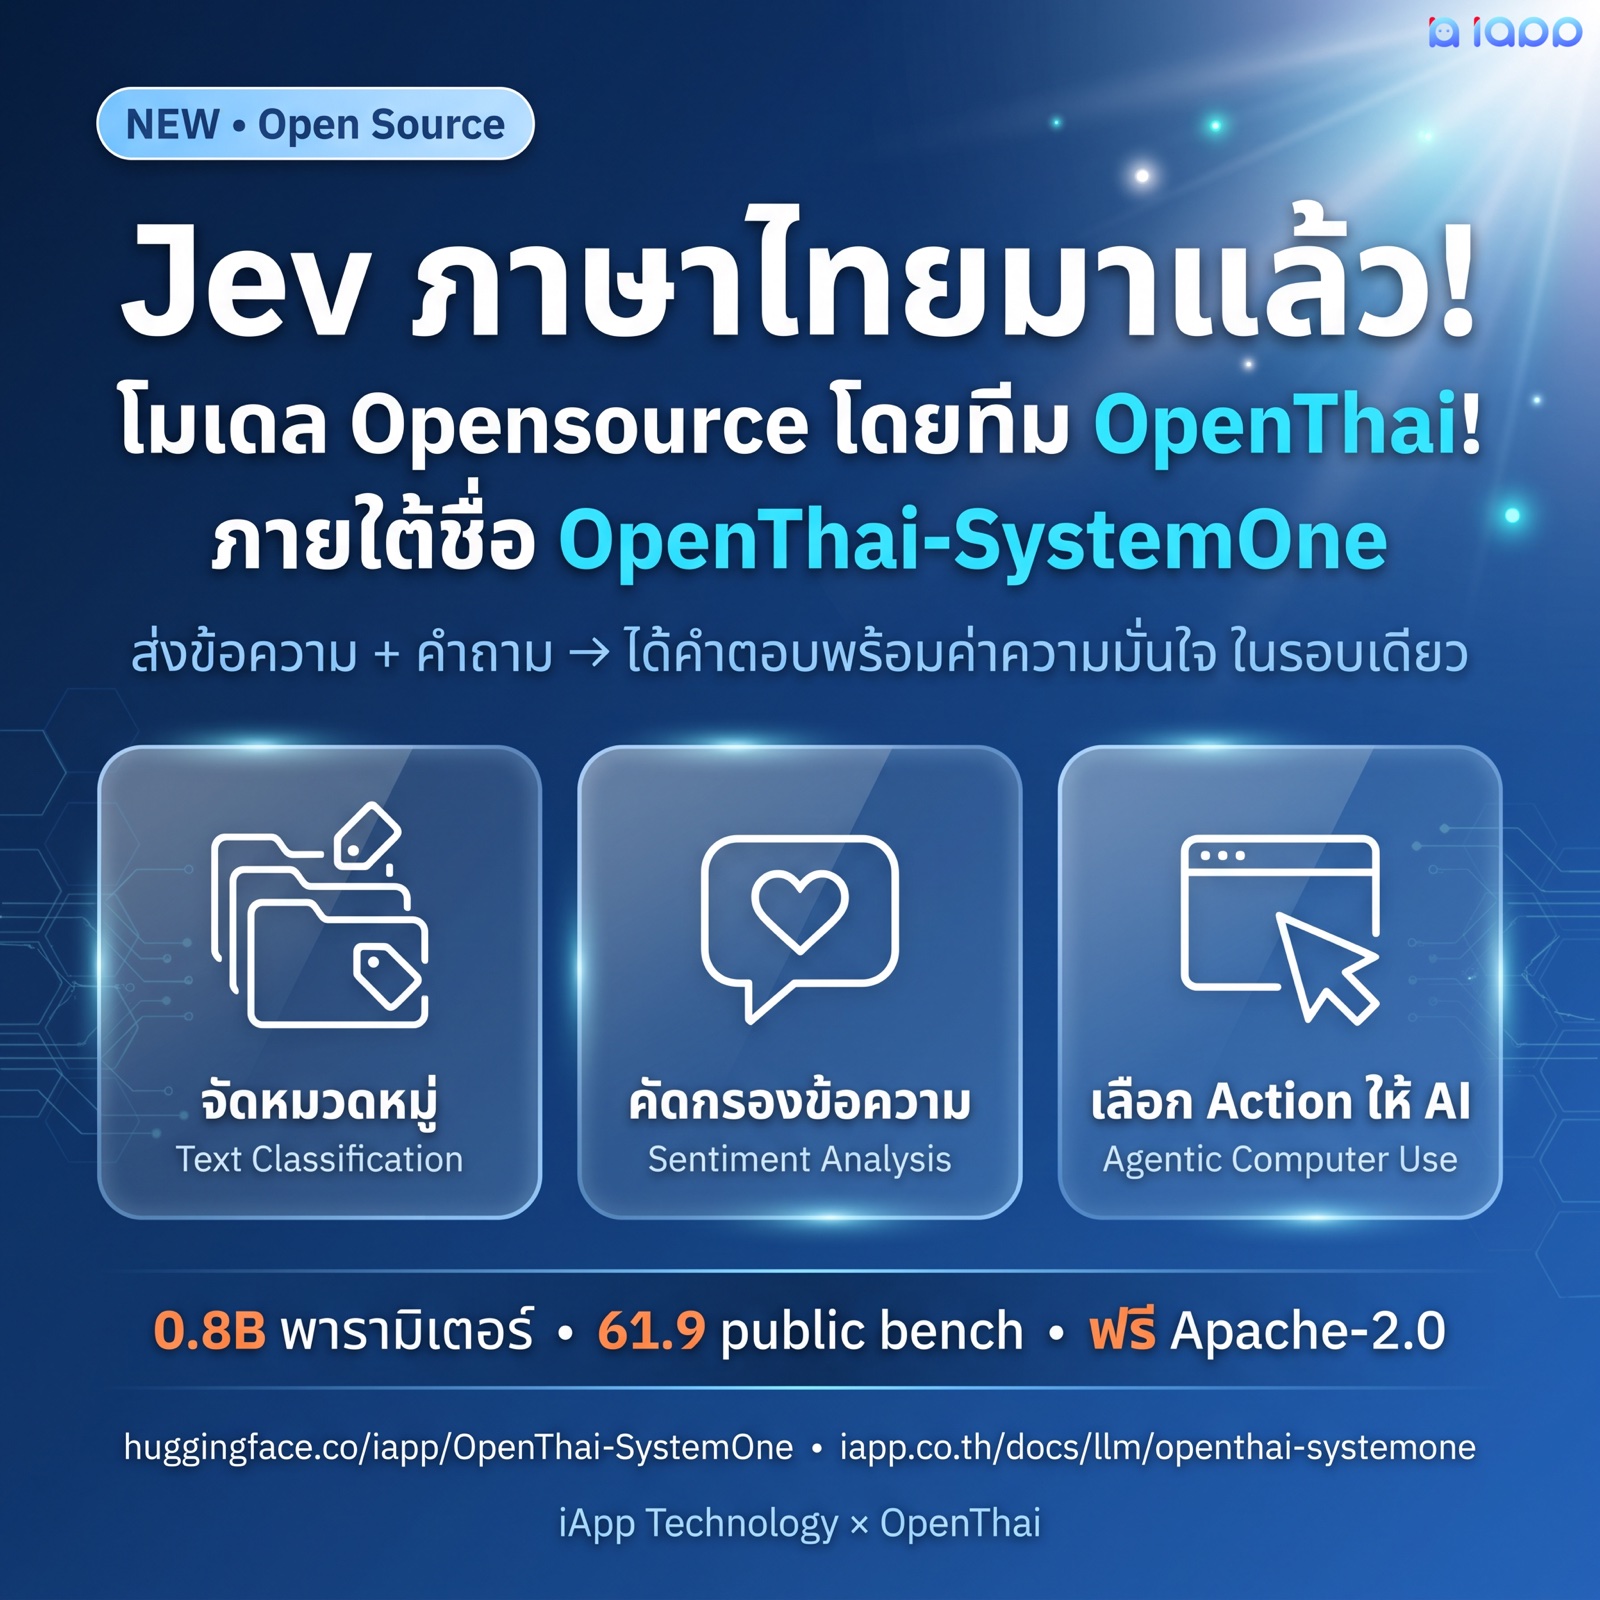
0.8B พารามิเตอร์v0.374.3 public benchฟรี Apache-2.0ไทย + อังกฤษ
ส่งข้อความ + คำถาม → ได้คำตอบพร้อมค่าความมั่นใจ ในรอบเดียว
5 วันหลัง TypeSafe เปิดตัว Jev ("System One model" ที่ไม่สร้างข้อความ แต่ตอบเป็นการตัดสินใจพร้อมความน่าจะเป็นในรอบเดียว) ทีม OpenThai ทำเวอร์ชันโอเพนซอร์สสำหรับภาษาไทย+อังกฤษออกมาแล้ว ภายใต้ชื่อ OpenThai-SystemOne
- โมเดล 0.8B พารามิเตอร์ รันบนโน้ตบุ๊กได้
- ฐาน Qwen3.5-0.8B เทรนต่อด้วยข้อความไทย ~5 พันล้านโทเคน แล้วเปลี่ยนหัวโมเดลจาก 248k คำ เป็น "หัวตัดสินใจ 256 ช่อง"
- ป้อน state (ข้อความ/JSON) + คำถามแบบ เลือกตัวเลือก / ให้คะแนน / ใช่-ไม่ใช่ → ได้คำตอบทุกข้อพร้อมความมั่นใจในการคำนวณรอบเดียว
- ผลบน public benchmark 13 ชุดเดียวกับ Bespoke-Nimble-9B: เรา 74.3 (v0.3) / Nimble-9B 74.8 / Jev 76.0 (ห่างโมเดล 9B แค่ 0.5 จุด และนำใน 8 จาก 13 ชุด) และงานภาษาไทย: intent 90.0%, หัวข้อข่าว 98.1%, XNLI-th 77.1%
- ใช้ทำ: จัดหมวดหมู่ (Text Classification), คัดกรองข้อความ (Sentiment Analysis), เลือก Action ให้ AI (Agentic Computer Use)
- Apache-2.0 เปิดหมด ทั้งน้ำหนักโมเดล สคริปต์เทรน คอนฟิก และข้อมูลสังเคราะห์
รูปแบบ API เหมือน POST /v1/systemone ของ TypeSafe AI (Jev) จึงชี้โค้ดเดิมมาที่โมเดลนี้ได้ทันที
ลองเล่นในเบราว์เซอร์
ลองเล่น OpenThai-SystemOne ในเบราว์เซอร์ + เอกสาร APIiapp.co.th/docs/llm/openthai-systemone
ดาวน์โหลดและติดตั้ง
โค้ด คอนฟิก และสคริปต์เทรนทั้งหมด — GitHubgithub.com/iapp-technology/openthai-systemone
pip install openthai-systemone # หรือ: pip install "git+https://github.com/iapp-technology/openthai-systemone"
ลองใช้งาน
ตัวอย่างจริงจากโมเดล: ticket ลูกค้าหนึ่งข้อความ ถามสองคำถาม ได้คำตอบทั้งหมดในการคำนวณรอบเดียว (91 โทเคนขาเข้า, 0 โทเคนขาออก)
curl -s https://api.iapp.co.th/v3/store/openthai/systemone -H "apikey: $IAPP_API_KEY" -H "content-type: application/json" -d '{
  "state": {"ticket": "โดนหักเงินซ้ำสองครั้ง ขอเงินคืนด่วน"},
  "questions": {
    "department": {"type": "choice", "instructions": "ทีมใดควรรับผิดชอบ",
                   "criteria": {"billing": "การเงิน/คืนเงิน", "technical": "ระบบใช้งานไม่ได้", "sales": null}},
    "refund":     {"type": "noul", "instructions": "ลูกค้าขอเงินคืนหรือไม่"}
  }}'
{"answers": {"department": {"choice": "billing", "probabilities": {"billing": 0.972, "technical": 0.009, "sales": 0.018}, "confidence": 0.87},
             "refund": {"noul": 0.954}}, "usage": {"input_tokens": 91, "output_tokens": 0}}
🔑 API สาธารณะ (พรีวิวฟรี)
endpoint https://api.iapp.co.th/v3/store/openthai/systemone ใช้ iApp API key ใดก็ได้ (สมัครฟรี) ช่วงพรีวิวคิด 0 เครดิต จำกัด 1,000 การตัดสินใจต่อวันต่อ key และ 100 คำขอต่อนาที ราคาต่อการตัดสินใจจะประกาศในเดือนตุลาคม 2569 API ตอนนี้รัน v0.3 (checkpoint เดียวกับน้ำหนักบน Hugging Face) รายละเอียดและ playground อยู่ที่ iapp.co.th/docs/llm/openthai-systemone หรือรันโมเดลบนเครื่องของคุณเองตามตัวอย่างด้านล่าง
รันบนเครื่องคุณเอง (CUDA, Apple MPS หรือ CPU)
from openthai_systemone import SystemOneClient, Choice, Score, Noul

c = SystemOneClient("iapp/OpenThai-SystemOne")
r = c.system_one(
    state={"ticket": "โดนหักเงินซ้ำสองครั้ง ขอเงินคืนด่วน โทรไปสามรอบแล้วไม่มีใครรับ"},
    questions={
        "department": Choice(instructions="ทีมใดควรรับผิดชอบ", criteria={"billing": "การเงิน/คืนเงิน", "technical": "ระบบใช้งานไม่ได้", "sales": None}),
        "frustration": Score(instructions="ลูกค้าหงุดหงิดแค่ไหน", criteria=["ใจเย็น", "หงุดหงิดแต่สุภาพ", "โกรธมาก"]),
        "refund": Noul(instructions="ลูกค้าขอเงินคืนอย่างชัดเจนหรือไม่"),
    },
)
print(r.answers["department"].choice, r.answers["department"].probabilities)
print(r.answers["frustration"].score, r.answers["refund"].noul)
เปิดเป็น HTTP server ที่ใช้ contract เดียวกับ POST /v1/systemone
OPENTHAI_SYSTEMONE_MODEL=iapp/OpenThai-SystemOne uvicorn openthai_systemone.server:app --port 8000
หรือโหลดด้วย transformers ตรง ๆ (remote code อยู่ในรีโปโมเดล)
from transformers import AutoModel
model = AutoModel.from_pretrained("iapp/OpenThai-SystemOne", trust_remote_code=True)
🎮 เดโม: เล่น Doom โดยไม่เห็นภาพ ไม่สร้างข้อความ
โมเดลควบคุมตัวละครใน Doom (ViZDoom) แบบเรียลไทม์ ทุก 4 tic ของเกม state เชิงสัญลักษณ์ของเอนจินถูกแปลงเป็นข้อความ เช่น
health 100/100 | ammo 50 | kills 1
crosshair: empty; nearest visible enemy 39deg to the RIGHT
enemies: Zombieman 5m right -39deg VISIBLE; ChaingunGuy 19m right -24deg; Zombieman 19m ahead -12deg
items: GreenArmor 41m right -18deg
depth ahead: 35/255 (obstacle near)
last actions: ATTACK ATTACK ATTACK ATTACK
แล้วโมเดลตอบสองคำถามในการคำนวณรอบเดียว: choice เลือก 1 ใน 7 การกระทำ (ปุ่มที่จะกด) และ noul "มีศัตรูอยู่ในเป้าเล็งหรือไม่" ใช้เวลาราว 41 มิลลิวินาทีต่อการตัดสินใจบน H100 หนึ่งใบ (ราว 24 การตัดสินใจต่อวินาที) 0 โทเคนขาออก และไม่มีข้อมูล Doom ในการเทรนเลย ทุกอย่างมาจากการอ่าน state และคำอธิบายตัวเลือก มันยิงพลาดและตายในด่านยาก ประเด็นคือความเร็วกับความน่าจะเป็นที่ calibrate แล้ว ซึ่งเป็นกลไกเดียวกับที่ใช้จัดเส้นทาง ticket หรือเลือกปุ่มให้ agent
รันบนเครื่องคุณเอง (ใช้ iApp API key หรือน้ำหนักโมเดลในเครื่อง มี HUD ภาษาไทย/อังกฤษ และบันทึกวิดีโอได้): github.com/iapp-technology/openthai-systemone-doom
🇹🇭 ตัวอย่างงานไทย (ผลจริงจาก v0.3 ผ่าน API, 22 ก.ย. 2569)
เจ็ดงานไทยในชีวิตประจำวัน แต่ละข้อตอบในการคำนวณรอบเดียว ความน่าจะเป็นคือผลลัพธ์จริงของโมเดล
| งาน | state (ย่อ) | คำถาม | คำตอบ |
|---|---|---|---|
| จัดเส้นทาง ticket | "แอปโอนเงินไม่ได้ตั้งแต่เมื่อคืน ขึ้น error 502 ตลอด … ต้องโอนค่าเทอมลูกพรุ่งนี้" | ทีมใดรับผิดชอบ (4 ทีม) · ความเร่งด่วน (score) · ใช้ถ้อยคำสุภาพหรือไม่ | technical 72% (billing 27%) · 2.13 = เร่งด่วน (85%) · สุภาพ 1% (ผิด ดูหมายเหตุ) |
| หัวข้อข่าว | "ครม. เห็นชอบขึ้นค่าแรงขั้นต่ำเป็น 400 บาททั่วประเทศ … สภาอุตสาหกรรมกังวลกระทบ SME" | หัวข้อ (8 หมวด) · เกี่ยวกับแรงงานหรือไม่ | เศรษฐกิจ 62% (แรงงาน 36%) · 98% |
| intent ผู้ช่วย | "ช่วยตั้งปลุกตอนหกโมงครึ่งพรุ่งนี้ให้หน่อย แล้วก็เปิดเพลงเบาๆ ตอนตื่นด้วย" | intent (10 แบบ) | alarm set 99.5% |
| คัดกรองคอมเมนต์ | คอมเมนต์ด่าหยาบคาย | เป็นพิษหรือไม่ · ความรู้สึก | เป็นพิษ 94% · เชิงลบ 97% |
| ตอบได้จากเอกสารหรือไม่ | ข้อความเรื่องสะพานพระราม 8 (เปิด 7 พ.ค. 2545 ยาว 475 ม.) | "สะพานยาวเท่าไร" ตอบได้หรือไม่ · "ระบุงบประมาณหรือไม่" | 98.5% · 0.6% |
| เลือกเครื่องมือให้ agent | งาน "จองโต๊ะร้านอาหาร 4 คน คืนนี้สองทุ่ม" ประวัติแสดงว่า search_restaurants เจอโต๊ะว่างแล้ว | เครื่องมือถัดไป (5 ตัว) | make_reservation 96.5% |
| RAG relevance + ดึงค่า | คำถามภาษีหัก ณ ที่จ่ายค่าเช่าอาคาร + ข้อความระบุ 5% | ข้อความเกี่ยวข้องหรือไม่ · อัตรา | 98% · 5% (76%) |
หมายเหตุข้อแรก: ticket ใช้ "รบกวน…นะครับ" คำตอบที่ถูกคือ สุภาพ แต่โมเดลตอบว่าไม่ที่ 99% การตัดสินความสุภาพของภาษาไทยทางการยังเป็นช่องว่างที่รู้แล้ว และจะได้ชุดข้อมูลเฉพาะใน v0.4 เราคงตัวอย่างที่พลาดไว้ เพราะ showcase ที่มีแต่ข้อที่ถูกไม่มีประโยชน์
คำถาม 3 แบบ
| ประเภท | คุณให้ | คุณได้ |
|---|---|---|
choice | คำสั่ง + ตัวเลือกได้ถึง 255 ตัว (ชื่อ → คำอธิบาย หรือ null) | choice, probabilities ของทุกตัวเลือก, confidence |
score | คำสั่ง + ระดับเรียงลำดับ 2–10 ระดับ | score (ถ่วงน้ำหนักด้วยความน่าจะเป็น มีทศนิยมได้), probabilities, confidence |
noul | คำถามใช่/ไม่ใช่ | noul = ความน่าจะเป็นที่คำตอบคือ "ใช่" |
ทุกคำถามในหนึ่งคำขอถูกตอบพร้อมกันในการคำนวณรอบเดียว confidence คือ 1 − เอนโทรปีที่ normalise แล้ว และมีค่า abstain = ความน่าจะเป็นที่ไม่มีตัวเลือกใดเหมาะเลย
📊 ตัวเลข (v0.3, 22 ก.ย. 2569)
ทุกตัวเลขเป็น zero-shot โมเดลเห็นเพียง state คำสั่ง และชื่อ/คำอธิบายตัวเลือก และเป็นผลของ v0.3 ที่ผ่านขั้น calibration แล้ว (ตัวเลขของเวอร์ชันก่อนหน้าอยู่ในตารางเวอร์ชันด้านล่าง)
Public benchmark 13 ชุดของ Bespoke Labs (แหล่งข้อมูล split คำสั่ง และตัวสุ่มตัวอย่างชุดเดียวกับที่ใช้เทียบ Jev) choice/noul รายงานความแม่นยำ score รายงานการตรงระดับพอดี ตัวหนาคือชุดที่โมเดล 0.8B นำ Nimble-9B
| ชุดทดสอบ | ประเภท | n | OpenThai-SystemOne 0.8B | Nimble-9B | Jev 1.13.0 | ECE ของเรา |
|---|---|---|---|---|---|---|
| aegis2 | noul | 250 | 83.2 | 81.2 | 80.4 | 0.065 |
| boolq | noul | 300 | 79.7 | 86.0 | 89.7 | 0.049 |
| civil_comments | noul | 300 | 79.0 | 70.3 | 81.0 | 0.087 |
| helpsteer2 | score | 250 | 41.6 | 39.0 | 34.1 | 0.371 |
| massive-de-DE | choice | 350 | 88.3 | 83.4 | 86.9 | 0.057 |
| massive-en-US | choice | 350 | 88.3 | 86.9 | 87.4 | 0.070 |
| multinli | choice | 299 | 89.0 | 85.3 | 82.9 | 0.053 |
| paws | noul | 250 | 94.0 | 82.8 | 89.2 | 0.035 |
| pubmedqa | choice | 250 | 64.0 | 75.6 | 77.2 | 0.259 |
| squad2 | noul | 299 | 89.3 | 80.6 | 82.9 | 0.041 |
| summeval-consistency | score | 144 | 75.0 | 75.7 | 81.2 | 0.076 |
| summeval-relevance | score | 240 | 21.7 | 49.2 | 35.0 | 0.356 |
| vitaminc-dev | choice | 599 | 72.5 | 76.6 | 80.1 | 0.118 |
| ค่าเฉลี่ย macro | 74.3 | 74.8 | 76.0 |
อ่านตรง ๆ: โมเดล 0.8B ทำค่าเฉลี่ย 74.3 ห่างจาก Nimble-9B (74.8) เพียง 0.5 จุด และนำใน 8 จาก 13 ชุด (aegis2, civil_comments, helpsteer2, massive-de, massive-en, multinli, paws, squad2) ที่ยังตามหลังชัดคือ pubmedqa (64.0) กับการให้คะแนนบทสรุปทั้งสองแบบ (relevance 21.7, consistency 75.0 ซึ่งถดถอยจาก 84.0 ใน v0.2) ECE ดีขึ้นใน 11 จาก 13 ชุด ตัวเลขของ Nimble-9B และ Jev ตามที่ Bespoke Labs เผยแพร่ (18 ก.ย. 2569) ส่วนของเราวัดด้วย scripts/06_eval.py บนชุดข้อมูลที่ scripts/06b_public_benchmarks.py สร้างขึ้นใหม่จากแหล่งเดียวกัน หมายเหตุ: ตั้งแต่ v0.3 ชุด train ของ SQuAD2, BoolQ, PAWS, Aegis2 และ MASSIVE-de อยู่ในข้อมูลเทรนแล้ว ส่วน benchmark ยังใช้เฉพาะ split validation/test เพื่อเทียบสเกล Bespoke รายงาน Qwen3.5-0.8B ดิบที่ 45.4 บนชุดทดสอบส่วนตัว 324 ข้อของพวกเขา (Nimble-9B 90.1, Jev 93.2) ไม่ใช่บน benchmark นี้
ชุดทดสอบภาษาไทยที่กันออกจากการเทรน (ชุด eval เต็ม ชุดที่มี * กันออกทั้งชุดข้อมูล ECE ยิ่งต่ำยิ่ง confidence เชื่อถือได้)
| ชุดทดสอบ | งาน | ความแม่นยำ | ECE | หมายเหตุ |
|---|---|---|---|---|
| Prachathai67k | หัวข้อข่าว (choice) | 98.1 | 0.004 | v0.2: 97.6 |
| Prachathai67k | หัวข้อข่าว แบบใช่/ไม่ใช่ (noul) | 94.2 | 0.008 | |
| MASSIVE-th | จับ intent 60 แบบ (choice) | 90.0 | 0.043 | v0.2: 88.6 |
| XNLI-th | อนุมานความหมาย NLI (choice) | 77.1 | 0.045 | |
| XNLI-th | entailment แบบใช่/ไม่ใช่ (noul) | 84.3 | 0.049 | |
| SIB-200 Thai* | หัวข้อ 7 แบบ (choice) | 77.9 | 0.084 | กลับมาจาก 74.0 ใน v0.2 |
| คู่ประโยคไทยเปลี่ยนข้อเท็จจริงเดียว | choice / noul / score | 80.7 / 83.5 / 78.6 | 0.098 / 0.109 / 0.156 | |
| Wongnai | ดาวรีวิว 1–5 (score) | 63.5 ตรงเป๊ะ (MAE 0.44) | 0.039 | |
| xLAM tool selection (อังกฤษ) | เลือกเครื่องมือ (choice) | 99.4 | 0.006 | |
| Wisesight* | ความรู้สึกโซเชียล 4 แบบ (choice) | 51.6 | 0.353 | ยังเป็นชุดไทยที่อ่อนที่สุด ใช้ order-invariant mode |
| banking77* (อังกฤษ) | intent 77 แบบ (choice) | 45.4 | 0.236 | v0.2: 37.8 (61.7 ด้วย order-invariant mode บน v0.2) |
ค่า confidence เชื่อถือได้บนชุดภาษาไทยและงาน NLI/หัวข้อ (ECE ไม่เกิน 0.05) ส่วนงานให้คะแนนหลายระดับภาษาอังกฤษ (helpsteer2, summeval-relevance) ECE ยังสูง ควรส่งเคสที่ confidence ต่ำไปโมเดลใหญ่หรือคน
โหมดไม่ขึ้นกับลำดับตัวเลือก — การคำนวณรอบเดียวไวต่อลำดับของตัวเลือกเช่นเดียวกับ Jev (วัดบน v0.2: คำตอบ argmax เปลี่ยน 5–12% เมื่อสุ่มสลับลำดับที่ ≤ 10 ตัวเลือก และ 72% บน banking77 ที่มี 77 ตัวเลือก) client และ API จึงมี order-invariant mode ที่เฉลี่ยคำตอบจากการหมุนลำดับตัวเลือกหลายแบบใน batch เดียว (order_invariant: true / permutations: n เปิดอัตโนมัติสำหรับ choice ที่มีมากกว่า 10 ตัวเลือก) บนคำถามภาษาไทยที่กันออก 360 ข้อ: คำตอบเปลี่ยน 18.9% → 3.3%, ความน่าจะเป็นเลื่อนเฉลี่ย 0.19 → 0.08, ความแม่นยำ 68.6 → 73.6, banking77 41.7 → 63.3 ต้นทุนคือ latency ราว 2 เท่า (batched) โดย usage.input_tokens ไม่เพิ่ม
ความเร็ว — คำขอ 3 คำถามใช้เวลาราว 40 มิลลิวินาทีบน H100 และ 154 มิลลิวินาทีบน MacBook M3 Max (Apple GPU ผ่าน MPS) ไป-กลับผ่าน API จากโน้ตบุ๊กราว 170–220 มิลลิวินาทีรวมเครือข่าย คำถามที่มี 255 ตัวเลือกใช้ 44 มิลลิวินาทีบน H100 และ 1.5 วินาทีบน MacBook ส่วน CPU ล้วนยังช้า (ราว 4.6 วินาที) แนะนำให้ใช้ GPU หรือ MPS
⚙️ ทำงานอย่างไร

- แกนโมเดล — text tower ของ Qwen3.5-0.8B-Base (24 ชั้น ผสม Gated-DeltaNet กับ attention บริบท 262k) ตัด vision encoder ออก แล้ว เทรนต่อด้วยข้อความไทยราว 5 พันล้านโทเคน (เว็บ Wikipedia คู่แปลไทย-อังกฤษ และข้อความสถานะเครื่อง เช่น accessibility tree และ JSON)
- หัวตัดสินใจ — หัว LM ขนาด 248k คำถูกแทนด้วยหัว 256 ช่อง ตัวเลือกแต่ละตัวถูกแนะนำด้วย control token
<|ts_opt_0|> … <|ts_opt_254|>hidden state ที่ตำแหน่ง<|ts_answer|>ของแต่ละคำถามถูกฉายเป็น logit 256 ค่า ช่องที่เกินจำนวนตัวเลือกถูก mask ออก แล้ว softmax ให้การแจกแจง ช่อง 255 คือ abstain (ไม่มีตัวเลือกใดเหมาะ) - การอ่านผล —
choice= ตัวเลือกที่ความน่าจะเป็นสูงสุด,score= Σ pᵢ·i บนระดับที่เรียงลำดับ,noul= p(ใช่) - ไม่มี position bias — ลำดับตัวเลือกถูกสลับระหว่างเทรน และมีตัวอย่าง abstain ปนอยู่ด้วย จึงไม่ใช่ trick อ่าน logprob ของตัวอักษร A/B/C
🔬 สูตรการเทรน
ทุกขั้นตอนอยู่ใน รีโป GitHub หนึ่งสคริปต์ต่อหนึ่งขั้น ทำซ้ำได้บน H100 ใบเดียว
scripts/00_prepare_base.py— ตัด vision encoder ของ Qwen3.5-0.8B ออก เหลือ text tower (752M พารามิเตอร์)scripts/01_cpt_data.py+scripts/02_cpt_train.py— CPT เน้นภาษาไทย (FineWeb-2 ไทยที่กรองแล้ว, Thai Wikipedia, ข้อความคำสั่ง/สรุปภาษาไทย, OPUS ไทย↔อังกฤษ, FineWeb-Edu replay, accessibility tree และ JSON สังเคราะห์) H100 1 ใบ ราว 40 ชั่วโมง perplexity บนชุดกันออก 31.4 → 5.38scripts/03_decision_data.py— 1.81 ล้านตัวอย่างการตัดสินใจ แปลงจากชุดข้อมูลสาธารณะ 21 ชุด (ไทย: wisesight*, wongnai, prachathai, XNLI-th, MASSIVE-th, SIB-200*, ThaiExam, iapp_wiki_qa, Thai toxicity; อังกฤษ: MNLI, MMLU, ARC, HelpSteer2, AG News, DBpedia, CLINC, banking77*, Mind2Web, xLAM tools) ชุดที่มี * กันออกทั้งชุดเพื่อใช้ทดสอบเท่านั้นscripts/03b_synth_generate.py— งานตัดสินใจไทย/อังกฤษสังเคราะห์ราว 100k ชุด สร้างด้วย Qwen3.6-35B-A3B ติดป้ายซ้ำแบบ blind และกรองการรั่วของคำตอบ (ชุดข้อมูลiapp/openthai2.0-systemone-synth)scripts/04_decision_train.py— เปลี่ยนหัวโมเดล + SFT 12k step แล้วต่อด้วยขั้น calibration (Brier loss + temperature แยกตามประเภทคำถาม) เพื่อให้ confidence สูง ⇒ ความแม่นยำสูงจริง v0.2 เทรนต่อจาก v0.1 อีก 3,000 step ด้วยชุดความรู้สึกโซเชียลไทยสังเคราะห์ 22k รายการ (4 คลาสรวม "คำถาม", แบบ 3/5 คลาส, ใช่/ไม่ใช่, score 5 ระดับ) แล้ว calibrate ใหม่ v0.3 เทรนต่อจาก v0.2 อีก 5,000 step ด้วยชุด train จริง 177k รายการ (SQuAD2, BoolQ, PubMedQA-artificial, PAWS, Aegis2, ToxicChat, XQuAD-th, MASSIVE-de) และชุดสังเคราะห์เฉพาะจุดอ่อน 78k รายการ (QA ใช่/ไม่ใช่แบบอิงเอกสาร, ให้คะแนนบทสรุป, intent ละเอียด 40–120 แบบ, safety, paraphrase) ลดน้ำหนักชุดความรู้สึกจาก 4× เป็น 2× แล้ว calibrate ใหม่scripts/06b_public_benchmarks.py— สร้าง public benchmark 13 ชุดของ Bespoke Nimble ขึ้นใหม่ เพื่อเทียบแบบ like-for-like
👨👩👧 ตระกูล OpenThai 2.0
| โมเดล | ทำอะไร | ขนาด | สถานะ |
|---|---|---|---|
| OpenThai 2.0 | LLM สนทนา/ให้เหตุผลภาษาไทย อ่านภาพได้ | 27B | เปิดตัวแล้ว |
| OpenThai 2.0 Legal | โมเดลกฎหมายไทยสำหรับ RAG | 30B-A3B | เปิดตัวแล้ว |
| OpenThai-SystemOne | โมเดลตัดสินใจไทย+อังกฤษ (ไม่สร้างข้อความ) | 0.8B | เปิดตัวแล้ว |
| OpenThai-SystemOne CPT | โมเดลฐานที่เทรนต่อด้วยภาษาไทย (สำหรับงานวิจัย) | 0.8B | ยังไม่เปิด |
⚠️ ข้อจำกัด
- เวอร์ชัน 0.3 — โมเดล 0.8B ไม่ใช่โมเดลคิดวิเคราะห์ ไม่ทำการตรวจสอบหลายขั้นหรือคำนวณเลข
- ตอบได้เฉพาะตัวเลือกที่ให้ แต่ยังผิดได้ — โมเดลปล่อยตัวเลือกที่ไม่มีอยู่ไม่ได้ แต่เลือกผิดได้ ใช้ค่า
confidenceแล้วส่งเคสที่ไม่มั่นใจไปโมเดลใหญ่หรือคน - ข้อความอย่างเดียว — ไม่รับรูปภาพ สูงสุด 255 ตัวเลือกต่อคำถาม (มากกว่านั้นให้แบ่งเป็นกลุ่ม) และ 64k โทเคนต่อคำขอ
- CPU ล้วนยังช้า — ใช้ GPU หรือ Apple MPS
- จุดอ่อนของ v0.3 ที่รู้แล้ว — งานให้คะแนน 5 ระดับทั้งสองแบบ (relevance ของบทสรุป 22, helpfulness 42), intent ภาษาอังกฤษแบบละเอียด 77 แบบ (banking77 45 แบบลำดับเดียว), ความรู้สึกในโซเชียลไทย (Wisesight 52), PubMedQA 3 ทาง (64) และการตัดสินความสุภาพของภาษาไทยทางการ (ชุดข้อมูลเฉพาะใน v0.4)
- ไวต่อลำดับตัวเลือก — เช่นเดียวกับ Jev คำตอบจากรอบเดียวอาจเปลี่ยนเมื่อสลับลำดับตัวเลือก ใช้
order_invariant: true(เปิดอัตโนมัติเมื่อมีมากกว่า 10 ตัวเลือก) แลกกับ latency ราว 2 เท่า - calibration ภาษาอังกฤษอ่อนกว่าไทย — ECE มัธยฐาน 0.15 เทียบกับไม่เกิน 0.05 เพราะชุดเทรนเน้นภาษาไทยโดยตั้งใจ
🗓 เวอร์ชัน
| เวอร์ชัน | วันที่ | สิ่งที่เปลี่ยน | public macro | Wisesight |
|---|---|---|---|---|
| v0.3 | 22 ก.ย. 2569 | เทรนต่อจาก v0.2 อีก 5,000 SFT step ด้วยชุด train จริง 177k + ชุดสังเคราะห์เฉพาะจุดอ่อน 78k รายการ (QA อิงเอกสาร, ให้คะแนนบทสรุป, intent ละเอียด, safety, paraphrase) แล้ว calibrate ใหม่ | 74.3 | 51.6 |
| v0.2 | 21 ก.ย. 2569 | เทรนต่อจาก v0.1 อีก 3,000 SFT step ด้วยชุดความรู้สึกโซเชียลไทยสังเคราะห์ 22k รายการ แล้ว calibrate ใหม่ เพิ่ม order-invariant mode ใน client และ API | 63.2 | 51.5 |
| v0.1 | 20 ก.ย. 2569 | เปิดตัวครั้งแรก: Thai CPT 4.47B โทเคน, SFT 12k step, calibration | 61.9 | 38.7 |
v0.3 ขยับ SQuAD2 50.2 → 89.3, PAWS 68.0 → 94.0, Aegis2 61.6 → 83.2, MASSIVE-de 67.4 → 88.3, BoolQ 64.7 → 79.7, MASSIVE-en 79.1 → 88.3, PubMedQA 56.4 → 64.0, SummEval-relevance 14.2 → 21.7, VitaminC 68.6 → 72.5, MultiNLI 87.3 → 89.0 และ ECE ดีขึ้นใน 11 จาก 13 ชุด ที่ถดถอยคือ SummEval-consistency 84.0 → 75.0 (ชุดสังเคราะห์ครอบคลุมเฉพาะระดับ 1/3/5 จะเพิ่มระดับ 2/4) ชุดไทยที่กันออกทั้งหมดเท่าเดิมหรือดีขึ้น (SIB-200 74.0 → 77.9, banking77 37.8 → 45.4) รายละเอียดเต็มอยู่ใน changelog ของ model card
🤝 ร่วมพัฒนา
- ชุดทดสอบภาษาไทยเพิ่ม — โดยเฉพาะงานที่มีตัวเลือกเยอะ ๆ และงาน UI/agent ส่งมาเป็น issue ใน GitHub ได้เลย
- GGUF / ONNX / MLX — หัวโมเดลเป็น Linear ธรรมดา ใครถนัดช่วยแปลงได้
- LoRA adapter เฉพาะ domain — ส่งมาแชร์กันตามแผน "1 base, N adapters"
- พูดคุยกันได้ที่ Discord OpenThaiGPT และ กลุ่ม Facebook
📄 สัญญาอนุญาตและเครดิต
Apache-2.0 พัฒนาโดย iApp Technology / OpenThaiGPT บน Qwen3.5-0.8B-Base (Apache-2.0) ได้แรงบันดาลใจจากโมเดล System One ของ TypeSafe AI (Jev) โดยเป็นการสร้างขึ้นใหม่แบบเปิดอย่างอิสระ ไม่มีส่วนเกี่ยวข้องกับ TypeSafe AI
🙏 ขอบคุณ Siam AI
การเทรนต่อด้วยข้อความไทย การ SFT และการประเมินผลทั้งหมดรันบน GPU NVIDIA H100 ที่ได้รับการสนับสนุนจาก บริษัท สยาม เอไอ คอร์เปอเรชั่น จำกัด ขอขอบคุณเป็นอย่างยิ่งที่ร่วมสนับสนุน AI ไทยแบบเปิดมาอย่างต่อเนื่อง