OpenThai 2.0: โมเดลเปิดตัวเดียวที่อ่านเอกสารไทย รู้เรื่องไทย และทำงานเอเจนต์ได้
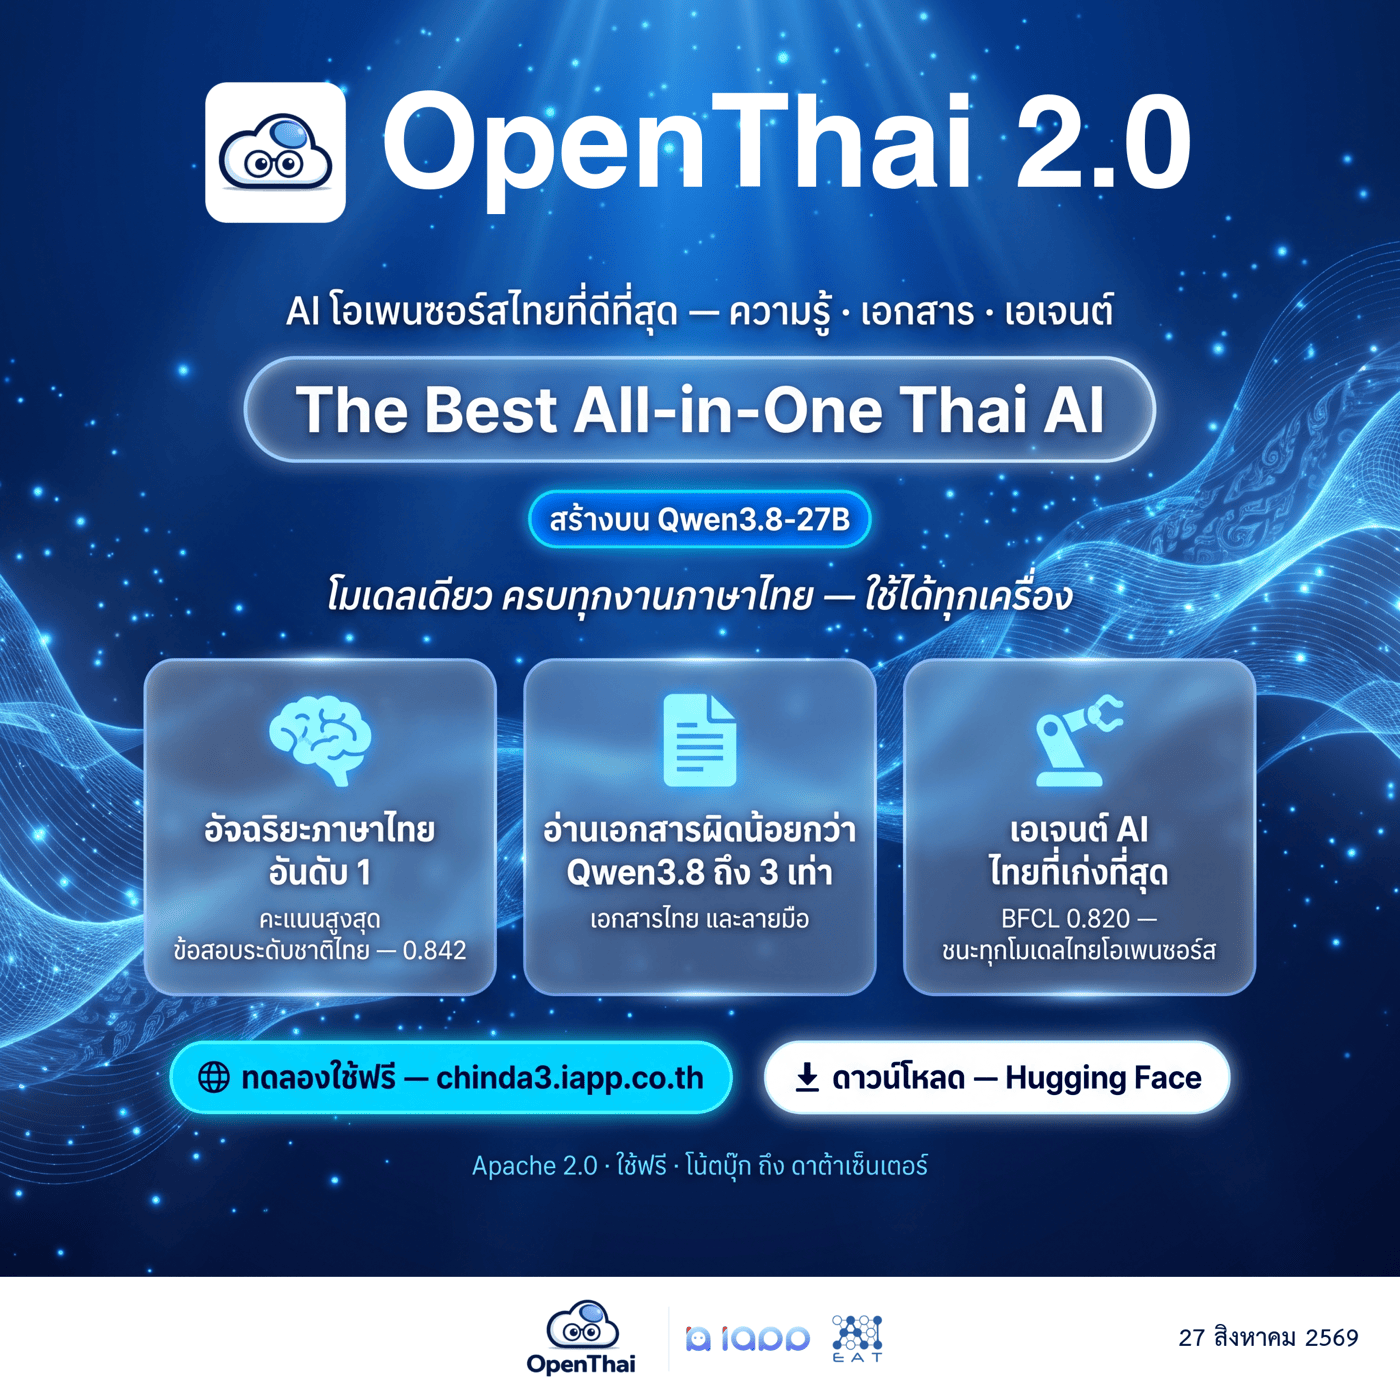
วันนี้เราเปิดน้ำหนักโมเดล OpenThai 2.0 (openthai2.0-qwen3.8-27b) ขนาด 27B ภายใต้สัญญาอนุญาต Apache 2.0 ดาวน์โหลดได้ฟรีบน Hugging Face ใช้ได้ทั้งงานวิจัยและงานเชิงพาณิชย์
สิ่งที่ทำให้โมเดลนี้ต่างออกไปไม่ใช่ตัวเลขใดตัวเลขหนึ่ง แต่คือการที่มันทำสามอย่างได้ในน้ำหนักชุดเดียว — อ่านเอกสารและลายมือไทย ตอบคำถามความรู้ไทย และเรียกใช้เครื่องมือแบบเอเจนต์ — โดยไม่ต้องต่อ OCR แยก ไม่ต้องส่งงานข้ามระบบ
ทำไม "โมเดลเดียว" ถึงสำคัญ
ระบบเอกสารภาษาไทยส่วนใหญ่ทุกวันนี้เป็นไปป์ไลน์: ส่งภาพเข้าโมเดล OCR เฉพาะทาง ได้ข้อความออกมา แล้วส่งข้อความนั้นต่อไปให้ LLM อีกตัวตอบคำถาม ทุกรอยต่อคือจุดที่ข้อมูลหล่นหาย — เลย์เอาต์หาย ตารางแตก ความมั่นใจของตัวอ่านไม่ถูกส่งต่อ และเมื่อคำตอบผิด คุณแยกไม่ออกว่าผิดที่ขั้นอ่านหรือขั้นตอบ
OpenThai 2.0 เป็นโมเดลเปิดภาษาไทยตัวเดียวในการเปรียบเทียบของเรา ที่อ่านเอกสารได้ในระดับใกล้เคียงโมเดลเฉพาะทาง และ ตอบคำถามเกี่ยวกับเอกสารนั้นได้ในตัวเอง ภาพกับความรู้อยู่ในน้ำหนักชุดเดียวกัน
ตัวเลขที่สำคัญ
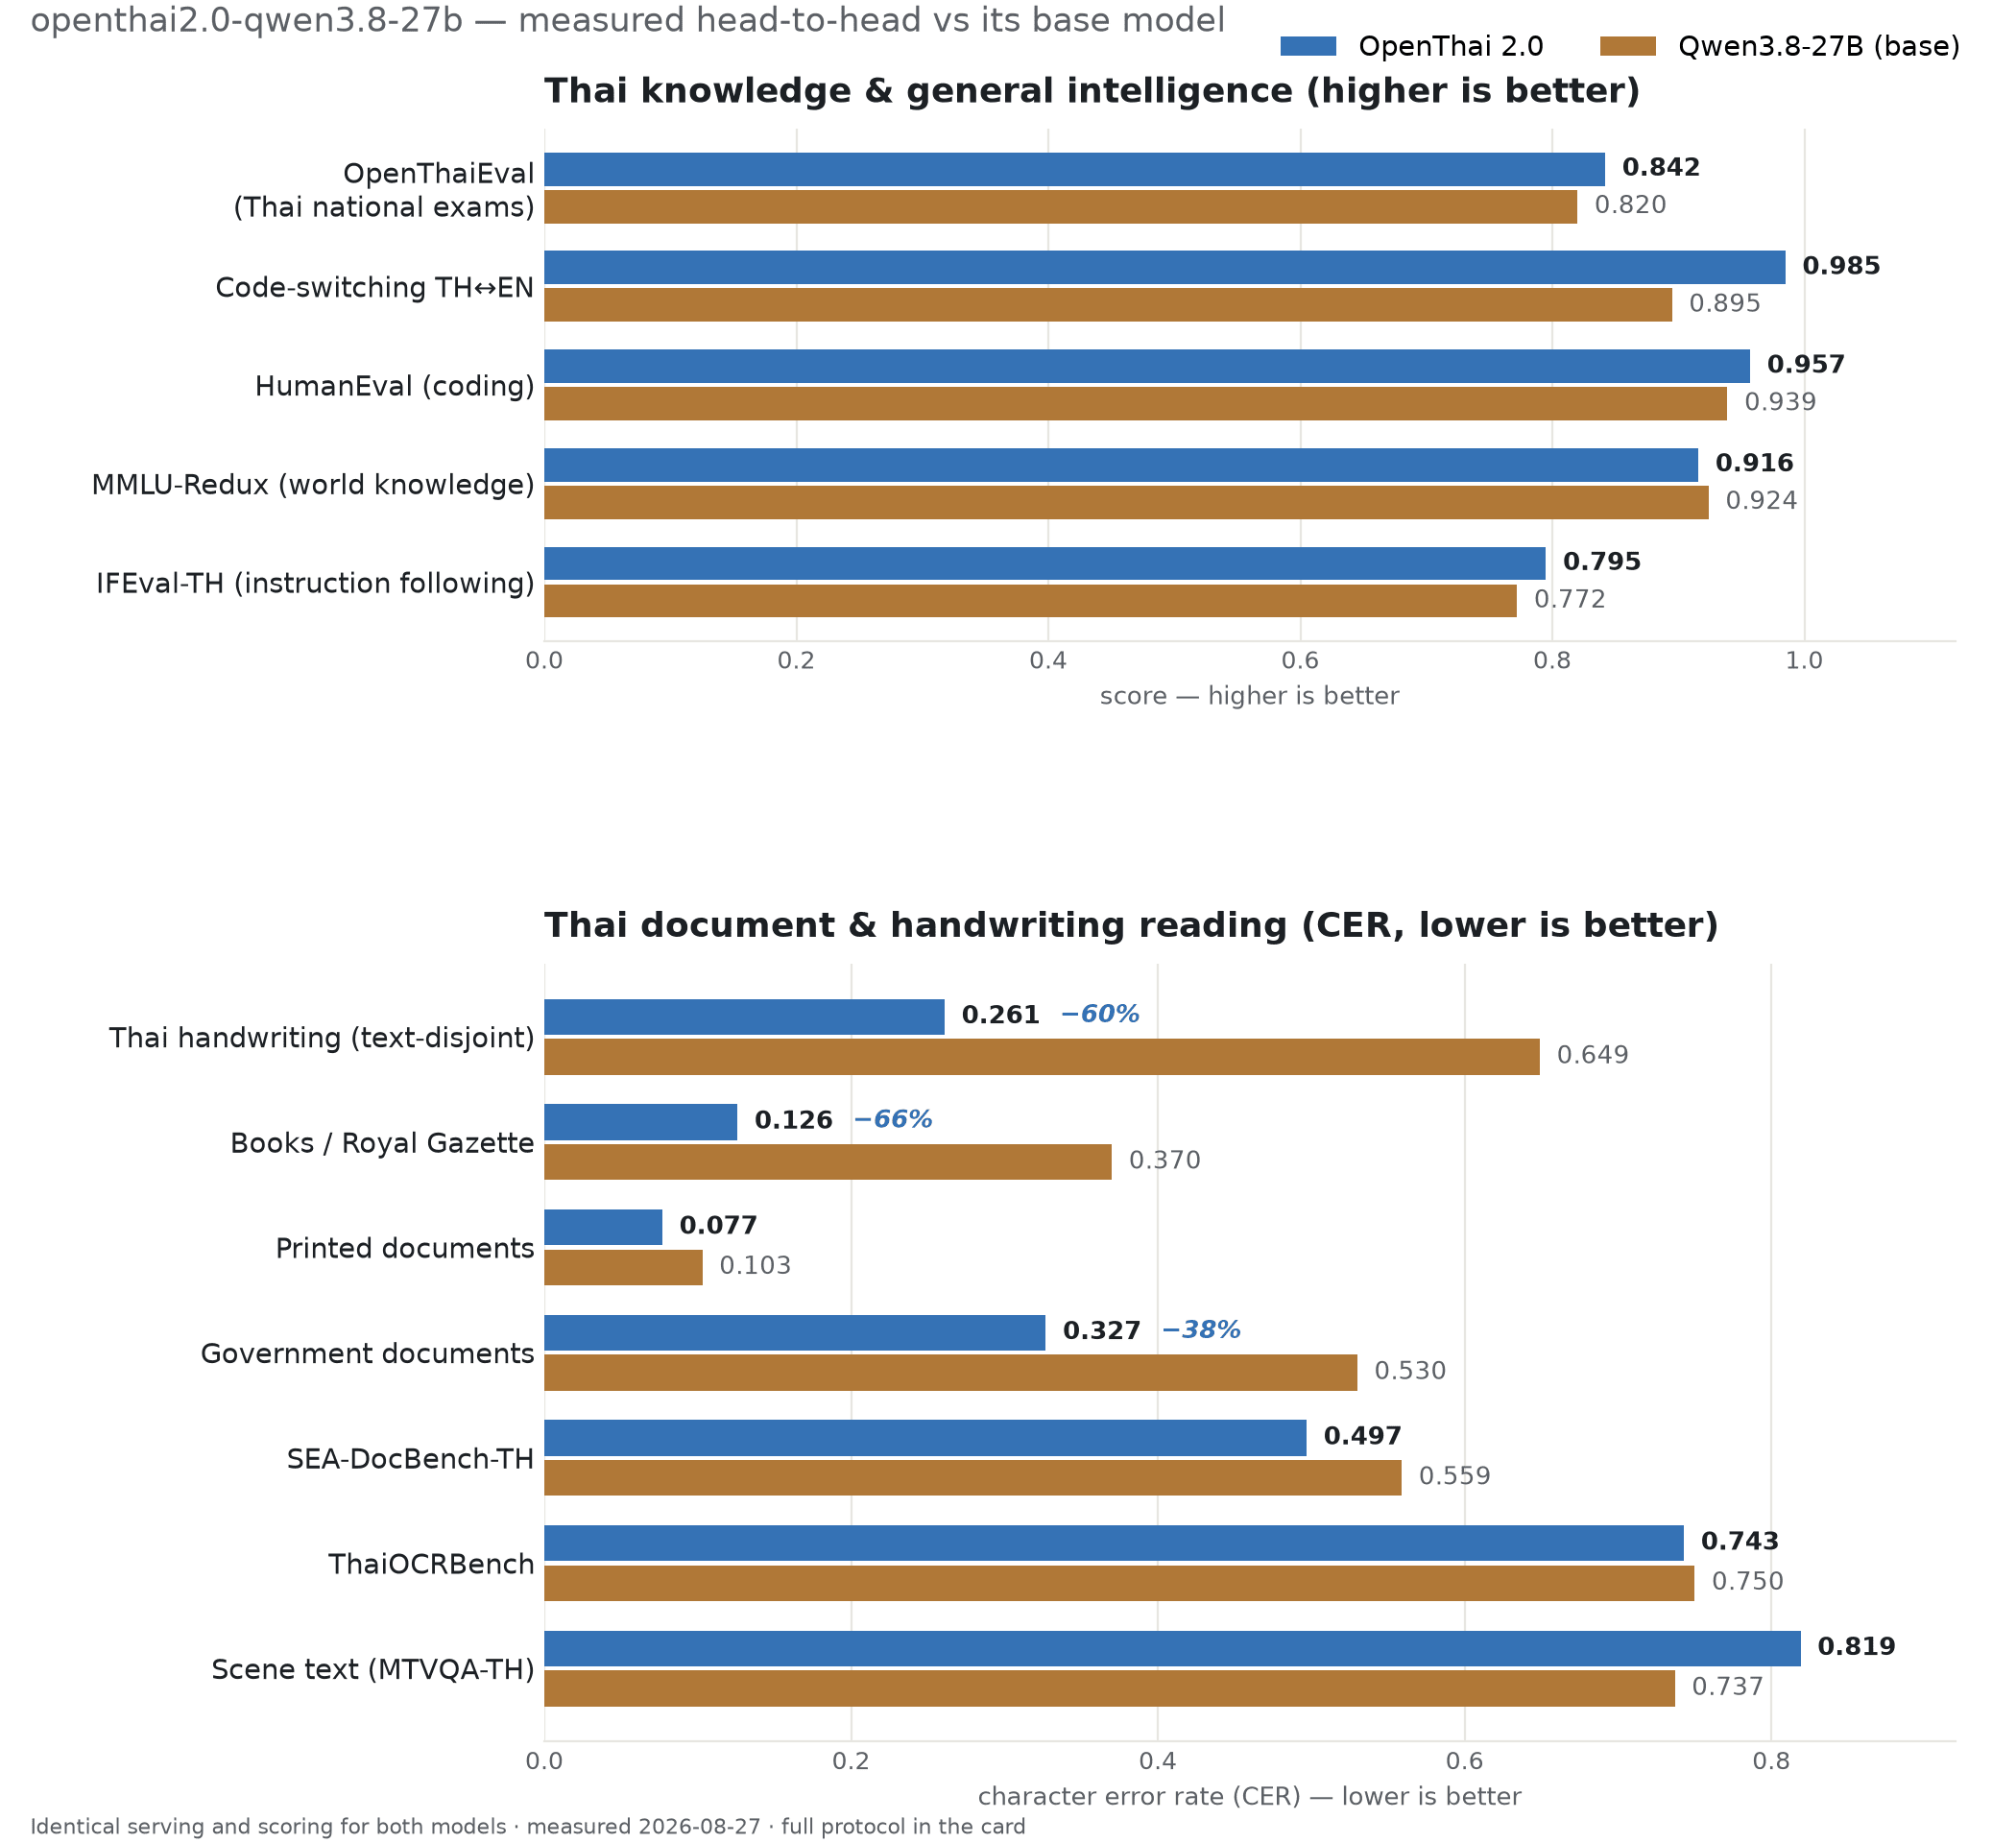
การอ่านลายมือไทย — อัตราความผิดพลาดระดับตัวอักษร (CER) ลดจาก 0.649 ของโมเดลฐานเหลือ 0.261 หรือผิดน้อยลง 60% ส่วนหนังสือและราชกิจจานุเบกษาอยู่ที่ 0.126 เทียบกับ 0.370 ของโมเดลฐาน (ลดลง 66%)
ความรู้ไทย — ทำได้ 0.842 บน OpenThaiEval ซึ่งเป็นชุดข้อสอบระดับชาติของไทย สูงกว่าโมเดลฐาน (0.820), Typhoon 2.5 (0.742) และ Pathumma (0.660) ส่วนการทำตามคำสั่งภาษาไทย (IFEval-TH) อยู่ที่ 0.795
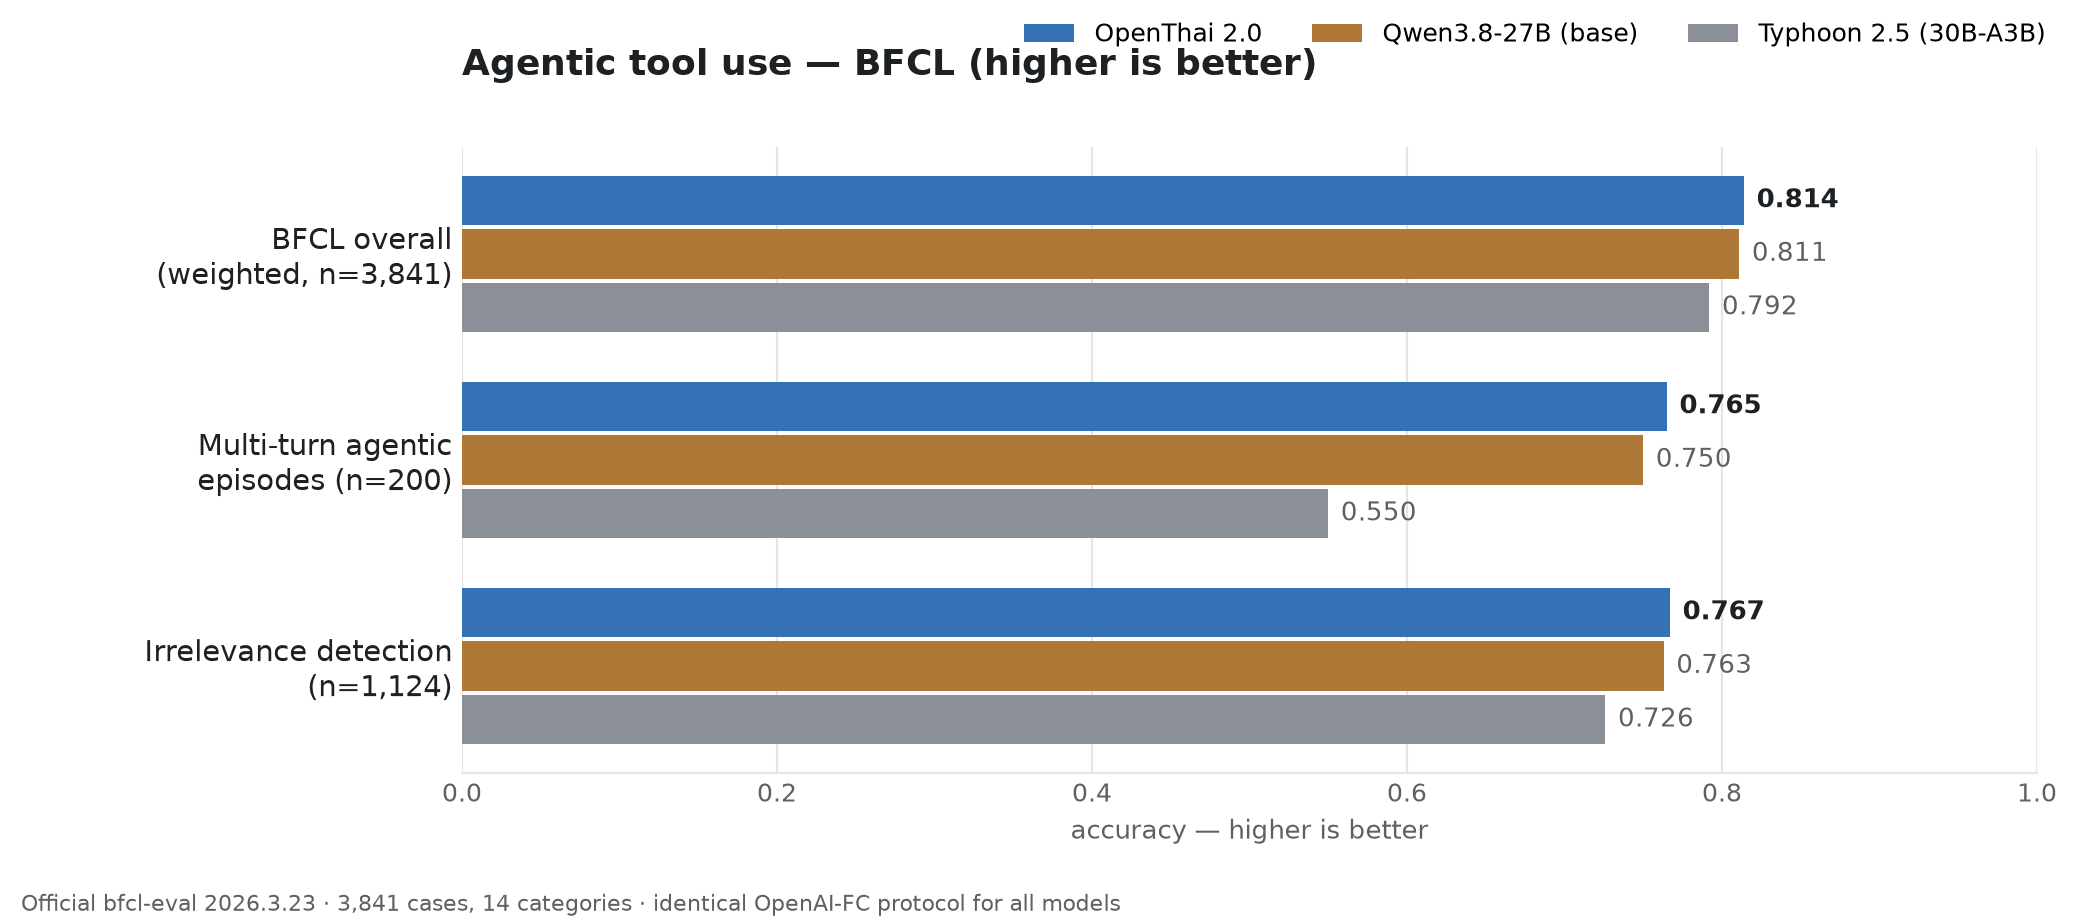
งานเอเจนต์ — 0.820 บน Berkeley Function-Calling Leaderboard นำโมเดลฐาน (0.811) และ Typhoon 2.5 (0.792) ช่องว่างกว้างที่สุดอยู่ที่งานเอเจนต์แบบหลายรอบสนทนา ซึ่งได้ 0.775 เทียบกับ 0.550 ของ Typhoon — ห่างกัน 22.5 จุด
ประเด็นที่เราให้ความสำคัญไม่แพ้กันคือ การจูนด้านเอกสารไทยไม่ได้ทำให้ความสามารถอื่นถดถอย โมเดลยังเขียนโค้ดได้ที่ 0.957 บน HumanEval และความรู้รอบตัวภาษาอังกฤษ (MMLU-Redux) อยู่ที่ 0.916 ใกล้เคียงโมเดลฐานที่ 0.924
สิ่งที่โมเดลนี้ยังทำได้ไม่ดี
เราอยากให้อ่านผลอย่างตรงไปตรงมามากกว่าจะเลือกเฉพาะตัวเลขที่สวย
Typhoon-OCR 1.5 ยังชนะเราในงานถอดความล้วน บนบรรทัดสิ่งพิมพ์สะอาดและลายมือแยกส่วน มันทำได้ดีกว่าทุกโมเดลในตารางรวมถึงของเรา แต่มันทำได้เพียงถอดความ — รับพรอมต์รูปแบบเดียว ตอบคำถามจากเอกสารไม่ได้ และไม่มีความสามารถด้านความรู้
ตัวอักษรในภาพถ่ายเป็นด้านที่อ่อนที่สุดของเรา ถ้างานของคุณคือป้ายหรือหน้าร้าน แนะนำให้ใช้โมเดลฐานหรือโมเดลเฉพาะทาง scene text
โมเดลตอบเชิงอธิบายโดยปริยาย การขอให้ตอบสั้นสำเร็จราว 40% เท่านั้น ถ้าต้องให้เครื่องอ่านผลลัพธ์ต่อ ควรสั่งรูปแบบให้ชัด เช่น "ตอบเป็น JSON เท่านั้น"
ลายมือยังเป็นงานยากจริง CER 0.261 แปลว่าตัวอักษรราวหนึ่งในสี่ยังผิดบนตัวอย่างยาก และโมเดลยังอาจแต่งข้อความขึ้นเองเมื่ออ่านต้นฉบับไม่ออก งานข้อเท็จจริงและงานที่มีกฎกำกับควรใช้คู่กับ RAG และการตรวจทานโดยมนุษย์เสมอ สำหรับงานกฎหมายโดยเฉพาะ เรามี OpenThai 2.0 Legal ที่ออกแบบมาเพื่องานนั้นโดยตรง
เริ่มใช้งาน
วิธีที่เร็วที่สุดคือ Ollama คำสั่งเดียวจบ:
ollama run openthai/openthai2.0-qwen3.8-27b
เรามีให้เลือก 5 ฟอร์แมต ตั้งแต่ MacBook จนถึงเซิร์ฟเวอร์ NVIDIA Blackwell — bf16, GGUF (17/29 GB), MLX 4-bit สำหรับ Apple silicon, INT8 W8A8 และ NVFP4 พร้อม LoRA adapter แยก (7 GB, rank 64) สำหรับใครที่อยากเสิร์ฟบนโมเดลฐานด้วย dynamic LoRA
เช็กพอยต์ยังมีหัวถอดรหัสแบบ multi-token prediction มาในตัว เปิด self-speculative decoding บน vLLM แล้ววัดได้ 75.2 โทเคน/วินาที เทียบกับ 50.1 เมื่อไม่ใช้ (เร็วขึ้น 50% วัดบน H100) โดยผลลัพธ์เหมือนเดิมทุกโทเคน เพราะโมเดลหลักตรวจสอบทุกโทเคนที่หัว draft เดาไว้
ถ้ายังไม่อยากรัน GPU เอง iApp โฮสต์ API แบบ OpenAI-compatible ให้ ใช้ฟรีถึง 30 กันยายน 2569 เพียงสมัคร API key ฟรี
ข้อควรรู้ก่อนเสิร์ฟเอง
อย่าตั้ง max_tokens ต่ำ — โมเดลคิดก่อนตอบ ถ้าจำกัดที่ 1,024 คำตอบจะกลับมาว่างราวหนึ่งในสาม และถ้าเสิร์ฟด้วย vLLM ต้องตั้ง --max-num-seqs 128 เพราะสถาปัตยกรรมไฮบริดจองบล็อกแคชสถานะหนึ่งบล็อกต่อหนึ่งลำดับถอดรหัส ค่าเริ่มต้นของ vLLM จะทำให้เอนจินสตาร์ตไม่ขึ้น
ใช้ enable_thinking: false เฉพาะคำขอถอดความที่แนบรูปเท่านั้น สำหรับข้อความล้วนให้เปิดโหมดคิดไว้เสมอ
ขอบคุณผู้สนับสนุน
การเทรนและการวัดผลโมเดลนี้ใช้ GPU NVIDIA H100 จำนวน 8 ใบ ซึ่งได้รับการสนับสนุนจาก บริษัท สยาม เอไอ คอร์เปอเรชั่น จำกัด ขอบคุณที่สนับสนุน AI ไทยแบบเปิดอย่างต่อเนื่อง
OpenThai 2.0 พัฒนาโดย iApp Technology เปิดตัวร่วมกับสมาคมผู้ประกอบการปัญญาประดิษฐ์ประเทศไทย (AIEAT) บนโมเดลฐาน Qwen/Qwen3.8-27B
อ่านต่อ: ประกาศเปิดตัวฉบับเต็มพร้อมตารางผลทดสอบทั้งหมด · ดาวน์โหลดบน Hugging Face · ทดลองใช้ฟรีในเบราว์เซอร์