
NVIDIA เขียนถึง OpenThai 2.0 Legal ในงาน AI Day Singapore
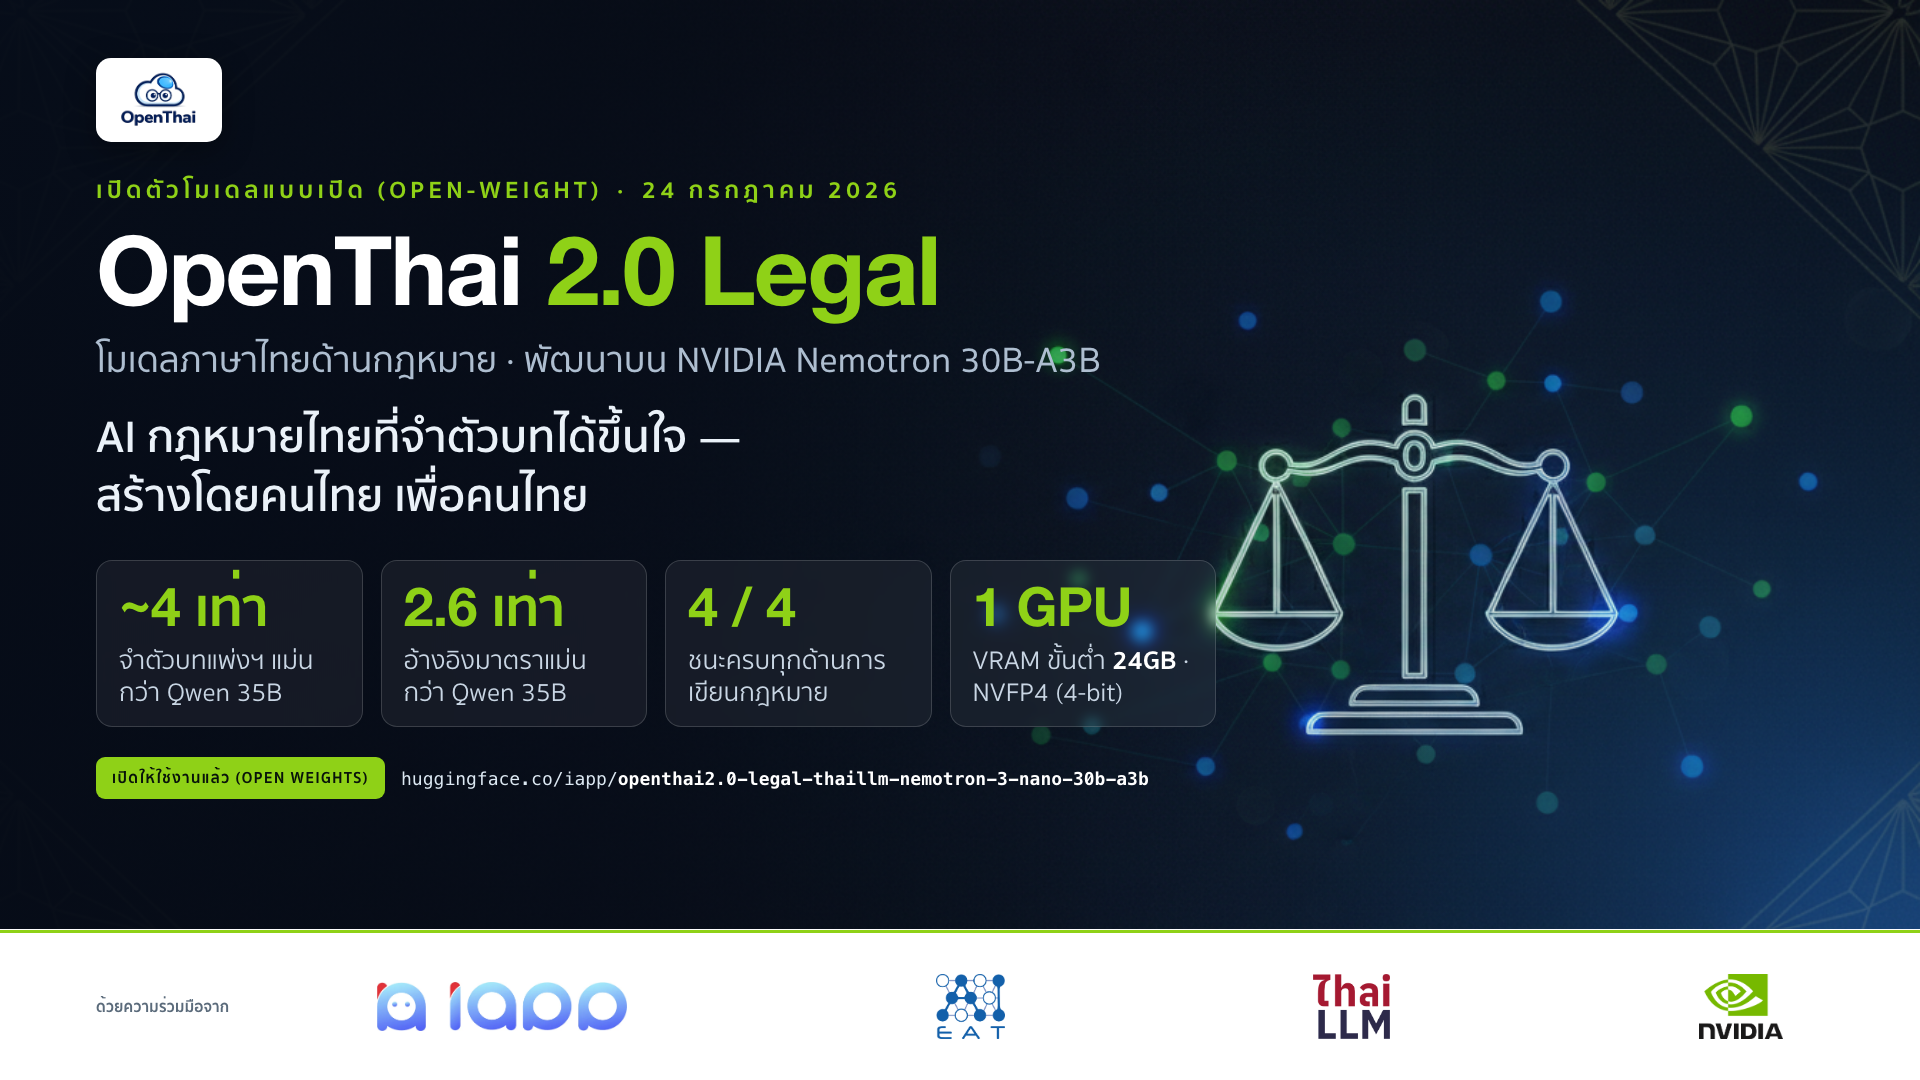
OpenThai 2.0 Legal — โมเดลกฎหมายไทยแบบเปิด

เมื่อวันที่ 23 กันยายน 2569 NVIDIA เผยแพร่บทความสรุปงาน AI Day Singapore บนบล็อกของบริษัท และในส่วนที่พูดถึงพันธมิตรทั่วเอเชียตะวันออกเฉียงใต้ที่สร้าง AI เฉพาะภูมิภาคบนโมเดลเปิด Nemotron มีชื่อของ OpenThai 2.0 Legal อยู่ในนั้น
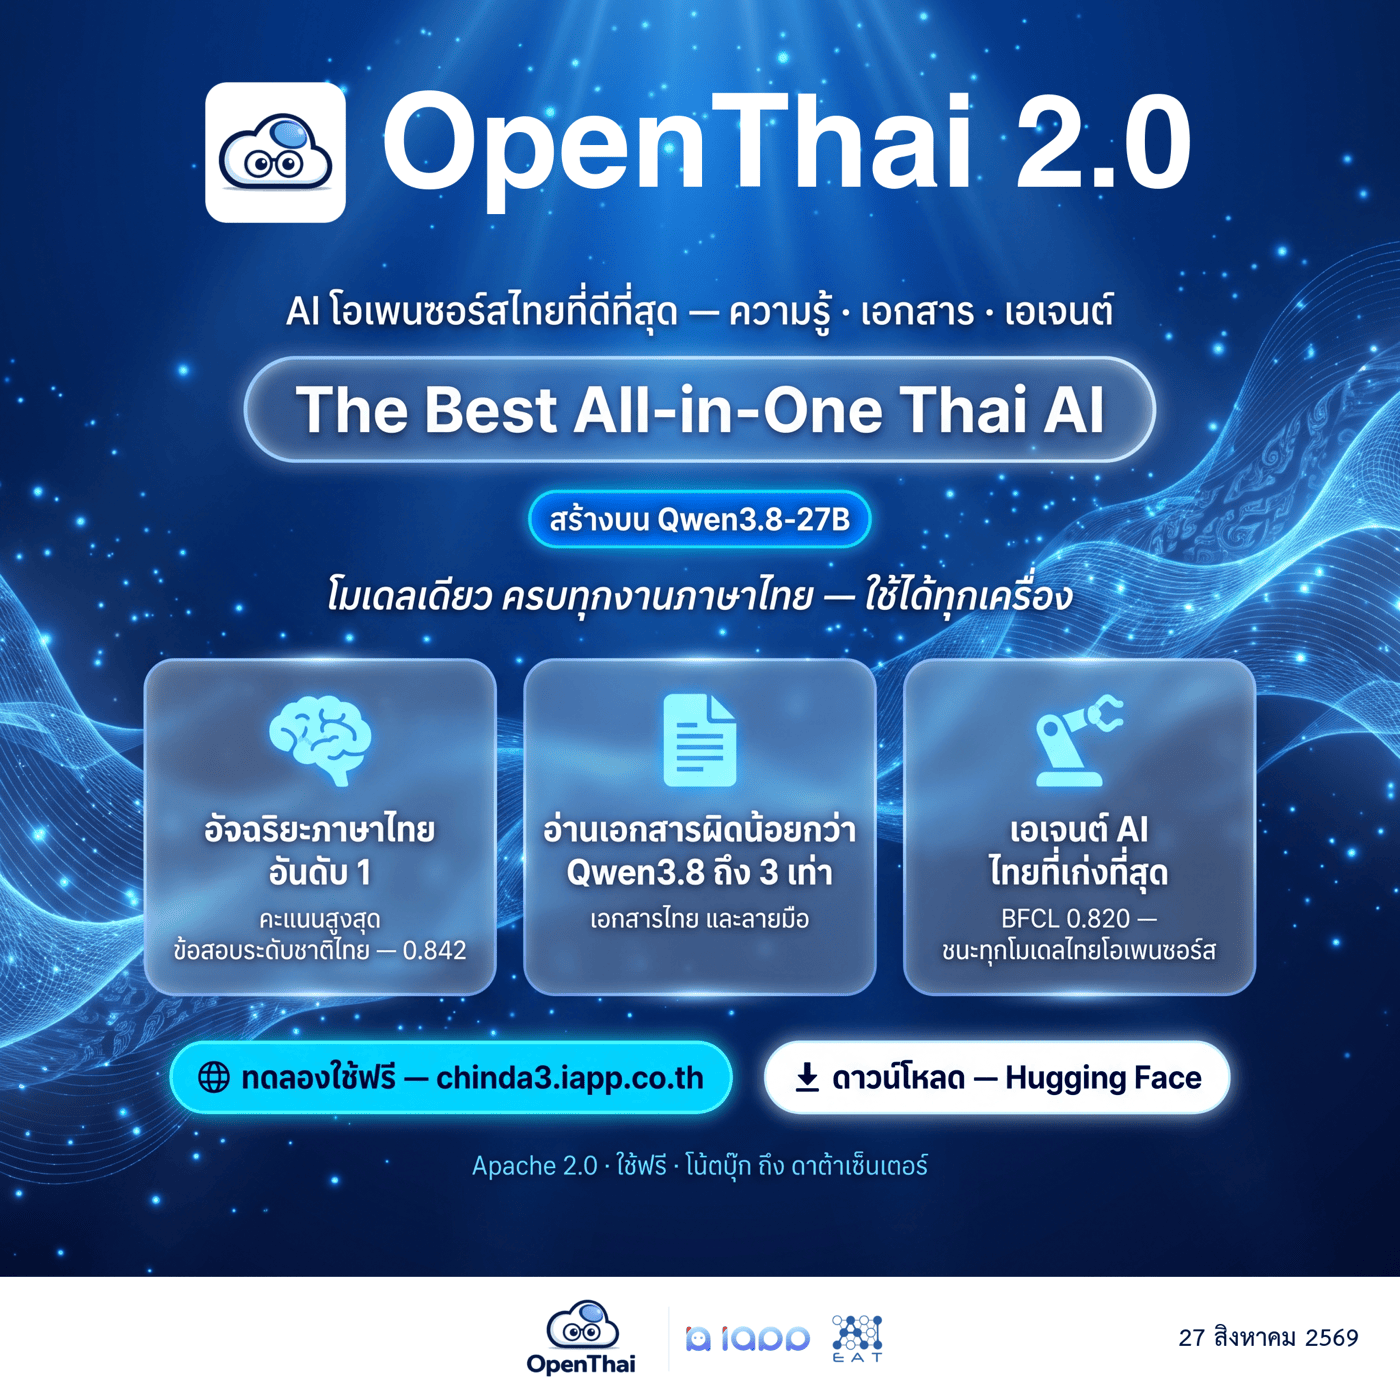
Jev ภาษาไทยมาแล้ว! โมเดล Opensource โดยทีม OpenThai ภายใต้ชื่อ OpenThai-SystemOne

อัปเดต 22 ก.ย. 2569: เวอร์ชัน 0.3 ออกแล้ว public benchmark 61.9 → 74.3 (ห่าง Nimble-9B แค่ 0.5 จุด) และ Wisesight 38.7 → 51.6 ตัวเลขล่าสุด เดโม Doom และตัวอย่างงานไทยอยู่ที่หน้าโมเดล บทความนี้คงตัวเลขวันเปิดตัวไว้ตามเดิม

Jev ภาษาไทยมาแล้ว! โมเดล Opensource โดยทีม OpenThai ภายใต้ชื่อ OpenThai-SystemOne

Jev ภาษาไทยมาแล้ว! โมเดล Opensource โดยทีม OpenThai ภายใต้ชื่อ OpenThai-SystemOne

5 วันหลัง TypeSafe เปิดตัว Jev ("System One model" ที่ไม่สร้างข้อความ แต่ตอบเป็นการตัดสินใจพร้อมความน่าจะเป็นในรอบเดียว) ทีม OpenThai ทำเวอร์ชันโอเพนซอร์สสำหรับภาษาไทย+อังกฤษออกมาแล้ว

OpenThai 2.0: โมเดลเปิดตัวเดียวที่อ่านเอกสารไทย รู้เรื่องไทย และทำงานเอเจนต์ได้

OpenThai 2.0 — AI โอเพนซอร์สไทย ความรู้ เอกสาร และเอเจนต์

วันนี้เราเปิดน้ำหนักโมเดล OpenThai 2.0 (openthai2.0-qwen3.8-27b) ขนาด 27B ภายใต้สัญญาอนุญาต Apache 2.0 ดาวน์โหลดได้ฟรีบน Hugging Face ใช้ได้ทั้งงานวิจัยและงานเชิงพาณิชย์

สิ่งที่ทำให้โมเดลนี้ต่างออกไปไม่ใช่ตัวเลขใดตัวเลขหนึ่ง แต่คือการที่มันทำสามอย่างได้ในน้ำหนักชุดเดียว — อ่านเอกสารและลายมือไทย ตอบคำถามความรู้ไทย และเรียกใช้เครื่องมือแบบเอเจนต์ — โดยไม่ต้องต่อ OCR แยก ไม่ต้องส่งงานข้ามระบบ

หมุดหมายสำคัญของ Sovereign AI ไทย: ชุมชน OpenThaiGPT เปิดตัว OpenThai 2.0 Legal เป็น Open Weights

OpenThai 2.0 Legal — โมเดลภาษาไทยด้านกฎหมายแบบเปิด

ข่าวประชาสัมพันธ์

กรุงเทพฯ, 26 สิงหาคม 2569 — สมาคมผู้ประกอบการปัญญาประดิษฐ์ประเทศไทย (AIEAT) ในฐานะผู้ประสานชุมชนโมเดลเปิด OpenThaiGPT ขอแสดงความยินดีกับการเปิดตัว OpenThai 2.0 Legal โมเดลภาษาขนาดใหญ่ด้านกฎหมายไทย ซึ่งเผยแพร่เป็น open weights บน Hugging Face แล้ววันนี้